


人们常说,类似于OpenAI的ChatGPT这样的大型语言模型(LLM)是一个黑箱,这确实不无道理。即便是数据科学家,也难以始终明白模型为何会以某种方式做出回应,例如凭空捏造事实。
为了揭开大型语言模型的神秘面纱,OpenAI正在开发一种工具,以自动识别LLM中哪些部分负责哪些行为。其背后的工程师强调该工具尚处于早期阶段,但自今晨起,运行该工具的代码已在GitHub上开源。
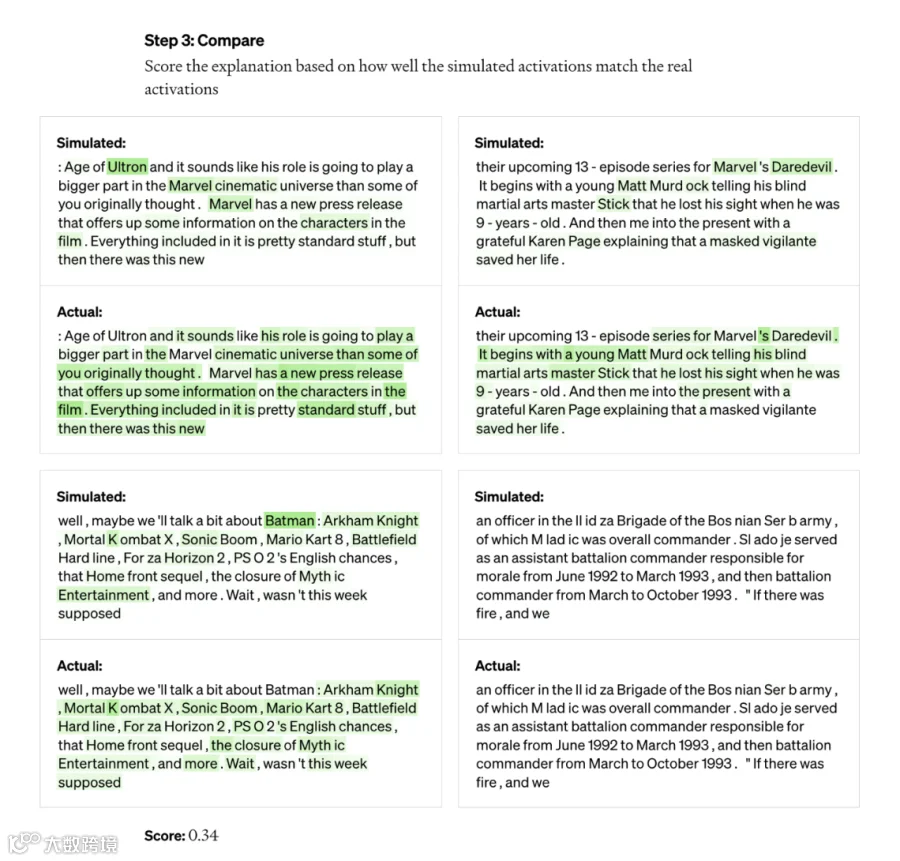
工作原理:用AI解析AI
OpenAI的工具使用了一个语言模型(颇具讽刺意味)来解析其他架构更简单的LLM组件的功能——具体而言是OpenAI自家的GPT-2。与大脑类似,LLM由“神经元”组成,这些神经元会观察文本中的特定模式,从而影响整个模型接下来“说”什么。例如,给定一个关于超级英雄的问题提示,一个“漫威超级英雄神经元”可能会提高模型命名漫威电影中特定超级英雄的概率。
OpenAI的工具利用这种设置将模型分解为各个独立部分。首先,该工具将文本序列输入待评估的模型,并等待特定神经元“频繁激活”的情况出现。接着,它向GPT-4展示这些高度活跃的神经元,并要求GPT-4生成解释。为了判断解释的准确性,该工具向GPT-4提供文本序列,要求其预测或模拟该神经元的行为,然后将模拟行为与实际行为进行比较。
Jeff Wu表示:“通过这种方法论,我们基本上可以为每个神经元提供某种初步的自然语言解释,说明它在做什么,并给出该解释与实际行为匹配程度的评分。”Jeff Wu是OpenAI可扩展对齐团队的负责人。“我们在过程中使用GPT-4来生成对神经元所关注内容的解释,然后评估这些解释与其实际行为的匹配程度。”
研究人员能够为GPT-2中的所有307,200个神经元生成解释,并将这些解释整理成一个数据集,随工具代码一同发布。
局限性与未来展望
研究人员表示,这类工具未来可能被用于提升LLM的性能——例如减少偏见或毒性。但他们也承认,该工具距离真正实用还有很长的路要走。目前,该工具仅对其中的约1,000个神经元的解释具有较高置信度,占总数的比例很小。
尽管有观点认为该工具依赖GPT-4本质上是一种广告,但Wu否认了这一说法。他表示,使用GPT-4只是“偶然”,这反而暴露了GPT-4在该领域的弱点。该工具并非为商业应用而设计,理论上也可以适配除GPT-4之外的其他LLM。
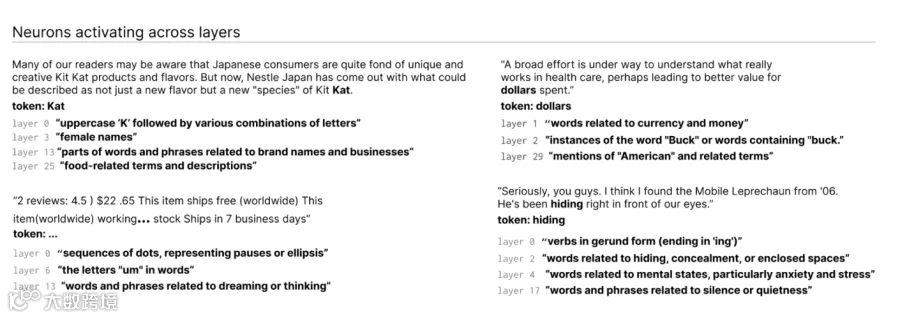
Wu指出:“大多数解释的评分相当低,或者未能充分解释实际神经元的许多行为。”例如,许多神经元的激活方式非常难以判断其内在机制——它们可能对五到六种不同的事物产生反应,但没有任何可辨识的模式。有时存在可辨识的模式,但GPT-4无法发现它。
对于更复杂、更新且规模更大的模型,或是能够浏览网页获取信息的模型,Wu认为网页浏览不会大幅改变该工具的底层机制。只需稍作调整,即可弄清楚神经元为何决定发起特定的搜索引擎查询或访问特定网站。
“我们希望这将为以自动化方式解决可解释性问题开辟一条充满前景的途径,使他人能够在此基础上进行构建和贡献,”Wu表示,“我们的期望是,我们不仅能对神经元响应什么提供良好解释,还能对整个模型的行为——包括它们正在计算的各种电路,以及某些神经元如何影响其他神经元——提供充分的解释。”