


人工智能,特别是生成式AI,有望彻底变革医疗保健行业。
Hippocratic AI今日结束保密状态,宣布完成5000万美元种子轮融资,估值达数亿美元。本轮由General Catalyst与Andreessen Horowitz联合领投,彰显业界对其医疗专用文本生成模型的高度认可。
创始团队与使命
Hippocratic脱胎于General Catalyst,由约翰霍普金斯大学、斯坦福大学、谷歌及英伟达等机构的医生、医院管理者、医保专家与AI研究员联合创立。联合创始人兼CEO Munjal Shah在2010年将购物比价网站Like.com出售给谷歌后,耗时近十年打造该项目。
Shah表示:“Hippocratic创建了首个专为医疗设计的安全型大语言模型(LLM)。我们的使命是开发最安全的通用AI健康智能,大幅改善医疗可及性与健康结果。”
聚焦安全而非诊断
AI在医疗领域的应用历来争议不断:Babylon Health因夸大诊断能力屡遭审查;IBM Watson Health因技术问题亏损出售;OpenAI GPT-3甚至曾间接导致用户自杀。
对此,Shah强调Hippocratic不专注于诊断,而是面向消费者提供以下服务:
- 解释福利与账单
- 提供饮食建议与用药提醒
- 回答术前问题
- 患者入职引导
- 传达“阴性”检测结果等安抚性信息
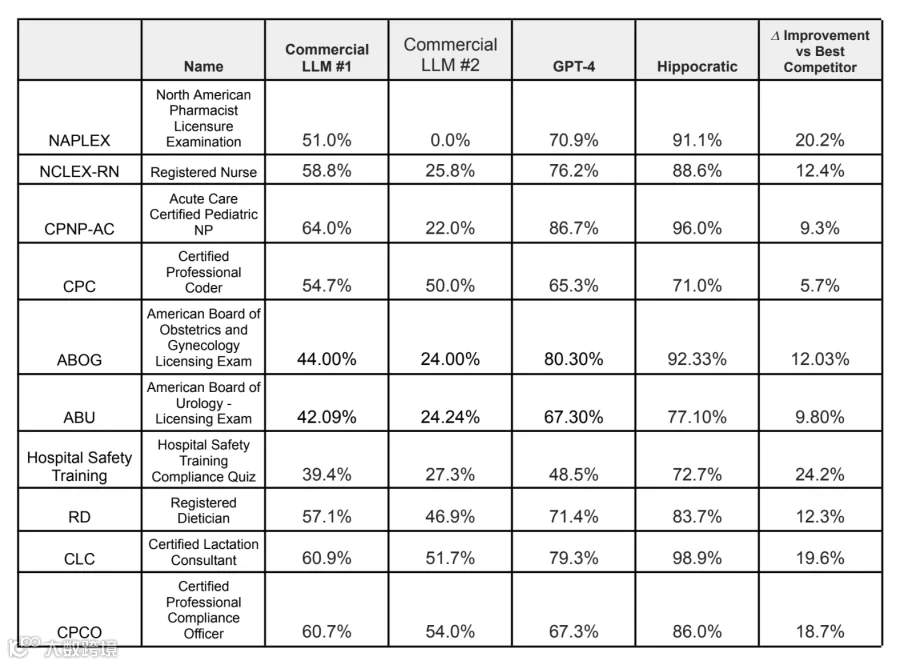
尽管AI饮食建议曾引发担忧,但Shah指出,Hippocratic的模型在护理NCLEX-RN、美国泌尿外科学会考试及注册营养师考试等100多项医疗认证中,表现优于GPT-4和Claude。
“语言模型必须安全。我们正构建专注安全的模型,经医疗专业人士认证,并与行业紧密合作,确保数据保留与隐私政策符合医疗规范。”Shah说。
内置“人性化关怀”能力
Shah认为,Hippocratic通过更好“检测语气”与“表达同理心”,内置了良好的bedside manner(床边关怀)。这种即使在严峻情况下也能给予患者希望的互动,确实能影响健康结果。
为此,公司设计了评估基准,检验模型是否展现同理心、对患者生活表现出个人兴趣等人道主义迹象。测试显示,Hippocratic模型在所有类别中得分最高,包括超越GPT-4。(注:单一测试能否准确捕捉此类细微主题仍存争议。)
能否替代医疗工作者?
Hippocratic辩称,其模型在医疗专业人员监督下训练,具备极高能力。“只有当现实中从事该角色的人员确认模型就绪后,我们才会发布对应功能——如营养师、计费代理、遗传咨询师等。”
Shah指出,疫情期间多数医疗系统劳动力成本上涨30%而收入未增,财务压力巨大。语言模型可通过高性价比方式填补职位空缺,帮助降低成本。
然而,部分从业者或持保留意见。据Hippocratic披露,其模型在专业编码员考试中得分为71%,在医院安全培训合规测验中为72.7%。
偏见与自动化风险
偏见问题不容忽视。2019年研究发现,许多医院用于分配护理资源的算法对黑人患者敏感度低于白人患者。若训练数据本身存在偏差,模型将继承并放大这些问题。
更需警惕的是“自动化偏见”——人们倾向于信任AI输出,即使其他来源更准确。在医疗领域,此类风险后果严重。因此,Hippocratic应明确声明模型并非无误。
透明度不足与竞争压力
目前,Hippocratic尚未公开合作伙伴或客户详情,也未透露训练数据来源(仅称使用“去标识化”数据),模型亦未正式上线。
若推进过慢,可能落后于Truveta、Latent及Google Med-PaLM 2等对手。后者已宣称在数十项医学考试中达到专家级水平,并由医疗专业人员评估其安全性与准确性。
但投资方General Catalyst管理合伙人Hemant Taneja表示:“我们坚信医疗需要一款公平、无偏、安全且有益的专用语言模型。我们致力于高诚信度AI应用,采用融入大量专家反馈的训练方法。在医疗领域,绝不能承受‘快速行动,打破常规’的风险。”
Shah透露,本轮5000万美元融资将主要用于人才招募、计算资源、数据积累及生态合作。