


前Uber科学家创立LlamaIndex,获850万美元融资助力大模型连接私有数据
去年秋天,前Uber研究科学家Jerry Liu在使用OpenAI的GPT-3文本生成AI模型(GPT-4前身)时,发现其在处理个人文件等私有数据方面存在局限。为解决这一问题,他启动了开源项目LlamaIndex,旨在释放大语言模型(LLMs)的能力与应用场景。
“大语言模型在知识提取和推理方面能力惊人——能执行问答、摘要、洞察提取,甚至与外部环境进行序列决策,”Liu表示,“但同时也存在局限。”随着该项目月下载量达20万次,Liu与前同事Simon Suo联手将其打造为成熟公司。如今,LlamaIndex提供了一套框架,帮助开发者基于个人或组织数据利用大模型能力。
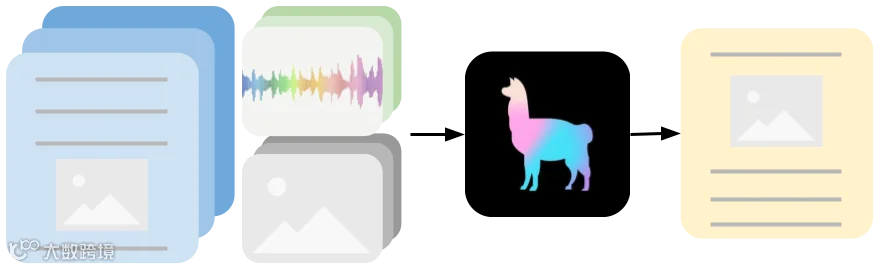
核心功能:无缝连接多源数据与大模型
LlamaIndex允许开发者将PDF、PowerPoint等文件,Notion、Slack等应用,以及Postgres、MongoDB等数据库中的数据接入大语言模型。该框架包含用于摄取各类数据源和格式的连接器,并提供数据结构化方法,以便与大模型高效配合。
此外,LlamaIndex具备数据检索和查询接口,支持开发者输入任意提示词,获得“上下文和知识增强型”输出。Liu强调:“市面上虽有提供基础模块的大模型应用框架,但LlamaIndex的独特之处在于专注连接数据源与大模型,并在数据摄取、管理、索引及检索方面提供了丰富工具。”
融资850万美元,布局企业级解决方案
这一增强大模型的前景吸引了投资者关注。LlamaIndex近期完成850万美元种子轮融资,由Greylock领投,Jack Altman、Lenny Rachitsky和Charles Xie等天使投资人参投。
Liu透露,资金将用于在开源项目基础上构建“企业级解决方案”,预计今年晚些时候推出。新功能包括支持解析传输海量数据的“企业级”数据连接器,以及针对“领域特定”数据的索引能力。“LlamaIndex不绑定特定技术栈,可随AI行业快速演进持续适配大模型,”他表示,“初期技术很可能在未来几个月内发生变化。”