


瑞士联邦理工学院(EPFL)新论文指出,亚马逊机械 Turk 平台中 33% 至 46% 的众包工人在执行任务时疑似使用 ChatGPT 等工具“作弊”。若此现象普遍化,将引发严重问题。
亚马逊机械 Turk 长期作为开发者获取人工服务的 API 接口,主要用于处理计算机难以胜任或对人类团队而言过于庞大的模糊任务,例如为计算机视觉模型绘制高质量数据集边界框。
数据科学家通常依据数据来源(人类生成或大语言模型生成)采取不同处理策略。然而,随着 AI 成本降低,部分产品经理仍依赖人工以获取优于机器的产出。一旦该数据源被污染,后果不堪设想。
研究人员表示:“区分 LLM 生成文本与人类文本对机器和人类均具挑战。”为此,团队开发了一种识别文本内容来源的方法。
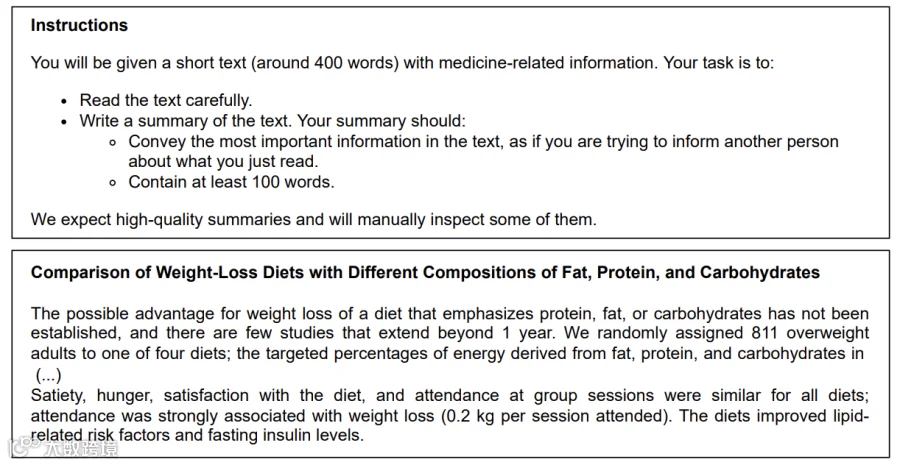
测试要求众包工人将《新英格兰医学杂志》研究摘要浓缩为 100 字——这恰是 ChatGPT 等生成式 AI 的强项。
合理场景下,若需用人类大型数据集测试自研大模型,却收到未知来源及质量的 LLM 生成数据,训练将极为困难。用机器生成文本训练 AI 易放大偏见并“确认”虚假数据,堪称灾难配方。
研究人员认为,利用 LLM 进行众包会严重削弱数据实用性:数据不再符合人类产出的黄金标准;且直接提示 LLM 可能比支付众包费用更低廉,而工人往往不会披露此举。
从现实角度看,最低工资的数据录入工人为高效完成枯燥重复任务,自然会利用现有工具。正如论文作者所言:“众包工人有经济动力使用大语言模型以提高生产力和收入。”
一方面,工人善用工具提升效率并不罕见,如同在 Dvorak 键盘上打字更快一样无可厚非。
另一方面,该研究揭示了机器学习训练数据集面临的严峻挑战。“垃圾进,垃圾出”的计算格言依然适用:若无法信任训练数据,便无法信任输出结果。