


过去两年,AI图像生成器已随技术普及和门槛降低实现商品化。Google、Microsoft等科技巨头及众多初创公司纷纷入局,争夺生成式AI市场红利。
但这并不意味着各工具性能趋同。尽管图像生成质量有所提升,但进步往往是渐进甚至缓慢的。
不过,Meta宣称取得了突破。
CM3Leon:文本到图像生成的新标杆
Meta今日发布CM3Leon(意为“变色龙”),称其在文本到图像生成方面达到SOTA(最先进)水平。其独特之处在于能同时生成图像及其说明文字,为未来更强的图像理解模型奠定基础。
Meta在官方博客中表示:“CM3Leon能生成更连贯的图像,并更好地遵循提示词。”“我们认为这是迈向高保真度图像生成与理解的重要一步。”
Transformer架构 vs 扩散模型
DALL-E 2、Imagen和Stable Diffusion等主流工具依赖扩散模型,即从噪声中逐步去噪以逼近目标。虽然效果出色,但计算密集、成本高且速度慢,难以满足实时应用需求。
相比之下,CM3Leon采用Transformer架构,利用“注意力”机制权衡输入数据相关性。该架构训练更快、更易并行化,且CM3Leon比多数同类模型更高效——Meta称其计算量减少五倍,所需训练数据集也更小。
值得注意的是,OpenAI曾尝试用Transformer生成图像(Image GPT),后转向扩散模型,未来可能探索“一致性”路径。
70亿参数与监督微调
CM3Leon使用Shutterstock数百万张授权图像训练,最强版本含70亿参数,是DALL-E 2的两倍以上。
性能提升的关键在于监督微调(SFT)。该技术曾助力ChatGPT等文本模型,Meta将其应用于图像领域,不仅提升了生成质量,还增强了图像描述、问答及指令编辑能力(如“将天空改为亮蓝色”)。
复杂提示词处理能力突出
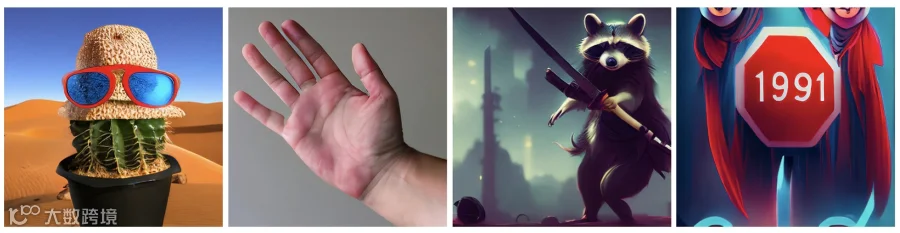
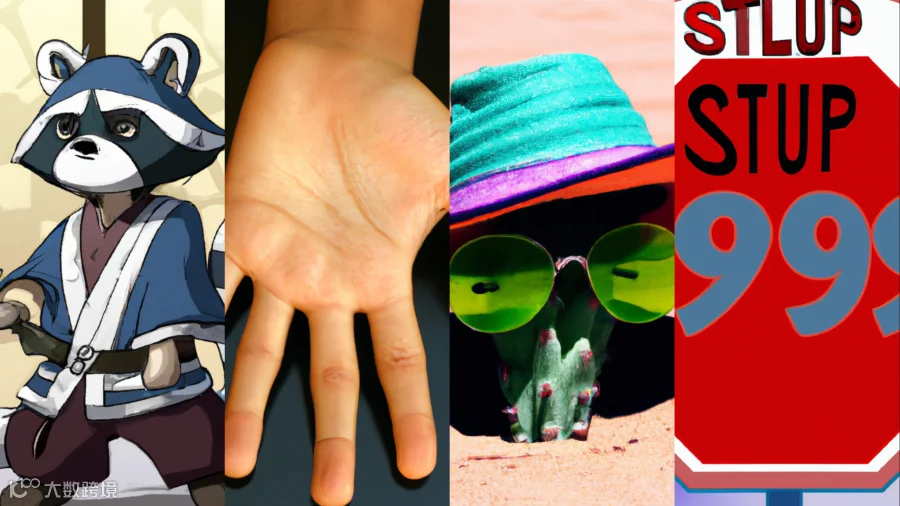
多数生成器在处理复杂对象或多约束提示时表现不佳,CM3Leon则不然。Meta展示了多个案例,如“撒哈拉沙漠戴草帽和霓虹太阳镜的小仙人掌”、“人类手部特写”、“持武士刀的动漫浣熊”及“带‘1991’字样的奇幻停车标志”。
对比测试显示,相同提示下CM3Leon生成的图像更贴合描述、细节更丰富,尤其在文字渲染和人体结构方面优于DALL-E 2。
精准理解图像编辑指令
CM3Leon可准确执行复合指令。例如,“生成一个有洗手池和镜子的房间,并在(199,130)位置放一瓶水”,它能生成语境恰当、元素完整的图像;而DALL-E 2常忽略指定物体或误解细微要求。
此外,CM3Leon还能根据提示生成描述性文字并回答图像相关问题。Meta称其表现优于Flamingo等专用图像描述模型,尽管所用文本数据更少。
偏见问题与开源前景
针对生成式AI可能强化社会偏见的问题(如权威职位默认描绘白人男性),Meta未直接回应,仅承认CM3Leon“可能反映训练数据中的偏见”。公司强调透明度是推动行业进步的关键。
目前,Meta尚未公布CM3Leon的发布计划或时间表。鉴于开源艺术生成器争议不断,短期内开放可能性较低。