


随着疫情加速医疗行业拥抱人工智能,Optum 2020年调查显示,80%的医疗机构已制定AI战略,15%计划推出。供应商积极满足需求:谷歌推出医学问答模型Med-PaLM 2;Hippocratic、OpenEvidence等初创公司开发临床辅助模型。
然而,医疗AI模型表现评估面临挑战。因训练数据多来自有限临床环境,部分模型对少数族裔存在偏见,导致现实应用中的有害影响。
MedPerf平台:隐私保护下的联邦评估
为建立可靠评估体系,MLCommons推出MedPerf测试平台,可在保护患者隐私前提下,利用多样化真实世界数据评估AI模型。其联合主席Alex Karargyris表示,中立科学的基准测试有助于提升有效性、减少偏见、建立信任并支持合规。
MedPerf是两年合作成果,获超20家公司及学术机构反馈,成员包括Google、Amazon、IBM、Intel及Brigham and Women’s Hospital、斯坦福大学、MIT等。与通用基准测试不同,MedPerf面向医疗机构,采用“联邦评估”模式远程部署、本地验证,支持私有模型、API模型(如Epic、Azure OpenAI)及主流机器学习库。
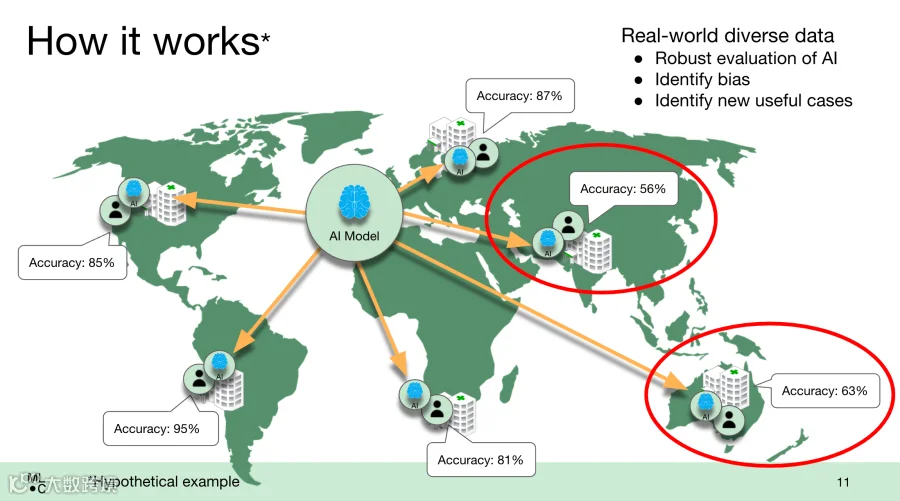
在NIH资助的FeTS挑战赛(胶质母细胞瘤术后治疗评估)中,MedPerf测试了41种模型,覆盖六大洲32个站点。结果显示,所有模型在与训练数据人口特征不同的站点上性能下降,证实了偏见存在。
Dana-Farber癌症研究所Renato Umeton指出,试点研究在医院系统内运行,遵循统一数据标准且无需共享数据,印证了联邦评估是推动包容性医疗AI的正确方向。
局限与挑战:基准测试并非万能
MLCommons将MedPerf视为加速医疗AI发展的基础步骤,目前主要用于放射影像分析模型评估,并呼吁研究人员和医疗机构参与以增强测试稳健性。
但需理性看待其作用。杜克大学报告指出,AI营销与实际落地存在巨大差距,难点在于融入医护日常工作流及复杂护理系统。2020年谷歌糖尿病视网膜病变筛查工具未达预期,原因涉及设备部署、网络条件及患者接受度等非模型因素。
Yahoo Finance调查显示,55%从业者认为医疗AI尚未就绪,仅26%表示信任。尽管模型偏见确有问题(如Epic脓毒症识别系统漏诊误报频发),且中小组织获取多样化测试数据困难,但对MedPerf寄予过高期望并不明智。
基准测试仅揭示部分真相。安全部署医疗AI仍需供应商、客户及研究人员进行持续彻底的审计,缺乏此类测试是不负责任的行为。