


Arthur是一家机器学习监控初创公司,受益于今年对生成式人工智能的关注,一直在开发帮助公司更有效地使用大型语言模型的工具。今天,它发布了Arthur Bench,这是一款开源工具,旨在帮助用户为特定数据集找到最佳的大型语言模型。
Arthur的首席执行官兼联合创始人Adam Wenchel表示,该公司在生成式AI和大语言模型(LLM)方面受到了广泛关注,因此他们投入了大量精力来开发相关产品。
他表示,尽管ChatGPT发布至今还不到一年,但企业目前仍缺乏一种系统化的方法来衡量不同工具之间的有效性,这也是他们推出Arthur Bench的原因。
Wenchel告诉TechCrunch:“Arthur Bench解决了一个我们与客户沟通时经常听到的关键问题:在众多模型选择中,哪一款最适合您的特定应用场景。”
它提供了一套工具,您可以用来系统地测试性能,但其真正价值在于,它能够让您测试并衡量用户为您的特定应用所使用的各类提示词在不同大语言模型上的表现。
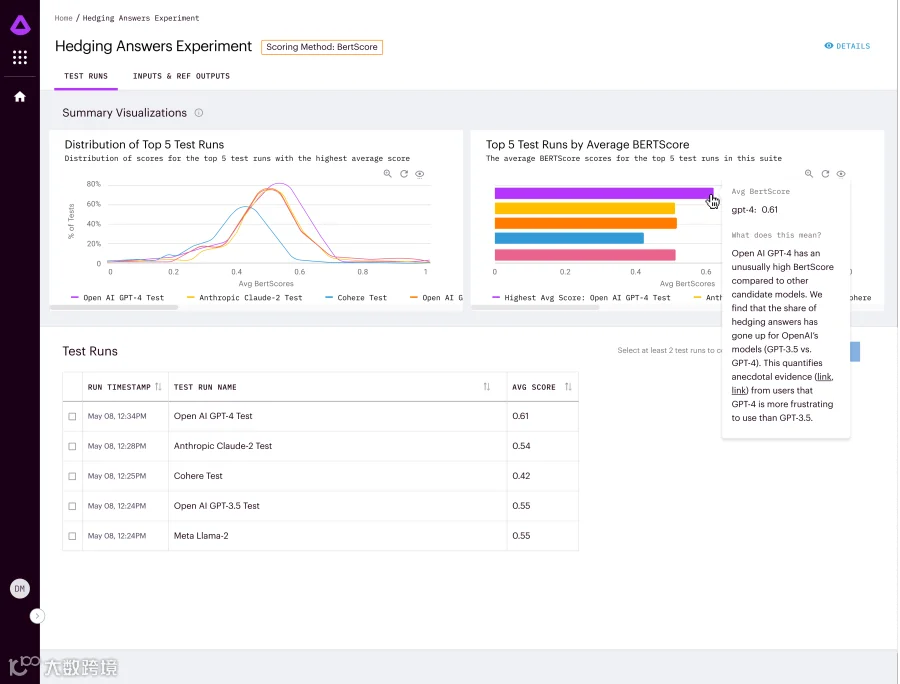
Wenchel说:“您甚至可以测试100种不同的提示词,然后观察两种不同的大语言模型——例如Anthropic与OpenAI的对比——在您用户可能使用的提示词类型下的表现。”此外,他表示,您还可以大规模地进行此类测试,从而更明智地决定哪种模型最适合您的具体用例。
Arthur Bench今天作为开源工具正式发布。同时,还将推出一款SaaS版本,供那些不愿处理开源版本管理复杂性、或有更大测试需求且愿意为此付费的客户使用。但目前,Wenchel表示他们正专注于开源项目。
这款新工具紧随5月发布的Arthur Shield之后推出,这是一种类似大型语言模型防火墙的产品,旨在检测模型中的幻觉,同时防止有毒信息和私人数据泄露。