


像 GPT-4 和 Claude 这类语言模型虽功能强大,但其训练数据往往被严密保密。人工智能研究所(AI2)正通过推出全新大型文本数据集 Dolma 来改变这一现状,该数据集不仅免费开放,还接受公众审查。
Dolma 是 AI2 计划中开源语言模型 OLMo 的基础(Dolma 意为“为 OLMo 的胃口提供数据”)。既然 OLMo 旨在供 AI 研究社区免费使用和修改,研究人员认为其训练数据集也应遵循同样的开放原则。
📊 数据来源与处理流程公开透明
作为首个与 OLMo 相关的“数据制品”,AI2 在博客文章中详细阐述了来源选择及数据处理流程背后的考量。尽管 OpenAI 和 Meta 等公司仅披露部分关键统计数据,大量信息仍被视为专有内容。这种封闭做法引发了外界对数据获取伦理及合法性的质疑,例如盗版书籍被用于训练等问题。
数千名作者签署信件,敦促 AI 制造商停止窃取书籍
如下图所示,现有最大且最新的模型仅提供有限的数据集信息。哪些信息被删除?如何界定文本质量?个人信息是否已妥善剔除?这些关键问题往往缺乏透明度。
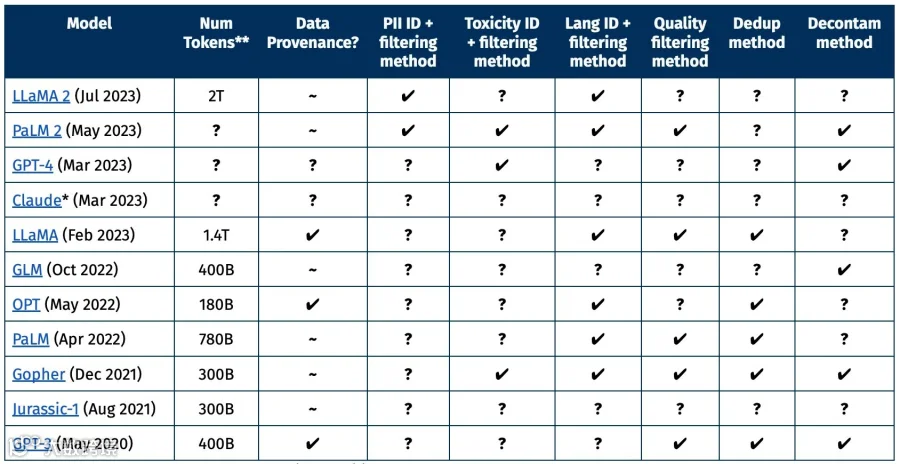
虽然企业有权保护商业机密,但这使得外部研究人员难以复现或深入研究。相比之下,Dolma 将所有来源和处理过程——包括原始英文文本的精简方式——都进行了公开记录。
AI2 正在开发一款针对科学优化的大型语言模型
📜 许可证要求与使用规范
Dolma 并非首个开放数据集项目,但它是目前规模最大的(30亿 token),且在使用和许可方面最为直接。它采用“中等风险制品的 ImpACT 许可证”,核心要求如下:
- 提供联系信息和预期用例
- 披露任何基于 Dolma 衍生的作品
- 以相同许可证分发衍生作品
- 禁止将 Dolma 应用于监控、虚假信息传播等领域
针对个人隐私顾虑,AI2 提供了专门的删除请求表格,适用于特定情况而非一般的“拒绝使用”声明。如需访问 Dolma,可通过 Hugging Face 平台获取。