


对研究人员而言,阅读科学论文耗时巨大。调查显示,科学家每周平均花费7小时搜索信息;而一项文献系统综述(即对特定主题证据的学术综合)通常需要5人团队耗时41周才能完成。
但这一现状有望改变。
AI初创公司Elicit联合创始人Andreas Stuhlmüller表示,该公司专为科学家和研发实验室打造了一款“研究助手”,旨在利用AI简化文献综述中繁琐的流程。Elicit获得了Fifty Years、Basis Set、Illusion以及谷歌首席科学家Jeff Dean、前诺华CEO Thomas Ebeling等知名投资机构与个人的支持。
Stuhlmüller在接受TechCrunch邮件采访时介绍:“Elicit是一款利用语言模型自动化科学研究的研究助手。”该工具通过查找相关论文、提取关键信息并将其组织成概念,实现文献综述的自动化。
Elicit是从非营利研究基金会Ought分拆出的营利性企业。Ought由Stuhlmüller于2017年创立,他此前是斯坦福大学计算与认知实验室研究员。另一位联合创始人Jungwon Byun于2019年加入,曾负责在线借贷平台Upstart的增长业务。
Elicit整合多种第一方及第三方模型,在论文中搜索并发现概念。用户可提出如“肌酸的所有影响是什么?”或“哪些数据集被用于研究逻辑推理?”等问题,并从学术文献中获取答案列表。
Stuhlmüller指出:“通过自动化系统综述流程,我们能立即为学术界和行业研究机构节省成本和时间。当成本降至足够低时,还能解锁以往因高昂费用而无法实现的新用例,例如在领域知识更新时进行即时同步。”
应对AI幻觉:可靠性与透明度并重
针对语言模型易编造内容的问题——Meta的Galactica模型曾因频繁引用虚假论文而在上线三天后下架——Stuhlmüller强调Elicit已采取措施提升可靠性。
首先,Elicit将复杂任务拆解为“人类可理解”的部分,使用户能了解不同模型生成摘要时的出错频率,从而明确核查重点与时机。其次,系统会计算论文的“可信度”,综合考量试验是否受控或随机、资金来源、潜在利益冲突及样本规模等因素。
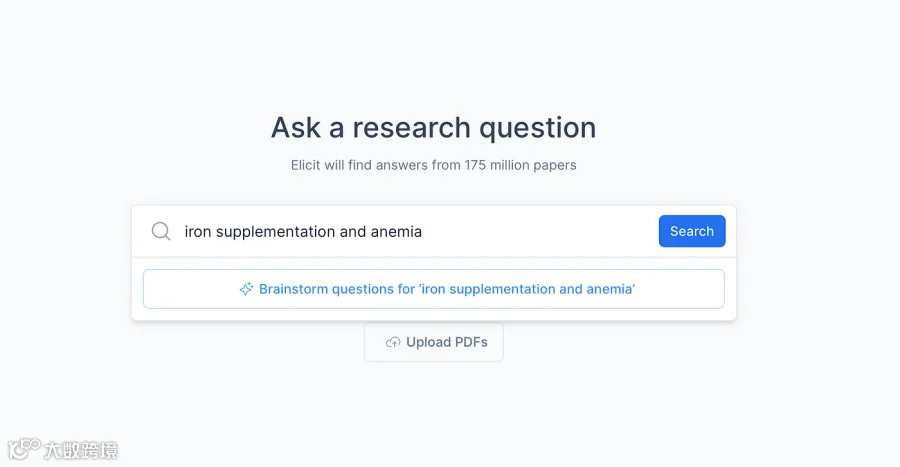
“我们不采用聊天界面,”Stuhlmüller表示,“用户将语言模型作为批处理作业运行。我们从不单独依赖模型生成答案,而是始终将其与原始科学文献关联,以减少幻觉并便于核查。”
尽管语言模型的固有缺陷难以彻底解决,但Elicit的努力已赢得研究社区的关注乃至信任。
增长势头与商业化路径
Stuhlmüller透露,Elicit月活跃用户超20万,自2023年1月以来同比增长3倍,客户涵盖世界银行、基因泰克和斯坦福大学等机构。“用户主动要求付费使用更强大的功能,并在更大规模上部署Elicit。”
这种增长促成了Elicit的首轮融资:由Fifty Years领投的900万美元。资金将主要用于产品迭代,以及扩充产品经理和软件工程师团队。
关于盈利模式,Stuhlmüller指向本周推出的付费层级,允许用户在比免费版更大的规模上搜索论文、提取数据和总结概念。长期战略是将Elicit打造成通用的企业级研究与推理工具。
面对艾伦人工智能研究所(Allen Institute for AI)等开源项目的竞争,Stuhlmüller认为二者更多是互补关系。“当前主要竞争对手仍是人工劳动力——那些一丝不苟地从论文中提取数据的研究助理。科学研究市场庞大,且研究工作流工具尚无主导者,这正是AI驱动新工作流程崛起的契机。”