


Cyrus Khajvandi 是斯坦福大学生物学毕业生,也是两位连续创业者之一。他在管理日常工作的同时,常常感到难以跟上科学研究的最新进展。他意识到自己并非个例——而且人工智能技术正变得越来越普及——于是开始开发一个 AI 平台,用于总结文档内容并回答相关问题,尤其是针对科学研究文献。
该平台于2月上线,Humata AI由前Labelbox创始人Dan Rasmuson担任首席技术官。它迅速获得关注——处理了数千万页文件,用户群增至数百万,并获得了包括Google的Gradient Ventures、ARK Invest和M13在内的投资者提供的350万美元融资。
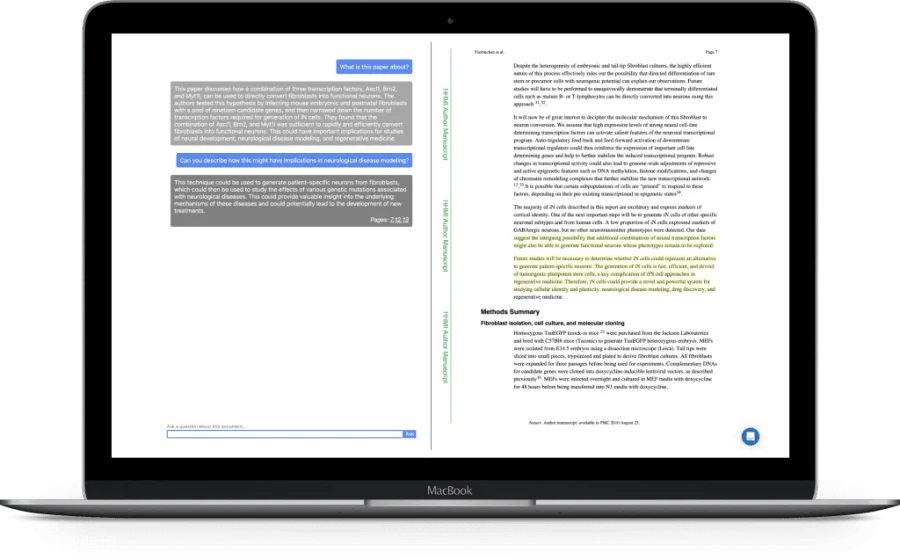
Khajvandi 表示:“Humata 的使命是通过让用户能够对所有文件提出问题,从而赋能个人和组织做出更明智、更快速的决策。Humata 就像是你所有文件的 [OpenAI] ChatGPT。”
核心功能与应用场景
Humata 在执行上极其简单。正如其核心理念所示,该平台允许用户就自己的文件(主要是 PDF 文件)提出问题并获得答案。用户可以上传一个或多个 PDF 文件,并在这些文件中提问;其客户不仅包括学术界人士,还有法律、石油和天然气行业以及客户支持领域的专业人士。
如今,诸如前述的 ChatGPT 和 Anthropic 的 Claude 等聊天机器人也提供了类似的文件分析功能。但 Khajvandi 认为,Humata 因其功能有限且专注,反而更加稳健可靠。
他说:“人们可以向 AI 提出任何问题,并从自己的数据中即时获取带有高亮引用的答案。这得益于近期 AI 技术的进步,使得每位工作者都能即时获得问题的解答。”
准确性与隐私安全
然而,AI并不一定擅长摘要。Fast Company 测试了ChatGPT总结文章的能力,发现该模型倾向于曲解内容、遗漏部分信息,甚至凭空捏造原文中不存在的“事实”。
还有一个显而易见的问题是隐私。公司——以及个人用户——可能不愿意将他们的文档上传到 Humata 的平台进行处理,特别是当这些文档包含敏感信息时。
Khajvandi 对 Humata 的摘要能力充满信心,声称该公司使用“多样化数据集”训练其模型,并对它们进行了严格的偏见测试。他还表示,Humata 仅收集“必要的数据”,并已实施“强有力的保障措施”以防止未经授权的访问。
Khajvandi 补充道:“我们确保知情同意,帮助用户理解他们同意的是什么。随着我们 AI 系统的不断进步,我们谨慎行事,不会在未经明确许可的情况下推断敏感信息。我们在不同地区和文化中遵守法律和道德标准,使 Humata 具备企业级就绪能力。”
商业进展与未来规划
据 Khajvandi 称,Humata 目前已有数千名付费计划客户。它计划将迄今为止筹集到的资金(358 万美元,包括种子前轮次融资)用于增强其 AI 能力、改善用户体验并扩大市场覆盖范围。
Khajvandi 说:“我们选择现在融资,是因为我们看到企业对从海量企业文件中合成洞察的高效 AI 驱动解决方案的需求不断增长。这笔资金将帮助我们开发新功能、完善现有产品并拓展新市场,最终通过 Humata 赋能企业利用私有数据做出更好、更快的决策。”