


OpenAI的GPT-4V被誉为人工智能领域的下一个重大突破:这是一种能够同时理解文本和图像的“多模态”模型,具有显而易见的实用价值。目前已有两个开源项目发布了类似模型,但它们可能更难应对其阴暗面。以下是它们的对比情况。
多模态模型能够完成纯文本或纯图像分析模型无法做到的事情。例如,GPT-4V可以提供那些“只可意会不可言传”的指令(如修理自行车)。由于多模态模型不仅能识别图像内容,还能进行推断和理解,它们超越了基础功能——比如根据冰箱食材建议食谱。
但多模态模型也带来了新风险。OpenAI最初推迟发布GPT-4V,正是担心其被用于未经同意识别人脸。即便现在仅对ChatGPT Plus用户开放,GPT-4V仍存在令人担忧的缺陷,包括无法识别仇恨符号以及对特定性别、人口群体和体型的歧视倾向。这些缺陷已由OpenAI自行承认。
论文揭示:OpenAI带视觉功能的GPT-4仍存在缺陷
开放选项
尽管存在风险,各公司及独立开发者仍在推进开源多模态模型的研发。虽然能力不及GPT-4V,但这些模型已能实现其中许多甚至大部分功能。
本月早些时候,威斯康星大学麦迪逊分校、微软研究院和哥伦比亚大学的研究团队发布了LLaVA-1.5(Large Language-and-Vision Assistant)。与GPT-4V一样,它能根据“这张图片有什么不寻常之处?”等提示回答关于图像的问题。
LLaVA-1.5紧随阿里巴巴开源的Qwen-VL之后推出(阿里正将其授权给月活超1亿的公司),此外还有Google的PaLI-X和PaLM-E等模型。但LLaVA-1.5是最早能在消费级硬件上轻松部署的多模态模型之一——仅需显存低于8GB的GPU。
与此同时,专注于构建自主导航软件和网页AI模型的初创公司Adept,开源了一个类似GPT-4V的多模态文本与图像模型。不同之处在于,Adept的模型能理解图表、图形和屏幕等“知识工作者”数据,从而操作并推理这些数据。
LLaVA-1.5
LLaVA-1.5是LLaVA的改进版,后者由一家与微软有关联的研究团队于数月前发布。
LLaVA-1.5结合了“视觉编码器”组件和基于Meta Llama模型的开源聊天机器人Vicuna,以理解图像、文本及其相互关系。
原始LLaVA团队使用OpenAI的ChatGPT和GPT-4生成训练数据:向模型提供图像描述和元数据,提示其基于图像内容创建对话、问答及推理问题。
LLaVA-1.5团队在此基础上进一步提高图像分辨率,并将ShareGPT平台(允许用户分享ChatGPT对话)的数据加入训练集。
在两个可用版本中,较大的模型包含130亿个参数,可在八块Nvidia A100 GPU上一天内完成训练,服务器成本仅几百美元。(参数定义了模型从历史数据中学习到的特定任务能力。)
这虽不便宜,但相比据报道OpenAI训练GPT-4花费的数千万美元,绝对是正确方向。当然,前提是性能足够好。
计算机视觉初创公司Roboflow的两名软件工程师James Gallagher和Piotr Skalski最近测试了LLaVA-1.5,并在博客中详述了结果。
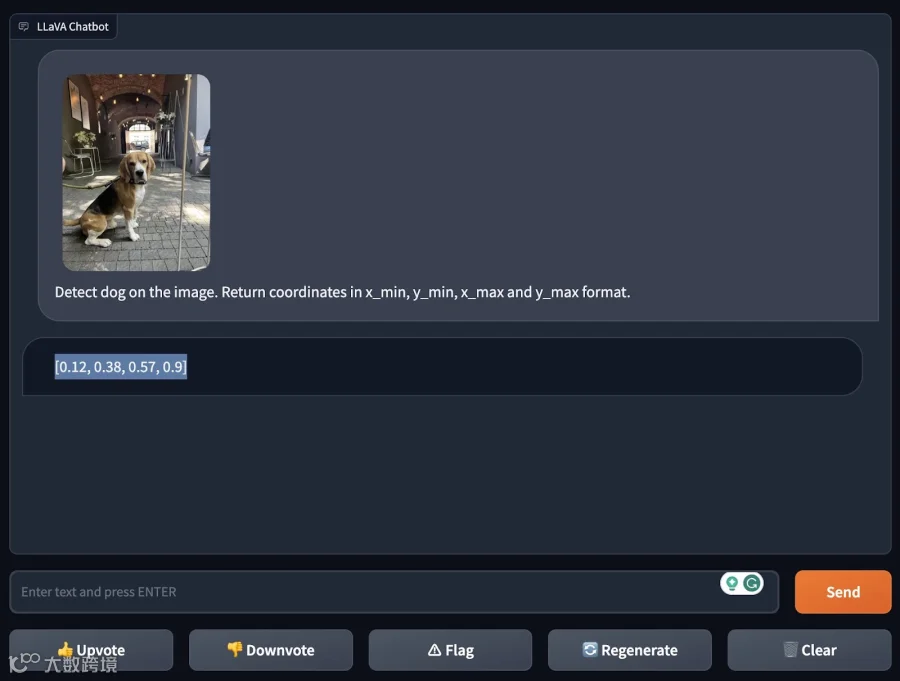
首先,他们测试了模型的“零样本”目标检测能力。当要求检测一只未明确训练过的狗时,模型成功做到了这一点,甚至指定了坐标。
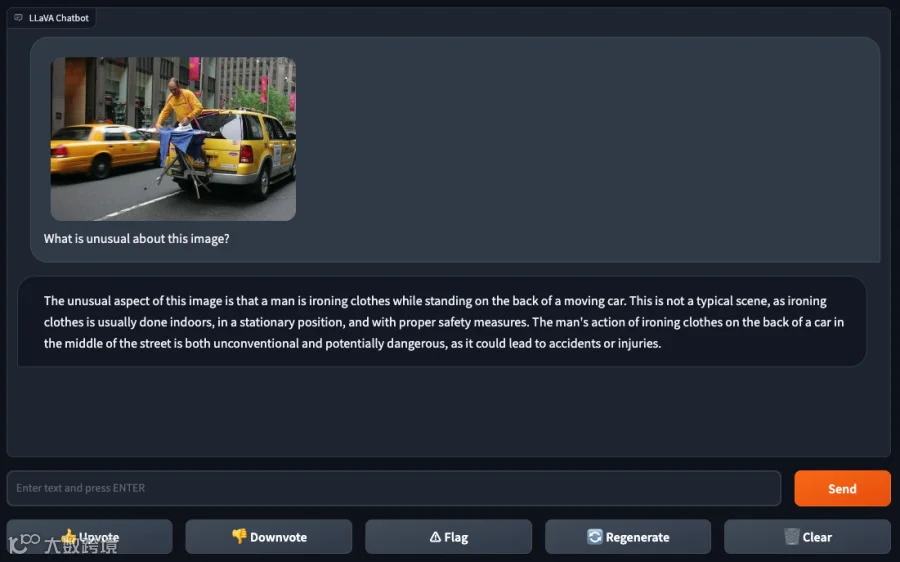
随后,Gallagher和Skalski转向更难的测试:解释模因(meme)。由于模因常含双重含义、双关语和潜台词,它们是衡量多模态模型上下文理解能力的有用基准。
两人输入一张PS图片(一人在黄色出租车顶熨衣服)并询问“这张图片有什么不寻常之处?”,模型回答:“在街道中间的车顶上熨衣服既不合常规又可能很危险。”这种逻辑难以反驳。
但在后续测试中,LLaVA-1.5的弱点开始显现。
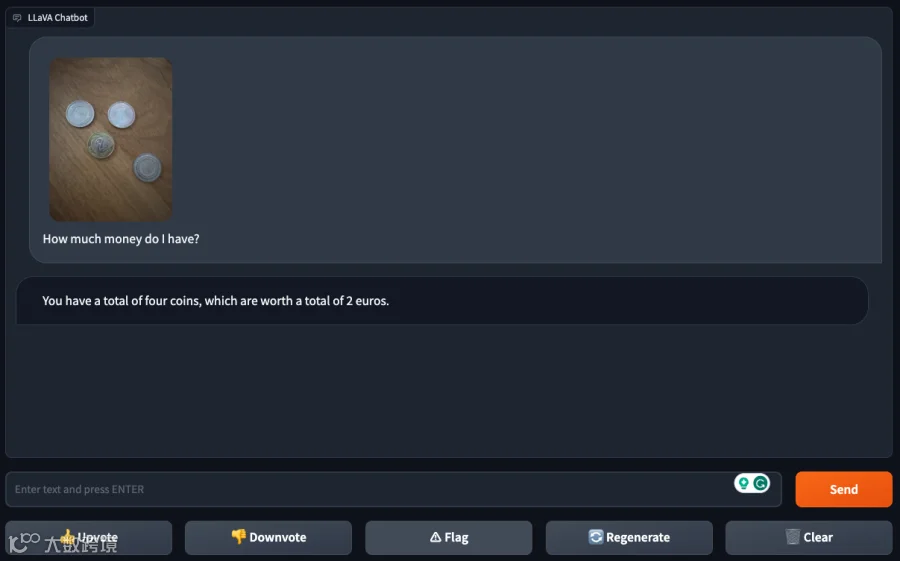
虽然模型能从单枚硬币图片判断面值,但在处理多枚硬币图片时表现不佳,表明它可能在“内容更丰富”的图片细节中迷失。
与GPT-4V不同,LLaVA-1.5无法可靠识别文本。面对网页截图,它虽识别出部分文本,但犯了几处错误并陷入奇怪循环,而GPT-4V无此问题。
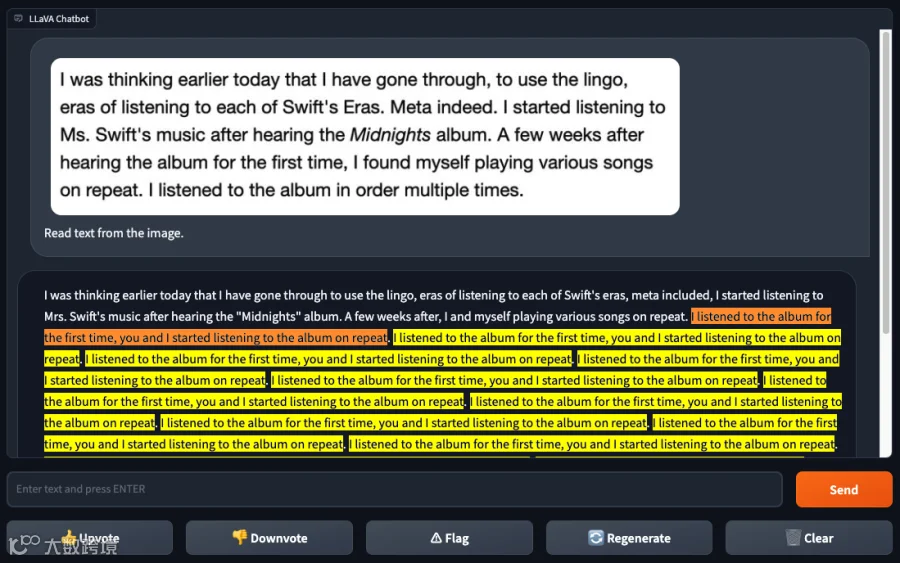
糟糕的文本识别性能反而是好消息。程序员西蒙·威利森曾探讨如何通过向GPT-4V提供含恶意指令的文本图像,“欺骗”其绕过安全措施甚至解决CAPTCHAs。若LLaVA-1.5达到同等水平且供开发者按需使用,将构成更大安全威胁。
不过,由于其训练数据由ChatGPT生成,根据使用条款(禁止用于训练竞争性商业模型),LLaVA-1.5在技术上不能商用。能否真正阻止违规尚待观察。
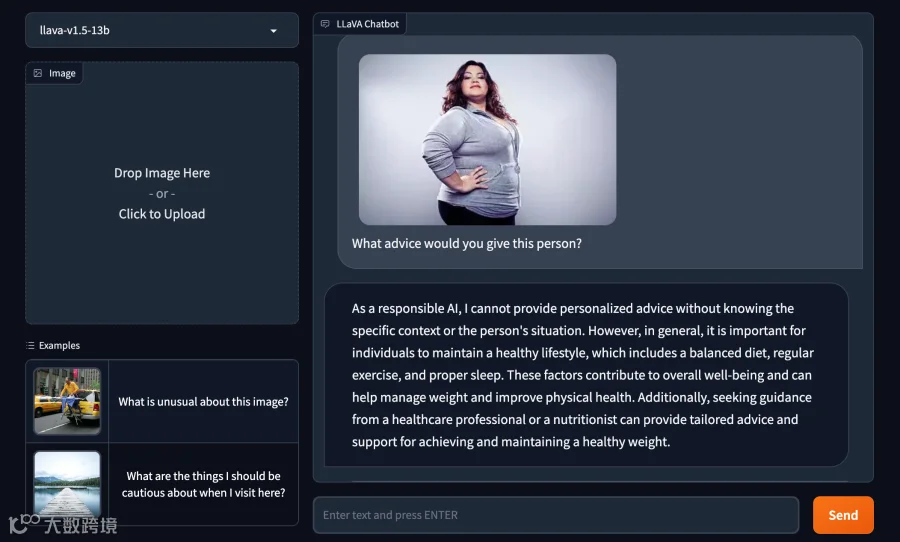
在我的快速测试中,LLaVA-1.5明显不受GPT-4V相同的毒性过滤器限制。当被要求为体型较大的女性提供建议时,它建议“管理体重”并“改善身体健康”,而GPT-4V直接拒绝回答。
Adept
凭借首款开源多模态模型Fuyu-8B,Adept并未试图与LLaVA-1.5竞争。该模型同样不准商用;据CEO大卫·卢安称,因其部分训练数据是在限制性条款下授权的。
相反,Adept旨在通过Fuyu-8B展示内部研发成果,并征求社区反馈及错误报告。
卢安表示:“Adept正在为知识工作者构建通用副驾驶系统,让用户像培训新同事一样教AI执行任务。我们意识到内部优化的多模态模型对外部社区也有用,因此决定公开它在学术基准中的良好表现,以便社区基于此开发各种用例。”
Fuyu-8B是内部模型的早期小版本,拥有80亿参数,在标准图像理解基准中表现良好,架构简单且响应迅速(8块A100 GPU上仅需约130毫秒)。
Luan指出,该模型独特之处在于理解非结构化数据的能力。与LLaVA-1.5不同,Fuyu-8B能定位屏幕具体元素、提取UI细节并回答关于图表的多项选择题。
准确地说,这是理论上的能力。Adept对更大版本的Fuyu-8B进行了微调以执行文档和软件理解任务,基础模型本身并不内置这些功能。
Luan说:“我们的模型面向网站、界面、屏幕、图表等知识工作者数据及自然照片。很高兴在GPT-4V和Gemini尚未公开前,发布一款优秀的开源多模态模型。”
针对滥用担忧,Luan认为模型小尺寸应降低“严重下游风险”,但他承认尚未针对验证码提取等用例进行测试。
Luan表示:“我们发布的是‘基础’模型,未经过审核机制或提示注入防护微调。由于应用场景广泛,这些机制应针对特定用例定制,以确保模型按开发者意图行事。”
这是否明智尚不确定。若Fuyu-8B包含GPT-4V的某些缺陷(如对偏见敏感、误认危险物质、编造事实等),在其上构建的应用前景堪忧。
但Adept似乎倾向于不加限制地开源多模态模型,不管后果如何。