


文本生成式人工智能已不新鲜,但能像理解文本一样理解图像的AI模型,正解锁强大新应用。
总部位于旧金山的初创公司Twelve Labs便是典型代表。该公司训练AI模型解决复杂的视频-语言对齐问题,旨在构建多模态视频理解基础设施,首个举措即实现“视频的CTRL+F”语义搜索。其愿景是帮助开发者构建能像人类一样看、听和理解世界的程序。
Twelve Labs的模型将自然语言与视频内容(含动作、物体及背景音)映射,支持可搜索视频、场景分类、主题提取、自动摘要及章节拆分等应用。该技术还可推动广告插入、内容审核(如区分暴力与教学)、媒体分析,以及自动生成精彩集锦、博客标题和标签。
针对模型可能放大训练数据偏见的问题,Twelve Labs致力于在发布前满足内部偏见与公平性指标,并计划未来发布相关伦理基准测试和数据集。
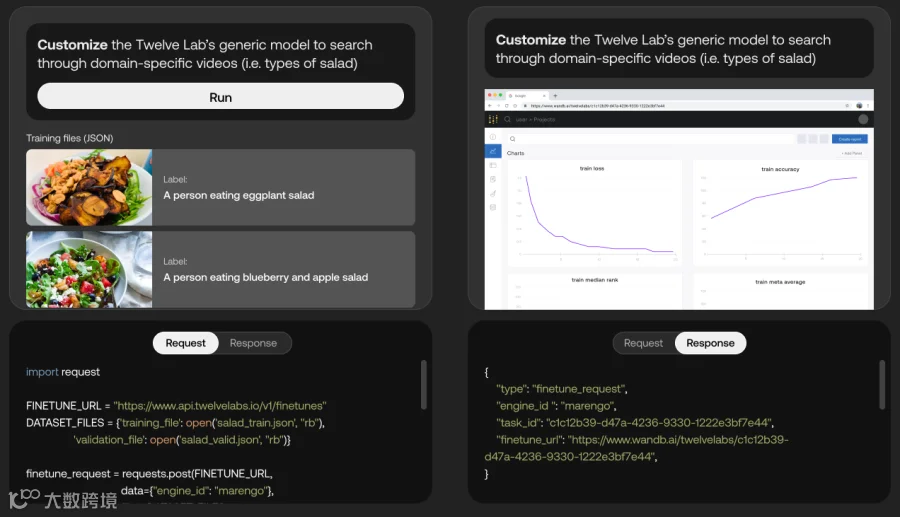
相较于ChatGPT等大语言模型,Twelve Labs专为视频理解构建,全面整合视觉、音频和语音组件,大幅突破技术极限。尽管谷歌MUM及微软、亚马逊等也提供类似API服务,但Twelve Labs的核心优势在于模型质量及平台微调功能,允许客户使用自有数据实现特定领域视频分析。
今日发布的Pegasus-1是新多模态模型,能理解整段视频分析提示,生成长篇详细描述或带时间戳的亮点片段。企业借此无需人工分析即可实现人类水平的视频理解,挖掘海量视频数据的商业潜力。
自今年5月推出私有测试版以来,Twelve Labs用户群已增至17,000名开发者,并与NFL等体育、媒体、教育及安全领域企业合作。同时,公司完成由Nvidia、Intel和Samsung Next参与的1,000万美元战略融资,累计融资达2,700万美元,旨在加速研究、产品与分销发展,持续为客户交付最强模型。