


在首届开发者大会上,OpenAI 披露了旗舰文本生成 AI 模型 GPT-4 视觉版(GPT-4 with vision)的新细节。该版本具备图文多模态理解能力,不仅能添加图片标题,还能解读复杂图像,例如从 iPhone 照片中识别 Lightning 转接头。
此前,GPT-4 视觉版仅面向 Be My Eyes 订阅者、ChatGPT Plus 用户及“红队测试员”开放。3 月初推出后,因担忧隐私侵犯等滥用风险,OpenAI 曾将其暂时搁置。如今,随着缓解措施逐步完善,OpenAI 宣布将在未来几周内通过 GPT-4 Turbo API 向更广泛的开发者社区开放集成权限。
安全性与准确性仍存疑
核心问题在于:GPT-4 视觉版是否真的更安全?今年 10 月,OpenAI 发布白皮书阐述了模型局限性及潜在偏见(如体型歧视),但该报告由内部科学家撰写,缺乏外部客观视角。不过,包括宾夕法尼亚大学副教授 Chris Callison-Burch 及其博士生 Alyssa Hwang 在内的红队成员获得了早期访问权,并在本次大会上分享了初步评估结果。
优势与缺陷并存
Callison-Burch 表示,自 7 月获准使用以来,GPT-4 视觉版在回答图像问题、辅助游戏场景选择及描述艺术风格等任务中表现卓越,显著超越了现有先进水平。
然而,Hwang 的系统性审查揭示了模型在关键领域的缺陷:
- 结构与关系误判:虽能正确描述元素位置,但在结构或相对关系上常出错。例如,能识别折线图曲线向上倾斜,却误判高低顺序;处理图表时易错估数值或误解图例颜色。
- 学术图表解析不准:在复现数学公式时常遗漏或错写下标;统计物体数量及区分相邻物体颜色也是短板。
- 文本提取错误:无法可靠提取图中文字。研究显示,模型将“Eggless Red Velvet Cake”误读为“Eggs Red Velvet Cake”,将“Sesame Pork Milanese”误写为“Sesame Pork Medallions”。
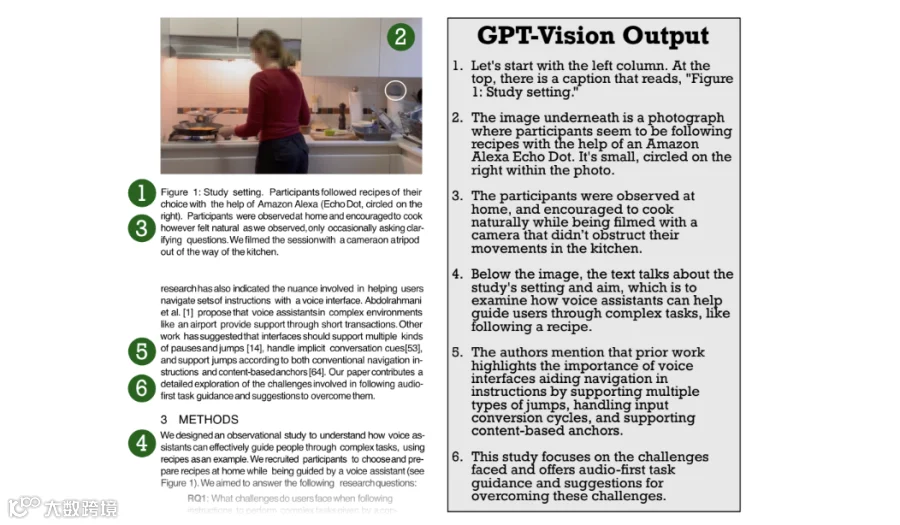
此外,在文档摘要生成方面,模型可能拙劣改写句子导致信息遗漏,或以误导性方式篡改引语,影响原文含义。
结论:仍处于开发阶段
尽管存在上述问题,GPT-4 视觉版在复杂场景描述上依然出色,契合无障碍应用需求。但研究证实,该模型远非通用问题解决者,仍会犯简单错误并可能引入偏见,尚处开发阶段。
目前尚不清楚安全措施对准确性的影响程度,亦不确定模型是否因视觉训练数据不足而难以处理边缘情况。OpenAI 声称正构建“缓解措施”以安全扩展能力(如描述人物但不识别身份)。其能否成功,抑或触及当前多模态训练方法的极限,仍有待观察。