


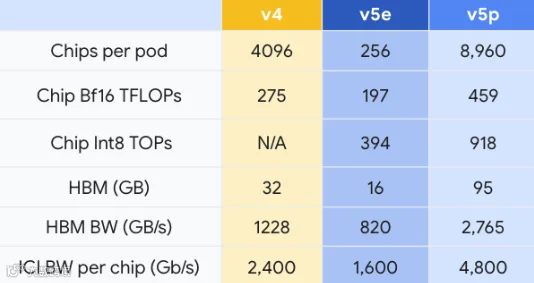
Google 今日宣布推出全新 Gemini 大型语言模型(LLM),同步发布 Cloud TPU v5p。作为今年早些时候全面可用的 Cloud TPU v5e 的升级版,v5p 集群由 8,960 个芯片组成,依托 Google 迄今最快的互连技术,单芯片带宽高达 4,800 Gbps。
谷歌承诺 v5p 速度显著优于 v4 TPU:浮点运算能力(FLOPS)提升 2 倍,高带宽内存性能提升 3 倍。尽管 v5e pod 在规模(256 芯片 vs v4 的 4096 芯片)和 16 位浮点性能(197 TFLOPs vs v4 的 275 TFLOPs)上相较 v4 有所降级,但全新 v5p 的 16 位浮点性能最高可达 459 TFLOPs,并配备更快的互连技术。
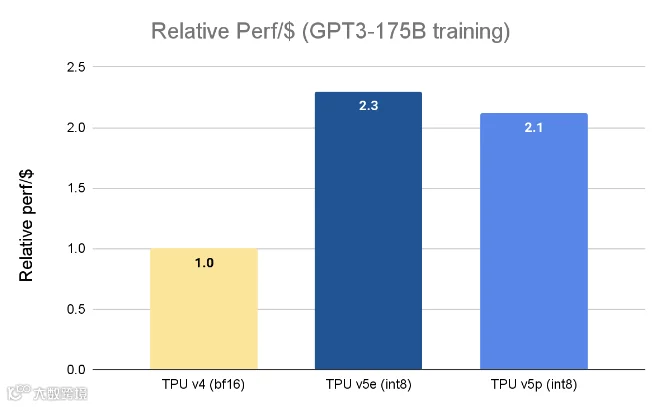
据谷歌介绍,TPU v5p 训练 GPT-3 175B 等大型语言模型的速度比 TPU v4 快 2.8 倍,且更具成本效益。不过需注意,v5e 虽速度较慢,但其每美元相对性能实际上优于 v5p。
Google DeepMind 与 Google Research 首席科学家 Jeff Dean 表示:“早期测试显示,TPU v5p 在 LLM 训练负载上的速度较 TPU v4 提升 2 倍。对 JAX、PyTorch、TensorFlow 等 ML 框架及编排工具的有力支持,使 v5p 能实现更高效扩展。第二代 SparseCores 的引入,也显著提升了以嵌入为主的工作负载性能。TPU 是推动 Gemini 等前沿模型大规模研究与工程落地的关键。”
目前 TPU v5p 尚未全面开放,开发人员需通过官方渠道申请访问权限。