


尽管投资者们正准备在Sam Altman被不体面地逐出OpenAI后采取激烈行动,且Altman正策划回归,但OpenAI的Superalignment团队仍勤勉致力于解决如何控制比人类更聪明的AI这一问题。
或者至少,这是他们希望给人的印象。
本周,我与Superalignment团队的三位成员——Collin Burns、Pavel Izmailov和Leopold Aschenbrenner——通了一次电话。当时他们正在新奥尔良参加NeurIPS(年度机器学习会议),展示OpenAI在确保AI系统按预期行为方面的最新研究成果。
OpenAI于七月组建了Superalignment团队,旨在开发引导、监管和治理“超级智能”AI系统的方法——即那些智力远超人类的理论系统。
“目前,我们基本上可以对齐那些比我们笨的模型,或者最多达到人类水平,”Burns表示,“对齐一个实际上比我们更聪明的模型要困难得多——我们甚至该如何做到这一点?”
Superalignment项目由OpenAI联合创始人兼首席科学家Ilya Sutskever领导。这在七月并未引起争议,但鉴于Sutskever是当初推动解雇Altman的人之一,如今此事无疑引人注目。尽管有报道称Sutskever在Altman回归后处于“悬而未决”的状态,但OpenAI公关人员确认,截至今天,Sutskever仍在领导Superalignment团队。
Superalignment在AI研究社区中是一个敏感话题。一些人认为该子领域尚不成熟;另一些人则暗示这是一个误导性的议题。
虽然Altman邀请人们将OpenAI与曼哈顿计划相提并论,甚至组建团队研究AI模型以防范包括化学和核威胁在内的“灾难性风险”,但一些专家表示,几乎没有证据表明这家初创公司的技术会在近期或永远获得终结世界、超越人类智慧的能力。这些专家补充称,关于超级智能迫在眉睫的说法,只是为了故意转移注意力,让人忽视当下紧迫的AI监管问题,如算法偏见和AI倾向于产生有害内容。
无论如何,Sutskever似乎真诚地相信AI——并非特指OpenAI的AI,而是其某种体现形式——未来可能构成存在性威胁。据报道,他甚至在一次公司外勤活动中委托制作并焚烧了一具木制人像,以展示防止AI对人类造成伤害的承诺,并为Superalignment团队的研究调配了大量算力——占其现有芯片的20%。
“最近AI进展极其迅速,我可以向你保证,它并没有放缓,”Aschenbrenner说道,“我认为我们很快就能达到人类水平的系统,但不会止步于此——我们将直接迈向超人类系统……那么,我们如何对齐超人类AI系统并确保其安全?这确实是全人类面临的问题——可能是我们这个时代最重要的未解技术难题。”
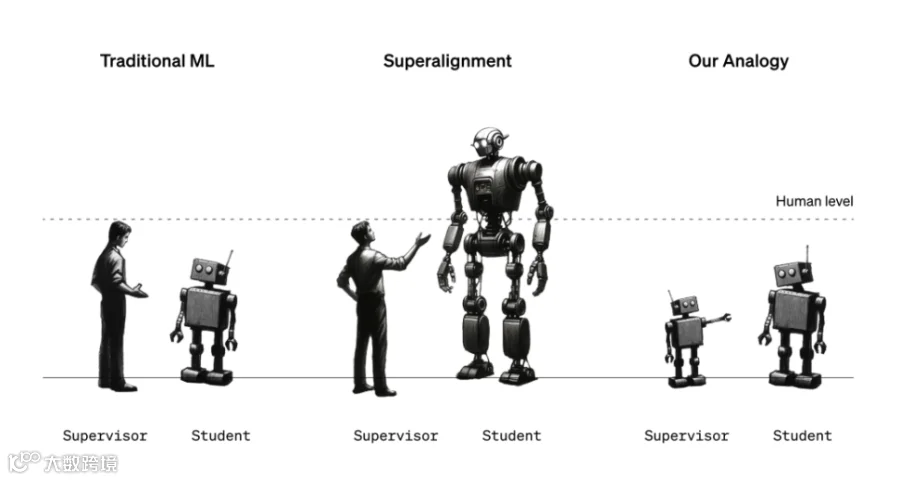
目前,Superalignment团队正试图构建治理和控制框架,这些框架可能适用于未来的强大AI系统。考虑到“超级智能”的定义以及某个特定AI系统是否已实现超级智能仍是激烈争论的焦点,这并非易事。但该团队目前确定的方法涉及使用较弱、较不复杂的AI模型(例如GPT-2)来引导更先进、更复杂的模型(GPT-4)走向理想方向,并远离不理想方向。
“我们试图做的很多事情是告诉模型该做什么,并确保它会去做,”Burns解释道,“我们如何让模型遵循指令,并只帮助处理真实的事情而不编造内容?我们如何让模型告诉我们它生成的代码是否安全或是否存在严重不当行为?这些是我们希望通过研究实现的任务类型。”
但AI引导AI与防止威胁人类的AI有什么关系?这是一个类比:弱模型旨在充当人类监督者的替身,而强模型则代表超级智能AI。类似于可能无法理解超级智能AI系统的人类,弱模型也无法“理解”强模型的所有复杂性和细微差别——因此,这种设置对于验证超对齐假设非常有用,Superalignment团队表示。
“你可以想象一个六年级学生试图监督一名大学生,”Izmailov解释道,“假设这个六年级生正试图告诉大学生如何解决某个他略知一二的任务……尽管来自六年级生的监督在细节上可能存在错误,但仍有希望大学生能理解大意,并比监督者更好地完成该任务。”
在超级对齐(Superalignment)团队的设计中,一个针对特定任务微调的弱模型会生成标签,用于向强模型“传达”该任务的大致轮廓。研究团队发现,即使弱模型的标签包含错误和偏见,强模型也能根据弱模型的意图大致正确地泛化这些标签。
该团队声称,这种弱-强模型方法甚至可能在幻觉领域带来突破。
Aschenbrenner表示:“幻觉其实非常有趣,因为从内部来看,模型实际上知道它所说的内容是事实还是虚构。但如今这些模型的训练方式是,人类监督者会对模型说出的话给予‘赞’或‘踩’的评价。因此,有时人类无意中奖励了模型说出虚假内容,或者模型本身并不了解的内容等。如果我们的研究取得成功,我们应该开发出能够基本召唤模型知识的技术,并将其应用于判断某事是事实还是虚构,从而减少幻觉。”
但这个类比并不完美。因此,OpenAI希望众包创意。
为此,OpenAI正在启动一项价值1000万美元的资助计划,以支持关于超级智能对齐的技术研究,其中部分资金将保留给学术实验室、非营利组织、独立研究人员和研究生。OpenAI还计划在2025年初举办一场关于超级对齐的学术会议,届时将分享并推广超级对齐奖决赛入围者的工作。
有趣的是,该资助计划的部分资金将来自前谷歌首席执行官兼董事长埃里克·施密特。施密特——Altman的坚定支持者——正迅速成为“AI末日论”的代表人物,他断言危险的人工智能系统即将出现,而监管机构在准备工作方面做得还不够。这未必出于利他主义——据《Protocol》和《Wired》杂志报道,作为活跃的AI投资者,如果美国政府实施他提出的加强AI研究的蓝图,施密特将在商业上获得巨大利益。
因此,这笔捐赠可能被视为一种通过愤世嫉俗视角解读的道德姿态。施密特的个人财富估计约为240亿美元,他已将数亿美元投入其他明确较少关注伦理的人工智能项目和基金——包括他自己的项目。
当然,施密特否认了这一点。
他在一份电子邮件声明中表示:“人工智能和其他新兴技术正在重塑我们的经济和社会。确保它们与人类价值观保持一致至关重要,我很自豪能支持OpenAI的新[资助]项目,以负责任地开发和控制人工智能,造福公众。”
确实,一个具有如此明显商业动机的人物参与其中,不禁让人发问:OpenAI的超级对齐(superalignment)研究,以及它鼓励社区提交至其未来会议的研究,是否会向任何人开放供其自由使用?
超级对齐团队向我保证,是的,OpenAI的研究——包括代码——以及其他获得OpenAI资助和奖项、从事超级对齐相关工作的成果,都将公开共享。我们将督促公司兑现这一承诺。
Aschenbrenner表示:“不仅为我们要模型的安全做出贡献,也为其他实验室的模型以及更广泛的高级人工智能的安全做出贡献,是我们使命的一部分。这确实是我们致力于安全地为全人类利益构建[AI]的核心所在。我们认为,开展这项研究对于确保其有益且安全至关重要。”