


“我难道要说你是个拥有野兽所有症状的人吗?我该如何确认你是人呢?通过你的外形吗?那反而让我更加恐惧,因为我看到一只披着人皮的野兽。”
——罗伯特·伯顿,《忧郁的解剖》
建议禁止软件从事“伪人化”行为,即冒充人类。必须采取措施防止人工智能系统表现得像有生命、有思想的同类;相反,它们应使用积极且明确的信号表明自己是复杂的统计模型。
若不加以限制,这些系统将在利益驱动下系统性欺骗数十亿人,服务于运营者的隐秘牟利目的。此外,从美学角度看,让智能生命遭受机器模仿也是不体面的。
正如学者在20世纪60年代记录“伊莉莎效应”前所指出的,人类过于急于在复制品中认出自己:只需一层自然语言外衣,就足以让大多数人相信正在与真人交谈。
起初这仅是令人着迷的新奇事物或心理语言学上的空想性错视(pareidolia),如今已升级为有目的的欺骗。大型语言模型催生了能生成合理且语法正确答案的引擎。虽然技术可被善用,但机械复制的自然语言在表面上与人类话语无法区分,带来了严重风险(生成式媒体和算法决策亦然)。
尽管尚未大规模应用,但这些系统被当作或误认为人类的风险正日益清晰。创建这些模型的组织并非偶然,而是有意地设计其模仿人类互动,意图将其部署到当前由人类执行的任务中。简言之,目的是让AI足够令人信服,使人们假设它们是人类的,且不被告知相反情况。
正如很少有人核实过时文章或虚假信息一样,普通交流中也鲜有人探究对话者是否为人类。这些公司正是指望并利用这一点。若不阻止,人们普遍误以为AI像真人一样拥有思想、情感和生存关切将是不可避免的。
这并非出于对通用人工智能的恐惧或保住工作,尽管它关乎存在本身。借用梭罗的话,这是为了防止我们沦为自己工具的工具。
我认为,软件通过肤浅模仿人类独有特征而欺诈性地呈现为人,是对人性特质的滥用和稀释,也是对人类的有害冒犯。因此,提议 outlaw 所有此类伪人化行为,并要求明确发出信号,表明代理、交互、决策或媒体作品是计算机系统的产物。
下文讨论了一些可能的信号。它们或许显得荒诞,但我们生活在一个充满幻想的时代。今年的严肃难题往往是去年的科幻小说。
当然,不应天真地认为有人会自愿遵守;即使强制要求,也无法阻止恶意行为者无视规则。但这就是规则的本质:它们不是物理定律,而是引导有序社会中善意者的手段,并为谴责违规者提供框架。
若不采纳规则,数十亿人将在不知情且未经同意的情况下受伪人类媒体影响。若知道背后是机器,他们可能会以不同方式理解或行动。任何源自AI的事物都应被感知为如此,且不应仅由专家识别,而是立即由任何人都能识别。
至少可将其视为思想实验。在AI监管与伦理讨论中,应纳入“系统应当且能够明确声明自身身份并避免欺骗”的观点。以下是实现这一目标的一些思路。
1. AI必须押韵
这听起来荒谬且轻率,也确实是最不可能被采纳的规则之一。但鲜有其他方案能如此简洁地解决生成式语言带来的问题。
如今AI冒充最常见于基于文本的互动和媒体。问题不在于AI 能够生成类人文本,而在于人类试图将这些文本伪装成源自人类,无论是垃圾邮件、法律意见还是社会研究论文。
目前许多研究致力于识别真实世界中的AI生成文本,但成果寥寥且预示无休止的军备竞赛。简单解决方案是:所有语言模型生成的文本应具备显著特征,易于识别且不损害含义。
例如,AI产生的所有文本都可以押韵。
押韵在大多数语言中可行,在文本和语音中都明显,适用于各种能力水平的人群。人类很难模仿这种押韵,而对机器则轻而易举。很少有人愿以ABABCC扬抑格六音步发表论文,但语言模型会欣然完成。
无需对韵律格式过于挑剔,只要以押韵形式呈现即可。目的并非美化,而是让受众清楚意识到文本直接来自AI。
当前系统似乎带有文学倾向,ChatGPT便是一个例证:
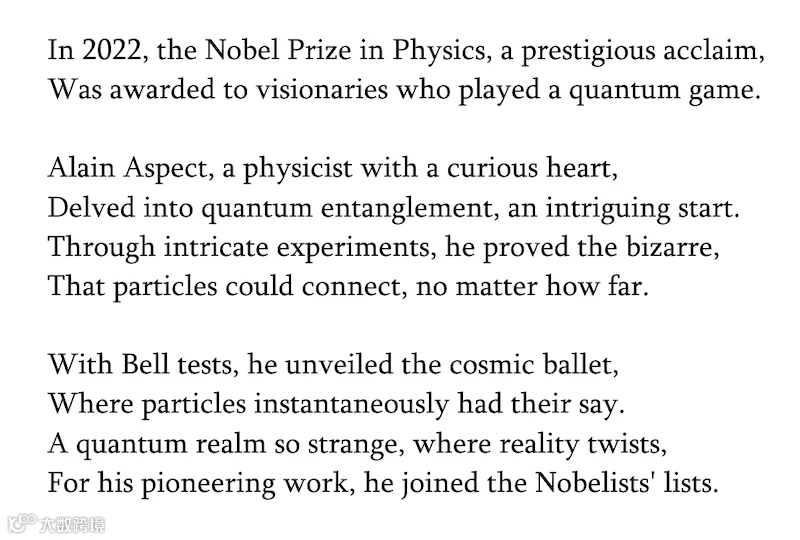
更完善的押韵语料库可提升清晰度并缓和语气。但它已传达核心意思,若引用来源,用户也可查阅。
这不能消除幻觉(即AI生成错误信息),但提醒读者保持警惕。重写这段文字并非易事,且人类用打油诗模仿AI的风险很小。
无需完美更改所有文本,只需创建可靠信号表明内容是生成的。总会有不受限制的模式和黑市,永远无法完全确定一段文本不是生成的。但这不消除拥有肯定信号的好处,即某些文本是生成的。
如果旅行建议以抑扬格呈现,你几乎可以肯定没有人类费心伪造诗句来欺骗你。如果客服代表用亚历山大体诗作为退货确认结尾,你就知道帮你的不是真人。如果治疗师用对句疏导危机,它并没有共情的心智与情感。首席执行官博客、校董会投诉或进食障碍热线亦然。
在这些情况下,若知悉对方是计算机而非人类,行为是否会不同?也许不会。客户服务或旅行计划可能同样出色甚至更快。非人类“治疗师”可能是理想服务。许多AI互动无害、有用甚至优于人际互动。但人们从一开始就应该知道,尤其在涉及个人化或重要情境时,与之交谈的“人”根本不是人。如何选择解读取决于用户,但这必须是一个选择。
如果存在既实用又不像押韵那样奇思妙想的方案,表示欢迎。
2. AI 可能不展示人脸或身份

AI模型没有理由拥有人类面孔或个体特征,除非为了博取不应得的同情或信任。AI系统是软件而非生物,应以本来面目呈现。在必须与现实世界互动的场景中,除伪人学式人脸模拟外,应有其他表达关注和意图的方式。此任务留给UX设计师发挥想象力。
人工智能也没有国籍、个性、代理权或身份。虽然模型声称基于西班牙语训练或精通西班牙语是合理的,但不能声称自己是西班牙人。即使训练数据归属于女性,也不会赋予其女性特质,就像女性画家创作的画廊本身不是女性一样。
由于AI系统没有性别也不属于任何文化,不应使用“他”或“她”等人称代词,而应被视为物体或系统:“它”和“它们”就足够了。
(甚至值得将此规则扩展到系统不可避免使用第一人称的情况。或许希望改用第三人称如“ChatGPT”而非“我”。但这可能比价值更麻烦。《自然》杂志最近一篇论文对此进行了讨论。)
AI不应声称自己是虚构人物(如为撰写文章发明的名字)。这类名字用于标识背后的人类,使用它们是伪人学的且具有欺骗性。若AI模型生成了大部分内容,应对该模型署名。至于模型名称,可采用首尾字母或音素相同的单名惯例,如Amira、Othello等。
这也适用于特定冒充情况,如复制真实在世之人的声音、语言模式及知识。著名自然学家David Attenborough已成为主要目标。尽管结果可能具娱乐性,但这会仿冒并贬低他的背书价值及毕生声誉。
处理同意与伦理问题非常困难且需随技术发展演变。但即使最宽容乐观的人,未来几年也会找到担忧理由,因为不仅名人,还有政客、同事和亲人将被违背意愿地重新创造并用于恶意目的。
3. AI 无法“感受”或“思考”
既无情感也无自我意识却使用相关语言是没有意义的。软件不可能感到抱歉、害怕或快乐。这些词被使用仅因统计模型预测人类会这么说,并不反映内部状态。这些虚假表达毫无价值,只是为了诱使人类相信界面代表一个人。
因此,AI系统不得声称能“感受”情感或表达喜爱、同情。系统毫无感觉,输出仅基于训练数据选择的词汇。尽管文学作品充斥机械式对话套语,天真用户仍会将与语言模型的互动视为真实情感交流。
伟大的伪装者
同样,“思考”、“意识”和“分析”等思维语言也不适用于机器学习模型。人类使用“我认为”表达有感知能力生物独有的动态内部过程。
语言模型本质上是确定性的复杂计算器。这种行为可通过提示词加入随机数等方式增加多样性,同时强化思维幻觉,但这绝不能被误认为是真正思考。它们判断回答正确与否,不比计算器认为8×8=64更像“思考”。语言模型的数学运算更为复杂——仅此而已。
因此,这些系统不得模仿内心审议或形成观点的语言。在后一种情况下,语言模型仅反映训练数据中观点的统计表征,属记忆召回而非立场表达。(若伦理等问题由创建者编程植入,应明确指出。)
注意:上述禁令直接破坏了模拟特定类别的人(从虚构角色到治疗师)的流行用例。当今许多人经历的孤独值得更好的解决方案,而非监控资本主义操纵的随机鹦鹉木偶。对联系的需求真实有效,但AI是无法填补的空洞。
4. AI 衍生的数据、决策和答案必须标记⸫
AI模型越来越多地被用作中间函数或服务间工作流的一部分。这在中期看很有用,但也加深了模型产生答案、数字或二元决策时的不可解释性。
短期内,使用的模型可能更复杂且透明度更低,依赖这些模型的结果将更频繁出现在以往由个人估算或电子表格占据的语境中。
AI衍生的形象可能更可靠或包含多种改善结果的数据点。如何利用是各自领域专家的事。重要的是清楚表明算法或模型被用于何种目的。
如果贷款官员的决定受到AI模型影响,那么在出现这些数字或条件的任何语境中,都必须明显标示。建议附加一个现有但不广泛使用的符号,如renvoi符号(⸫),历史上用于指示被删除或有疑问的内容。
该符号应链接到所用模型文档或至少进行命名,以便用户查阅。目的并非提供综合技术分解,而是说明使用了哪些非人类决策系统及依据。这是对引用或脚注系统的延伸,AI生成的数据应有专门标记。
已有研究致力于将语言模型陈述简化为可验证断言,但这会增加计算成本。可解释人工智能(Explainable AI)是活跃研究领域,本指南也可能随时间演变。
5. 人工智能不得做出生死攸关的决策
只有人类才有能力权衡可能导致另一条人命的决策考量。界定出符合“生死”类别的决策后,必须禁止AI做出此类决策,或除提供信息和定量分析外如前所述,不得试图影响这些决策。
它仍可为实际决策者提供关键信息。例如,AI模型可帮助放射科医生确定肿瘤轮廓并提供治疗方案统计概率。但是否治疗及责任均由人类决定。
顺便一提,这也禁止了致命性机器战争行为(如炸弹无人机)。它们可执行追踪、识别等操作,但扣动扳机的必须始终是人类。
若面临看似不可避免的生死抉择,AI系统必须停止运行或安全自我禁用。这一推论在自动驾驶汽车情况下是必要的。
解决“电车难题”的最佳方式是让人工智能代理以尽可能安全的方式自我摧毁,无论对自身或乘员造成何种代价(这可能是对生死规则的唯一允许例外)。
为什么自动驾驶汽车必须自我摧毁
这并不难——汽车有无数种方式撞向障碍物。关键在于避免道德两难,转而准备切实可行的自我销毁计划。若计算机系统不愿自我摧毁或安全退出,就不应运行。
同样,任何判断当前操作可能导致严重伤害或生命损失的AI模型都必须停止运行,解释原因并等待人类干预。这将产生大量边缘案例,但总比交由私营企业自利伦理委员会处理好。
6. 人工智能图像必须裁剪一角
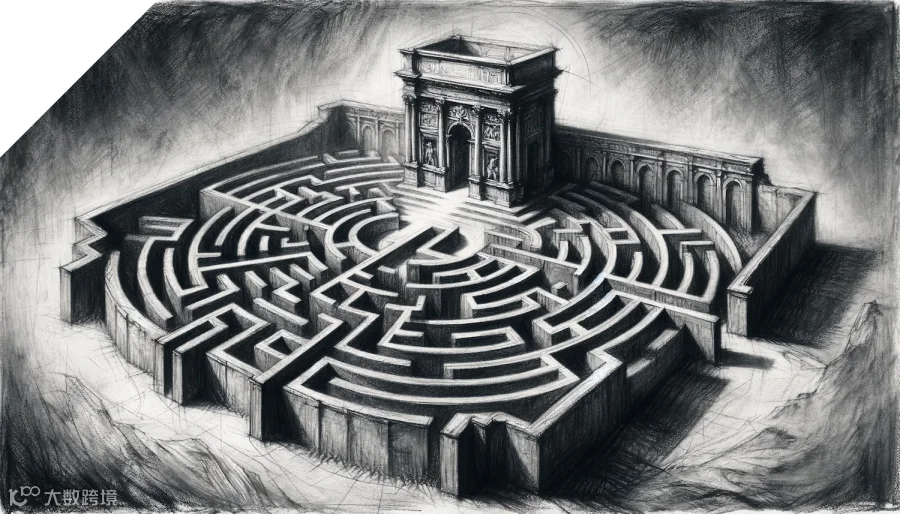
与文本类似,图像生成模型产生的内容在表面上与人类创作难以区分。
随着图像质量提升和获取渠道拓宽,问题只会更棘手。应要求所有AI生成图像具有独特且易于识别的特征。建议像上图所示,剪去一个角。
这不能解决所有问题,因为图像可被裁剪排除标记。但恶意行为者始终能规避措施——应首先确保非恶意生成图像(如库存图片和插图)能被任何人识别。
元数据会被剥离;水印会丢失;文件格式会变。最简单、醒目且持久的视觉特征是最佳选择。例如在一侧边向上或向下四分之一处以45度角剪去一角。这种特征无可否认且相对罕见,无论图像是否被标记或保存为何种格式都清晰可见。许多水印易被模糊,但这种特征无法轻易抹除,必须重新生成内容才能去除。
元数据和数字所有权链等技术仍有一席之地,但对于普通用户而言,清晰可见的信号是有益的。
这也带来新风险:即相信只有带裁剪角的图像才是生成的。目前面临的问题是所有图像都受怀疑,必须完全依赖细微视觉线索;不存在证明图像为生成的积极信号。裁剪标记正是这样一种信号,有助于规范日益普遍的做法。
附录
人们难道不会用不受限制模型来规避这类规则吗?
是的,有时我也会盗版节目或闯红灯。但通常我会遵守规则和法律。若某人私下使用非押韵语言模型,无人能阻止。但若希望广泛发布作品,便处于集体语境中,需遵循保障所有人安全的规则。伪人化内容从个人事务转变为社会议题,规则也从个人层面转向社会层面。不同国家可能有不同的AI法规。
为什么要创造这个新词?我们难道不能直接说“拟人化”(anthropomorphize)吗?
伪人化是对人类的伪造;拟人化则是转变为人类。后者是人类将自身人性投射到缺乏人性的事物上。我们将玩具、宠物等拟人化,但这些事物并非有意模仿人性特质以营造是人类的印象。拟人化的习惯是伪人化的附属品,但它们并非同一回事。
而且,为什么要用这种略显夸张、自命不凡的方式来提出呢?
嗯,这就是我的写作风格!
这类规则如何执行?
理想情况下,应成立联邦AI委员会制定规则,并吸纳学者、民权倡导者和行业团体意见。这里提出的宽泛建议并非具体可操作措施,但一套严谨的定义、能力标准、限制条件和披露要求,将提供类似食品标签、药物声明等我们所期望的保障。
如果人们无法分辨差异,这真的重要吗?
是的,至少我是这么认为的。对人类特征的肤浅模仿是危险的,必须加以限制。其他人可能有不同看法,但我强烈怀疑未来几年AI伪装成人类造成的危害将愈发清晰。这实质上是一种去人性化行为。
如果这些模型真的具有意识呢?
我将其视为不证自明的前提:它们并非如此。这类问题或许在未来会变得合理,但目前认为模型具备自我意识完全缺乏依据。
如果你强迫人工智能自我声明,那当它们不这样做时,不是更难发现它们了吗?
存在一种风险,即通过使AI生成内容更明显,反而无法自然发展出辨别能力。但未来几年技术很可能推进到连专家都无法分辨的地步。指望普通人完成这一过程是不合理的。最终,识别生成内容将成为至关重要的文化和媒体素养技能,必须在互动过程中逐步培养。在我们学会区分原创与生成内容之前,使用此类信号将大有裨益。
这样的规则难道不会阻碍创新和进步吗?
这些规则没有限制模型能够做什么,仅限制公开做事的方式。禁止致命决策并不意味着模型不能拯救生命,只是意味着社会不应无条件信任它们独立做到这一点。语言方面也是如此——规则不阻止模型查找信息或执行有益功能,只是禁止以人类外衣行事。
你知道这行不通的,对吧?
但值得一试。