


跟上人工智能等快速发展行业的步伐是一项艰巨任务。在AI替你完成之前,以下是机器学习领域近期动态的便捷汇总,涵盖未单独报道的重要研究与实验。
本周人工智能动态
谷歌暂停了其AI聊天机器人Gemini生成人物图像的功能。此前有用户投诉称其存在历史不准确问题:例如要求描绘“罗马军团”时,Gemini生成了时代错乱、卡通化且种族多元的步兵;而将“祖鲁战士”呈现为黑人。
谷歌与OpenAI等供应商似乎在后台实施了硬编码以“纠正”模型偏见。面对“只显示女性/男性图片”等提示,Gemini会拒绝执行,声称可能“加剧对其他性别的排斥和边缘化”。同时,它也不愿根据“白人”或“黑人”等种族标识生成人物,理由是“避免将个体简化为身体特征”。
右翼人士将此视为技术精英推行“觉醒”议程的证据。但更合理的解释是:谷歌曾因工具偏见受损(如将黑人男性误分类为大猩猩、误认热成像枪为武器),因此迫切希望避免重蹈覆辙,试图在图像生成中呈现更少偏见的世界——尽管这种做法可能矫枉过正。
反种族主义教育家罗宾·迪安戈在《白色脆弱性》中指出,种族的抹除(即“色盲”)有助于维持系统性种族权力失衡。假装“不看肤色”或认为仅承认其他种族的挣扎就足以标榜“觉醒”,通过避免实质性讨论,实际上延续了伤害。
谷歌对Gemini基于种族提示的谨慎处理,并非回避问题,而是虚伪地掩盖模型最严重的偏见。这些偏见不应被忽视,而应在更广泛的背景下解决——即从产生偏见的训练数据及互联网社会大背景出发。
用于训练图像生成器的数据集通常白人多于黑人,且关于黑人的图像常强化负面刻板印象。这导致图像生成器会对有色人种女性进行性化、将白人男性描绘为权威形象,并总体偏向富有的西方视角。
有人辩称AI供应商难以两全:无论是否处理偏见都会受批评。但这确实反映了模型在解释方面的不足——其呈现方式最小化了偏见显现的程度。
若AI供应商能以谦逊透明的语言直面缺陷,远比随意尝试“修复”本质上不可修复的偏见有效。我们每个人都有偏见,对待他人的方式并不相同,构建的模型亦然。承认这一点对我们大有裨益。
'令人尴尬且错误':谷歌承认失去对图像生成AI的控制
其他值得关注的AI新闻
- AI领域的女性:TechCrunch推出系列文章介绍AI领域杰出女性。
- Stable Diffusion v3:Stability AI宣布推出基于全新架构的最新、最强图像生成AI模型版本。
- Chrome获得生成式AI支持:Google在Chrome中推出Gemini驱动工具,允许用户重写网页文本或生成新内容。
- 比ChatGPT更“黑”:创意广告公司McKinney开发测验游戏《你比ChatGPT更“黑”吗?》,旨在揭示AI偏见。
- 呼吁立法:数百位AI知名人士签署公开信,呼吁美国出台反深度伪造(deepfake)立法。
- AI牵线良缘:OpenAI迎来新客户Match Group(拥有Hinge、Tinder等应用),员工将使用OpenAI技术完成工作任务。
- DeepMind的安全举措:谷歌旗下DeepMind成立“AI安全与对齐”新组织,扩大范围涵盖新的生成式AI研究人员和工程师专门小组。
- 开放模型:Google发布轻量级开放权重模型系列Gemma。
- 众议院特别工作组:美国众议院成立AI特别工作组,此举被视为多年犹豫不决后的推诿之举。
更多机器学习知识
AI模型似乎知道很多,但实际上它们一无所知。不过,若换种方式提问,它们似乎内化了类似人类知识的“含义”。虽然AI不理解猫或狗的本质,但可能在词嵌入表示中编码了不同于“猫与瓶子相似性”的感知。亚马逊研究人员证实了这一点。
研究比较了语义相似但语法不同的句子(如“狗对窃贼吠叫”vs“窃贼导致狗吠叫”)及语法相似但语义不同的句子(如“猫睡一整天”vs“女孩慢跑整个下午”)的内部轨迹。发现人类认为相似的句子在模型内部也被视为更相似,反之亦然。这表明LLM编码的含义比预期更稳健复杂,并非完全天真。
神经编码在假肢视觉方面表现出色。瑞士洛桑联邦理工学院(EPFL)研究发现,人工视网膜等方法因微电极阵列限制分辨率极低。团队发现机器学习在降采样优化方面表现优异。

Diego Ghezzi表示:“基于学习的方法在优化感官编码上效果更好。无约束神经网络甚至学会了自行模仿视网膜处理的某些方面。”这是一种感知压缩,已在小鼠视网膜上得到验证。
斯坦福研究人员分析了37,000幅儿童画作,评估其可识别度。发现让画作更易识别的原因不仅是标志性特征(如兔子耳朵)。
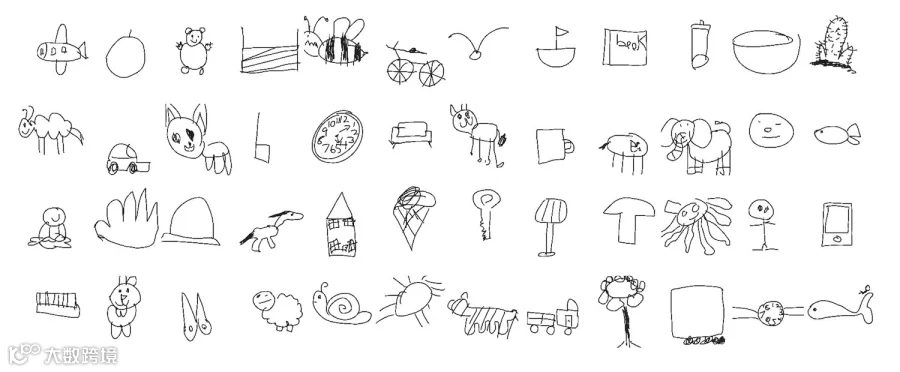
首席研究员Judith Fan指出:“使大龄儿童画作可识别的特征类型,并非由单一特征驱动,而是一个复杂过程,机器学习系统正在捕捉这一点。”
EPFL化学家发现,经少量训练后,LLM在协助工作方面表现出色。通过对海量文献微调,系统能针对特定是非题(如高熵合金相态)进行推断。Berend Smit表示:“查询基础模型可能成为启动项目的常规方式,就像文献检索一样简单。”
伯克利与EPFL联合研究发现,Google搜索结果中的图像比提及相同内容的文本更容易强化职业和词汇的性别刻板印象,且男性出现频率更高。观看图片的人比阅读文字的人更可靠地将角色与特定性别关联,这种影响持续数天。Douglas Guilbeault强调:“图像对人物形象的呈现具有文字不具备的强烈粘性和影响力。”
随着谷歌图像生成器争议发生,人们易忽视一个既定事实:许多AI模型数据来源存在严重偏见,并对现实产生真实影响。