


用于玩游戏的AI模型已有数十年历史,但它们通常只专精于某一款游戏,并且总是以获胜为目标。Google DeepMind的研究人员对其最新作品有着不同的目标:他们打造了一个能像人类一样游玩多款3D游戏的模型,同时也会尽力理解并执行你的口头指令。
当然,也有所谓的“AI”或计算机角色能够完成这类任务,但它们更像是游戏中的功能:NPC(非玩家角色),你可以通过正式的游戏内命令间接控制它们。
DeepMind 的 SIMA(可扩展指令多世界智能体)无法访问游戏的内部代码或规则;相反,它是通过大量人类玩游戏的视频进行训练的。基于这些数据——以及数据标注员提供的注释——该模型学会了将某些视觉表征与动作、物体和交互关联起来。他们还录制了玩家在游戏中互相指导操作的视频。
例如,它可能从屏幕上像素以某种模式移动的方式中学习到,这是一种被称为“向前移动”的动作;或者当角色接近一扇类似门的物体并使用看起来像门把手的物体时,那就是在“打开”一扇“门”。诸如此类简单的事情,即那些需要几秒钟但不仅仅是按下某个键或识别某物的任务或事件。
训练视频取自多款游戏,包括《Valheim》和《Goat Simulator 3》,这些游戏的开发者参与并同意将其软件用于此用途。研究人员在一次媒体通话中表示,主要目标之一是观察训练 AI 玩一组游戏是否能使它能够玩其他未曾见过的游戏,这一过程称为泛化。
答案是肯定的,但有保留条件。在多款游戏中训练的 AI 智能体在未接触过的游戏中表现更好。但当然,许多游戏涉及特定且独特的机制或术语,这会让准备最充分的 AI 也受阻。除非缺乏训练数据,否则没有什么能阻止模型学习这些内容。
部分原因在于,尽管游戏内有大量行话,但真正影响游戏世界的“动词”其实数量有限。无论你是搭建简易棚屋、搭帐篷还是召唤魔法庇护所,本质上你都是在“建造房屋”,对吧?因此,当前智能体识别出的几十种基本原语映射表非常值得浏览:
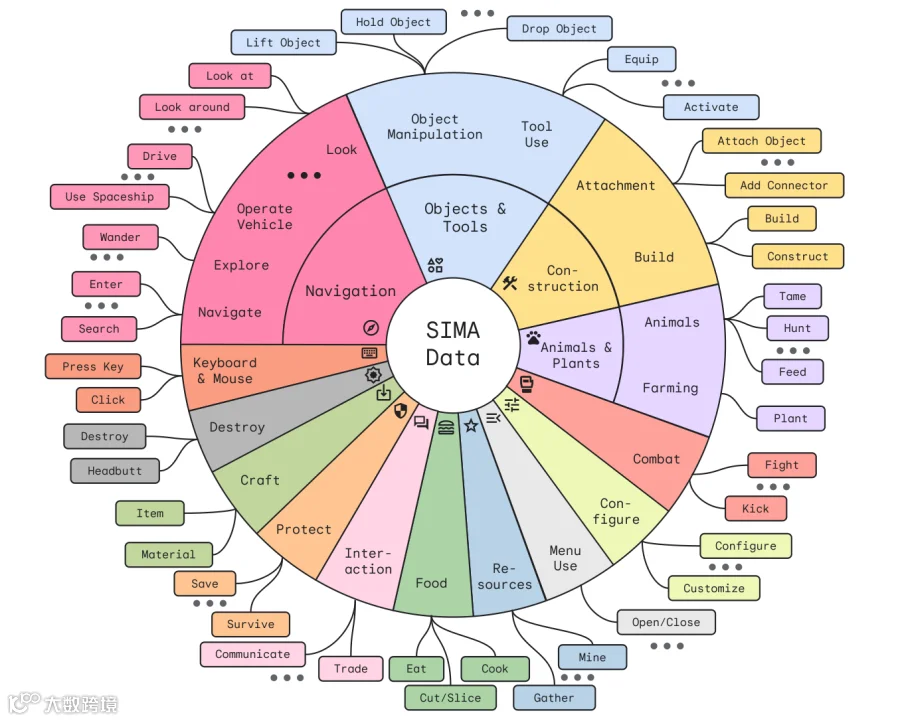
研究人员的目标不仅是从根本上推动基于智能体的 AI 发展,还要创造出比今天我们使用的僵硬、硬编码的智能体更自然的游戏伙伴。
项目负责人之一 Tim Harley 表示:“与其拥有一个与你对抗的超人类智能体,你可以让 SIMA 作为你的合作玩家站在你身边,你可以向他们发出指令。”
因为当他们玩游戏时,他们看到的只是游戏屏幕上的像素,所以他们必须以与我们相似的方式学习如何做事——这也意味着他们能够适应并产生涌现行为。
你可能好奇,这种方法与构建代理型人工智能的常见方法——模拟器方法相比如何。在模拟器方法中,一个几乎无监督的模型在一个比实时运行速度更快的3D模拟世界中进行大量实验,从而能够直观地学习规则,并围绕这些规则设计行为,而无需大量的标注工作。
Harley告诉TechCrunch:“传统的基于模拟器的智能体训练使用强化学习进行训练,这需要游戏或环境为智能体提供‘奖励’信号以供其学习——例如围棋或星际争霸中的胜负情况,或是Atari游戏中的‘分数’。”他指出,这种方法曾应用于这些游戏并取得了非凡的成果。
DeepMind的Agent57 AI代理能在57款Atari游戏中击败人类玩家
“在我们使用的游戏中,比如我们合作伙伴的商业游戏,”他继续说道,“我们无法获得这样的奖励信号。此外,我们感兴趣的是能够执行开放文本中描述的多种任务的代理——为每个可能的目标评估‘奖励’信号对每款游戏来说都不可行。相反,我们使用基于人类行为的模仿学习来训练代理,并以文本形式提供目标。”
换句话说,严格的奖励结构可能会限制代理所追求的目标,因为如果它由分数引导,它将永远不会尝试任何不能最大化该值的行为。但如果它重视更抽象的东西,比如其动作与之前观察到的有效动作有多接近,那么只要训练数据以某种方式代表它,就可以训练它“想要”做几乎所有事情。
其他公司也在探索这种开放式的协作与创造;例如,人们正认真审视与非玩家角色(NPC)的对话,将其视为让类似大型语言模型(LLM)的聊天机器人发挥作用的机会。此外,一些关于智能体的非常有趣的研究中,AI还在模拟和追踪简单的即兴动作或互动。
研究人员用AI填充了一个微型虚拟小镇(而且非常温馨)
当然,还有针对如MarioGPT等无限游戏的实验,但那是另一回事了。