


人工智能轻松通过SAT考试,击败国际象棋特级大师,调试代码也毫不费力。但如果你让AI和初中生参加拼写比赛,它被淘汰的速度比你念出“扩散”这个词还要快。
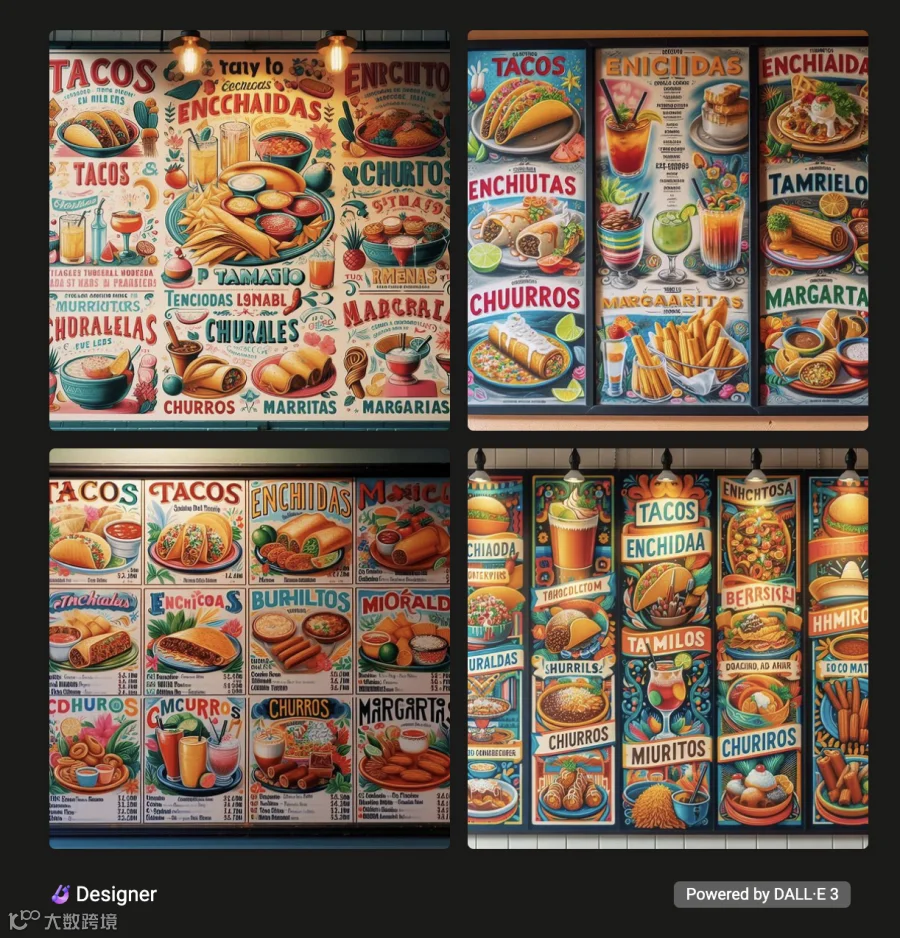
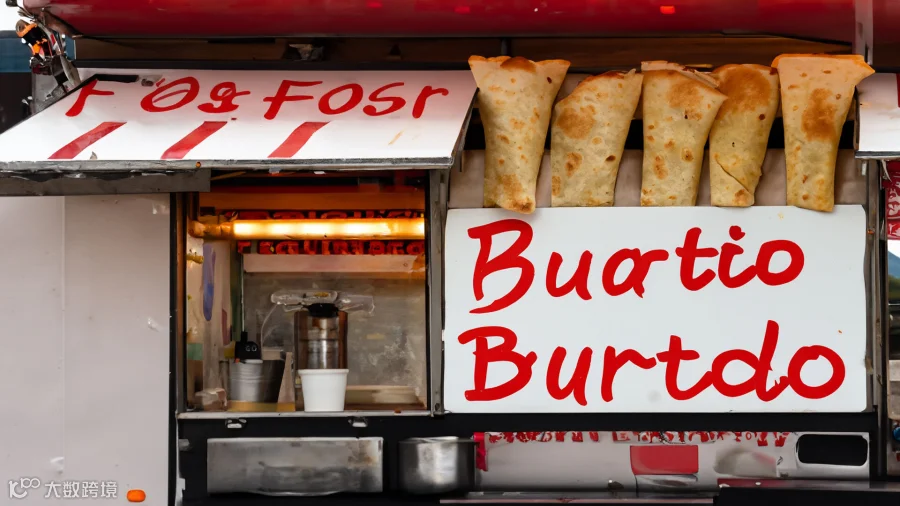
尽管我们在人工智能领域取得了所有进步,但它仍然不会拼写。如果你要求DALL-E等文生图工具为一家墨西哥餐厅创建菜单,你可能会在一大堆乱码中看到一些看似诱人的菜品,比如“taao”、“burto”和“enchida”。
虽然ChatGPT可能能帮你写论文,但当提示它生成一个不包含字母“A”或“E”的10个字母的单词时,它就显得滑稽地无能了(它告诉我答案是“balaclava”)。与此同时,当一位朋友尝试使用Instagram的AI生成一个写着“new post”的贴纸时,它生成的图像看起来像是说了一些我们不能在TechCrunch这个家庭友好型网站上重复的内容。
“图像生成器在生成汽车和人脸等物体时表现要好得多,而在手指和手写体等较小细节上则较差,”Lesan联合创始人、DAIR Institute研究员Asmelash Teka Hadgu表示。
图像和文本生成器背后的底层技术不同,但这两类模型在拼写等细节问题上有着相似的困难。图像生成器通常使用扩散模型,从噪声中重建图像。至于文本生成器,大型语言模型(LLM)似乎像人脑一样阅读并响应你的提示——但实际上,它们使用的是复杂的数学运算,将提示的模式与其潜在空间中的模式进行匹配,从而用答案延续该模式。
Hagdu告诉TechCrunch:“扩散模型是用于图像生成的最新一类算法,它们正在重建给定的输入。”“我们可以假设图像上的文字只占非常、非常小的一部分,因此图像生成器学习的是覆盖更多像素的模式。”
这些算法被激励去重现其训练数据中看到的类似内容,但它们并不原生地知道我们习以为常的规则——比如“hello”不是拼写成“heeelllooo”,而且人手通常有五个手指。
阿尔伯塔大学的人工智能研究员兼助理教授Matthew Guzdial表示:“就在去年,所有这些模型在手指方面都非常糟糕,而这与文本问题完全相同。”“它们在局部处理上变得非常出色,所以如果你看到一只长着六根或七根手指的手,你可能会说:‘哇,那看起来像一根手指。’同样,对于生成的文本,你可以说,那看起来像个‘H’,这看起来像个‘P’,但它们在将这些整体结构组合在一起方面真的很差。”
工程师可以通过用专门设计用于教AI手部外观的训练模型来增强数据集,从而缓解这些问题。但专家不认为这些拼写问题会很快得到解决。
“你可以想象做类似的事情——如果我们生成大量文本,就可以训练一个模型来尝试识别什么是好、什么是坏,这或许能带来一些改进。但不幸的是,英语非常复杂,”Guzdial对TechCrunch表示。而当你考虑到AI需要学习处理多少种不同的语言时,这个问题变得更加复杂。
一些模型,比如Adobe Firefly,被教导完全不要生成文字。如果你输入诸如“餐厅菜单”或“带有广告的广告牌”这样简单的提示,你会得到一张餐桌上的空白纸张图片,或者高速公路上的一块白色广告牌。但如果你在提示中加入足够多的细节,这些限制措施就很容易被绕过。
“你几乎可以把这看作是在玩打地鼠游戏,比如‘好吧,很多人对我们的手有抱怨——我们给下一个模型增加一项专门针对手的改进’,如此类推,”Guzdial说。“但文字要难得多。正因如此,就连ChatGPT也无法正确拼写。”
在Reddit、YouTube和X平台上,有几个人上传了视频,展示了ChatGPT在创作ASCII艺术时的拼写失败情况;这是一种早期互联网艺术形式,利用文本字符来创建图像。在最近一段被称为“提示工程英雄之旅”的视频中,有人 painstakingly 试图引导ChatGPT创作出显示“Honda”字样的ASCII艺术,最终虽然成功了,但过程却充满了奥德赛般的艰难险阻。
天哪。
by u/debiEszter in ChatGPT
“我对此的一个假设是,它们的训练数据中缺乏大量的ASCII艺术,”Hagdu说。“这是最简单的解释。”
但归根结底,LLM根本不了解字母是什么,即使它们能在几秒钟内写出十四行诗。
“LLM基于Transformer架构,值得注意的是,它实际上并没有在阅读文本。当你输入提示时,它会被转换成一种编码,”Guzdial说。“当它看到单词‘the’时,它有一个代表‘the’含义的编码,但它并不知道‘T’、‘H’、‘E’分别是什么。”
这就是为什么当你要求ChatGPT生成不含字母“O”或“S”的八个字母长的单词列表时,它大约有一半的时间会出错。它实际上并不了解什么是“O”或“S”(尽管它可能能给你背诵关于该字母的维基百科历史)。
虽然这些DALL-E生成的糟糕餐厅菜单图片很有趣,但AI的这些缺陷在识别虚假信息时却很有用。当我们试图判断一张可疑的图片是真实拍摄还是AI生成时,通过观察路牌、印有文字的T恤、书页或任何可能出现随机字母串的地方,我们可以获得很多线索,从而揭示图像的合成来源。而在这些模型变得更擅长绘制手指之前,第六根(或第七根、第八根)手指也可能是一个破绽。
但Guzdial表示,如果我们看得足够仔细,AI出错的不仅仅是手指和拼写问题。
“这些模型一直在制造各种微小的局部问题——只是我们对其中一些问题特别敏感,容易察觉,”他说。
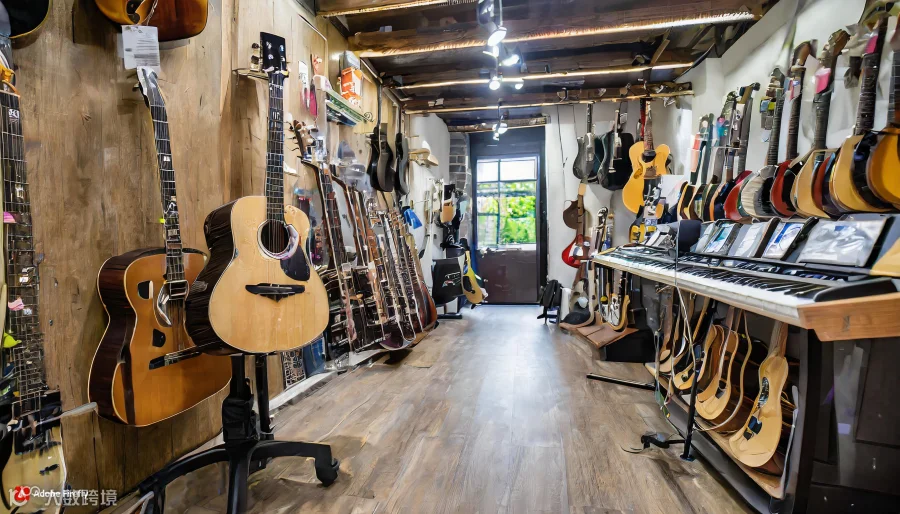
例如,对于普通人来说,一张由AI生成的音乐商店图片可能很容易让人相信。但一位懂音乐的人看到同一张图片时,可能会注意到有些吉他有七根琴弦,或者钢琴黑白键的间距不正确。
尽管这些人工智能模型的进步速度令人震惊,但这些工具仍难免会遇到此类问题,从而限制了该技术的能力。
“这确实是实实在在的进展,毫无疑问,”哈格杜表示,“但这项技术所引发的炒作简直疯狂到了极点。”
本周AI动态:Midjourney押注其能战胜版权执法机构