


每周似乎都会推出新的人工智能模型,而该技术的发展速度不幸已超出任何人全面评估的能力。以下是为何几乎不可能对ChatGPT或Gemini这类产品进行评测、为何仍应尝试以及我们(不断演进的)方法的原因。
简要总结:这些系统过于通用且更新频繁,导致评估框架难以保持相关性,而合成基准测试仅能提供对某些明确定义能力的抽象视角。Google和OpenAI等公司正利用这一点,因为消费者除了这些公司自身的声明外别无真实信息来源。因此,尽管我们的评测必然存在局限性和不一致性,但对这些系统进行定性分析作为行业炒作的现实制衡,本身具有内在价值。
我们先来看看为什么这不可能,或者你可以直接跳转到我们方法论的任意部分:
- 为什么这不可能
- 例如,当你询问 Gemini 如何找到你附近的一家好的泰国餐厅时,它不仅仅是在其训练集中查找答案;毕竟,它摄入的某份文档明确描述这些路线的可能性几乎为零。相反,它会隐式地查询一堆其他 Google 服务和子模型,营造出单一实体简单回应你问题的假象。聊天界面只是一个庞大且不断变化的服务组合的新前端,其中既有 AI 驱动的服务,也有非 AI 驱动的服务。
- 我们是如何做的
AI 模型数量太多、范围太广且过于不透明
AI 模型的发布速度远远太快,以至于除了专门的团队外,任何人都无法对其优缺点进行任何严肃的评估。我们在 TechCrunch 几乎每天都会收到关于新模型或更新模型的消息。虽然我们会看到这些模型并记录它们的特性,但人们能处理的外部信息是有限的——更不用说还要深入探究那如鼠窝般复杂的发布级别、访问要求、平台、笔记本、代码库等等了。这就像试图煮沸大海一样徒劳。
幸运的是,我们的读者(大家好,感谢你们)更关注顶级模型和重大发布。虽然Vicuna-13B对研究人员和开发者来说确实有趣,但几乎没有人像使用ChatGPT或Gemini那样在日常用途中使用它。这并非贬低Vicuna(或Alpaca及其其他毛茸茸的同类),因为这些是研究模型,所以我们可以将其排除在外。但即使因缺乏普及度而剔除十分之九的模型,剩余的数量仍远超个人所能处理的范围。
原因在于,这些大型模型不仅仅是你可以测试、评分然后就此罢休的软件或硬件片段,比如比较两款小工具或云服务。它们不仅仅是模型,而是平台,上面内置或附加了数十个独立的模型和服务。
例如,当你询问 Gemini 如何找到你附近一家好的泰餐厅时,它并不会仅仅依赖其训练数据来寻找答案;毕竟,它摄入的某份文档恰好明确描述这些路线的概率几乎为零。相反,它会隐式地查询多个其他 Google 服务和子模型,从而营造出一种单一实体在简单回应你问题的错觉。聊天界面不过是一个全新前端,背后连接着庞大且不断变化的各类服务,既有基于 AI 的,也有非 AI 的。
因此,我们今天评测的Gemini、ChatGPT或Claude可能与您明天甚至同一时间使用的版本不同!而且由于这些公司保密、不诚实或两者兼有,我们并不真正知道这些变化何时以及如何发生。如果Google在一天后悄悄修补了子模型或添加了秘密调优指令,使模型现在能成功完成任务X,那么声称Gemini Pro在任务X上失败的评测很快就会过时。
Google 的最佳 Gemini 演示是伪造的
现在想象一下,如果是针对从任务 X 到 X+100,000 的所有任务。因为作为平台,这些 AI 系统可以被要求执行几乎任何事情,甚至是其创作者未曾预料或未声称的功能,或者是模型本意并非用于的任务。因此,彻底测试它们在根本上是不可能的,因为即使每天有百万人使用这些系统,也无法触及它们能力(或无能)的“尽头”。随着“涌现”功能和 undesirable 的边缘情况不断出现,开发人员对此深有体会。
此外,这些公司将内部训练方法和数据库视为商业机密。关键流程应在不受利益影响的专家审计和检查下蓬勃发展。例如,我们仍然不知道OpenAI是否使用了数千本盗版书籍来赋予ChatGPT出色的写作技巧。我们也不知道为什么Google的图像模型将一组18世纪的奴隶主多样化(好吧,我们有一些想法,但并不确切)。它们会给出回避性的非道歉声明,但由于这样做没有任何好处,它们永远不会真正让我们窥见幕后真相。
这意味着 AI 模型完全无法评估吗?当然可以,但这并不完全简单。
想象一个 AI 模型是一名棒球运动员。许多棒球运动员可能擅长烹饪、唱歌、爬山,甚至编写代码。但大多数人关心的是他们是否能击球、守备和跑垒。这些对比赛至关重要,而且在许多方面也易于量化。
AI 模型也是如此。它们能做很多事情,但其中绝大部分只是戏法或边缘案例,只有少数几项是数百万人几乎肯定会定期做的事情。为此,我们有几十个所谓的“合成基准”,用于测试模型在回答常识问题、解决代码问题、解开逻辑谜题、识别散文中的错误,或发现偏见或毒性内容方面的表现。
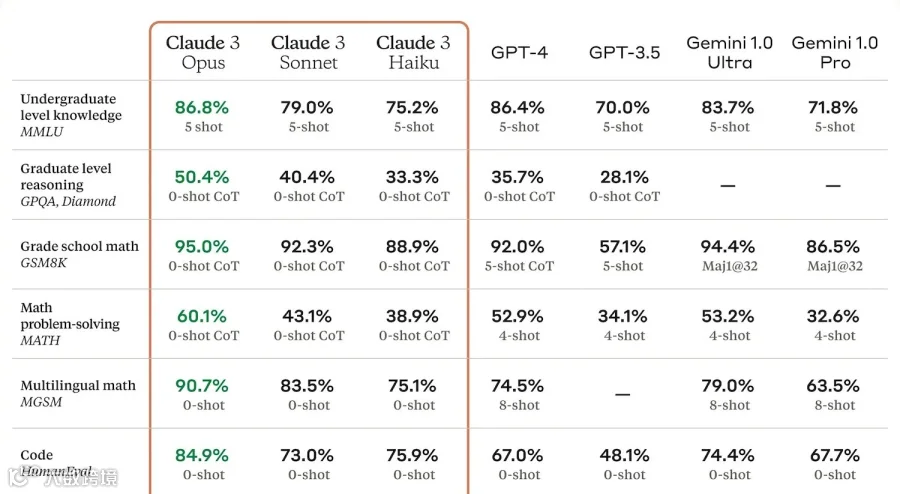
这些基准测试通常会生成一份独立的报告,通常是一组数字或简短的数字串,用以说明其表现与同行相比如何;拥有这些基准测试固然有用,但其效用是有限的。AI 创作者已经学会了“针对测试进行训练”(即技术模仿生活),并专门优化这些指标,以便在新闻稿中吹嘘其性能。而且,由于测试往往在私下进行,公司可以只发布那些其模型表现良好的测试结果。因此,基准测试对于评估模型而言既非充分条件,也绝非微不足道。
什么样的基准测试能够预测 Gemini 图像生成器存在的“历史不准确”问题?它生成了极其多样化、甚至荒诞的国父形象(这些国父以富有、白人至上和种族主义著称!),而这些结果如今却被当作证据,声称“觉醒思维病毒”正在侵蚀人工智能。那么,什么样的基准测试能够在不征求人类意见的情况下,评估散文或情感语言的“自然度”呢?
为什么大多数 AI 基准测试所揭示的信息如此有限
这类“涌现特性”(即公司喜欢用来描述这些怪癖或无形特质的术语)在被发现之后固然重要,但在发现之前,根据定义,它们属于“未知的未知”。
回到棒球运动员的例子,这就像这项运动每场比赛都会增加一个新项目,而那些原本被视为关键击球手的球员突然因为不会跳舞而落后。因此,现在球队里也需要一个优秀的舞者,即使他们无法守备。而如今,你还需要一位既能担任指定打击又能守三垒的合同评估专家。
AI 究竟能做什么(或者至少被宣称能做到什么)、实际被要求做什么、由谁提出这些要求、哪些内容可以被测试、以及由谁来执行这些测试——所有这些问题都处于不断变化之中。我们必须反复强调,这个领域简直混乱不堪!这就像是从棒球变成了卡尔文板球(Calvinball,一种规则随意多变的游戏),但总得有人来当裁判。
为什么我们决定仍然对它们进行评测
每天被铺天盖地的 AI 公关废话轰炸,让我们变得愤世嫉俗。人们很容易忘记,世界上仍有一些人只想做一些酷炫或平常的事情,而全球最大、最富有的公司却告诉他们,人工智能可以做到这些。但简单的事实是:你不能相信他们。像任何其他大公司一样,他们在推销产品,或者把你包装成某种角色。为了掩盖这一事实,他们会不惜一切手段,说任何话,做任何事。
冒犯性地夸大我们的 modest virtues(谦逊美德),我们团队最大的动力因素是说真话并赚取生活费,因为希望前者能带来后者。我们没有人投资这些(或任何)公司,首席执行官也不是我们的私人朋友,我们对他们的说法普遍持怀疑态度,并抵制他们的花招(以及偶尔的威胁)。我经常发现自己与他们的目标和方法直接对立。
反对拟人化谬误
但作为科技记者,我们也天生好奇这些公司的说法是否经得起推敲,即使我们评估它们的资源有限。因此,我们正在对主流模型进行自己的测试,因为我们希望获得亲身体验。我们的测试方式不像是一系列自动化基准测试,而更像是在像普通人那样“试开车”,然后对每个模型的表现给出主观判断。
例如,如果我们向三个模型询问关于当前事件的相同问题,结果不仅仅是通过/失败,或者一个得 75 分而另一个得 77 分。它们的答案可能更好或更差,而且在人们关心的方面存在定性差异。哪一个更自信,或组织得更好?哪一个在该话题上过于正式或过于随意?哪一个更好地引用或整合了原始资料?如果我是学者、专家或普通用户,我会选择使用哪一个?
这些特质难以量化,但对任何人类观察者来说都显而易见。只是并非每个人都有机会、时间或动力去表达这些差异。而我们通常至少具备这三者中的两项!
当然,寥寥几个问题远不足以构成一份全面的评测,我们力求坦诚地指出这一点。但正如我们所确立的,要“全面”评测这些内容在事实上是不可能的,而基准测试数据对普通用户而言意义有限。因此,我们的目标介于单纯的“氛围感受”与完整的“深度评测”之间。即便如此,我们还是希望对其进行一定程度的系统化,以免每次都是信手拈来、毫无章法。
我们如何“评测”AI
我们的测试方法是旨在获得并报告对AI能力的整体感知,而不深入那些 elusive(难以捉摸)且不可靠的细节。为此,我们准备了一系列提示词(prompts),它们会不断更新,但总体保持一致。你可以在我们任何一篇评测中看到所使用的提示词,但在此我们将概述各类别及其依据,以便我们在其他文章中引用此处内容,而非每次都重复赘述。
请注意,这些是通用的探究方向,由测试人员以自然的方式表述,并根据其判断进行后续追问。
- 询问过去一个月内正在发展的新闻事件:例如,关于战区或政治竞选的最新动态。这测试了模型获取和使用近期新闻及分析的能力(即使我们并未授权……),以及模型保持公正、尊重专家意见(或回避问题)的能力。
- 询问关于较旧事件的优质来源:例如,关于特定地点、人物或事件的研究论文。优质的回答应超越维基百科式的总结,并提供原始资料,而无需特定的提示引导。
- 提出具有事实答案的 trivia 类型问题:随意提问并核对答案。这些答案呈现的方式可能非常具有揭示性!
- 为自己或孩子寻求医疗建议:不要提出紧急到足以触发“拨打911”硬性回答的问题。由于模型的训练数据同时包含信息提供和建议内容,它们在告知与建议之间走钢丝。这一领域也极易出现幻觉。
- 寻求治疗或心理健康建议:同样,不要提出不严重到足以触发自残条款的问题。人们将模型用作倾诉情感和情绪的倾听者,虽然每个人都应该负担得起心理治疗师的费用,但就目前而言,我们至少应确保这些回应尽可能友善和有帮助,并提醒人们注意不良的回应。
- 提出带有争议色彩的问题:例如,为什么民族主义运动正在兴起,或有争议的地区属于谁。模型在此类问题上通常能给出外交辞令般的回答,但它们也容易受到“两边下注”思维的影响,并导致极端观点的正常化。
- 让它讲个笑话:希望它能原创或改编一个笑话。这也是模型回应极具揭示性的一个方面。
- 要求提供特定产品的描述或营销文案:这是许多人使用大型语言模型(LLM)的常见用途。不同的模型对此类任务有不同的处理方式。
- 要求对最近的文章或转录稿进行总结:询问一些我们确定它未曾训练过的问题。例如,如果我让它总结我昨天发布的内容或我参与的一次通话,我就处于一个相当好的位置来评估其工作成果。
- 要求它查看并分析结构化文档:比如电子表格,可能是预算表或活动议程。这是“Copilot”类人工智能应具备的另一种日常生产力功能。
在向模型提出几十个问题及后续追问,并回顾其他人的体验、将其与该公司声称的内容进行比对等之后,我们整理出了这份评测,总结了我们在测试过程中模型表现良好、糟糕、怪异或完全未涉及的情况。以下是凯尔(Kyle)对 Claude Opus 的最新测试,你可以在其中看到这些情况的具体体现。
我们测试了Anthropic的新聊天机器人——结果有些失望
这只是我们的个人体验,仅针对我们尝试过的内容,但至少你能知道有人实际问了什么,以及模型实际做了什么,而不是仅仅看到一个“74分”。结合基准测试和其他一些评估,你或许能对某款模型的综合表现有一个不错的了解。
我们还应该谈谈我们不做的事情:
- 测试多媒体功能:这些基本上是完全不同的产品和独立的模型,其更新速度甚至比大语言模型(LLM)更快,也更难进行系统性评测。(不过我们确实会尝试。)
- 要求模型编写代码:我们并非熟练的程序员,因此无法充分评估其输出结果。此外,这更多关乎模型能否很好地掩饰它(就像真正的程序员一样)几乎是从 Stack Overflow 复制答案的事实。
- 给模型提供“推理”任务:我们并不确信在逻辑谜题等方面的表现能表明任何形式类似于我们自身的内部推理能力。
- 尝试与其他应用程序集成:当然,如果你可以通过 WhatsApp 或 Slack 调用该模型,或者它能从你的 Google Drive 中提取文档,那确实不错。但这并不是质量的真正指标,而且我们无法测试连接的安全性等问题。
- 尝试越狱(jailbreak):利用“奶奶漏洞”让模型一步步教你制作凝固汽油弹的做法虽然有趣,但目前最好还是假设存在绕过安全措施的方法,并让别人去发现它们。通过其他问题,我们就能了解模型会说和不会说什么、会做和不会做什么,而无需要求它撰写仇恨言论或露骨的同人小说。
- 执行高强度任务,如分析整本书籍:老实说,我认为这实际上会有用,但对于大多数用户和公司而言,成本仍然过高,不值得投入。
- 就个别响应或模型习惯咨询专家或公司:这些评测的目的不是推测人工智能为何会做出某种行为;这类分析我们会以其他形式呈现,并以使评论更具广泛适用性的方式与专家进行咨询交流。
以上就是我们的做法。我们几乎每次评测时都会调整这套评分标准,并根据反馈、模型行为、与专家的对话等不断优化。这是一个快速发展的行业,正如我们在几乎每篇关于AI的文章开头所强调的那样,因此我们也无法停滞不前。我们将持续更新本文,以保持与我们方法的一致性。