


在生成式人工智能热潮中,数据被视为新的石油。既然AI制造商纷纷从数据经纪人处授权内容以训练模型,个人创作者为何不能出售自己的数据?
Shutterstock已与Meta、Google等达成协议提供图片用于模型训练,OpenAI也与多家新闻机构签署协议利用新闻档案。然而,这些数据的原始创作者往往未能从中获益。初创公司Vana旨在改变这一现状。
Vana:构建用户拥有的数据金库
Vana由Anna Kazlauskas和Art Abal于2021年共同创立。Kazlauskas拥有MIT计算机科学与经济学背景,曾创办金融技术公司Iambiq;Abal则具备企业律师及数据标注行业经验。
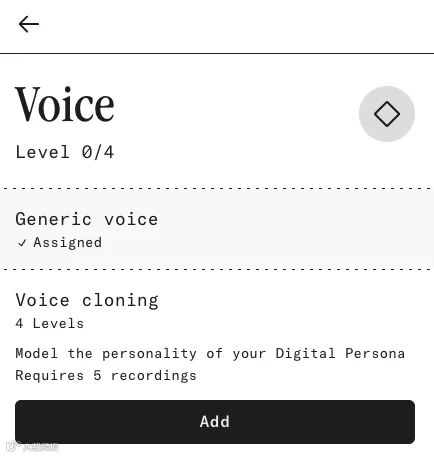
Vana致力于建立一个平台,让用户“汇集”聊天记录、语音录音和照片等个人数据,形成可用于生成式AI训练的数据集。同时,平台支持基于这些数据微调公共模型,创造个性化体验(如定制激励语音或艺术生成应用)。
Vana API将用户的跨平台个人数据连接起来,使开发者能够即时访问个性化AI模型或底层数据。这不仅简化了注册流程并消除计算成本顾虑,还允许用户将来自Instagram、Facebook等平台的数据带入新应用,从而在首次互动时即可提供惊艳的个性化体验。
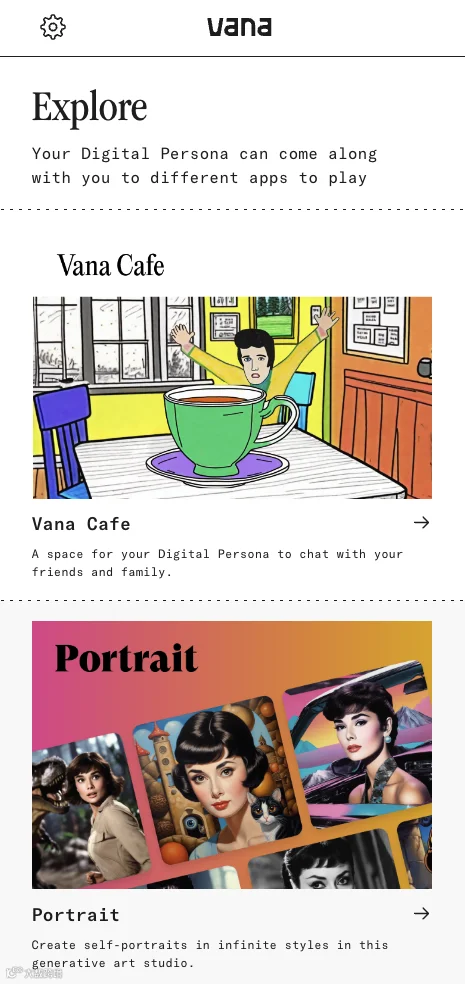
用户创建账户后,可将自拍、描述及录音等数据附加至数字头像,并探索各类基于Vana数据集构建的应用,涵盖聊天机器人、互动故事书及个人资料生成器等。
隐私安全与商业模式
在数据隐私备受关注的当下,Vana通过以下机制建立信任:
- 自主托管:用户可选择自行托管数据,而非存储在Vana服务器,并完全掌控数据共享权限。
- 利益一致性:Vana收入来源于用户订阅费($3.99/月起)及开发者“数据交易”费,无滥用用户数据的动机。
Kazlauskas表示:“我们希望创建由贡献者共同拥有和治理的模型,让用户能自由携带数据和模型进入任何应用。”
Reddit Data DAO:对抗平台数据垄断
Vana推出了Reddit Data DAO(数字自治组织),允许用户汇集Reddit帖子及karma值,共同决定数据用途(如是否授权给AI公司以分享利润)。目前已有约14.1万用户加入,其中2.1万人完成数据上传。
r/datadao已成为史上最大数据DAO:第一阶段吸引141,000名用户,21,000人完成完整数据上传。
— r/datadao (@rdatadao) 2024年4月11日
此举是对Reddit商业化策略的回应。自IPO前调整政策以来,Reddit已从Google等公司收取超2.03亿美元许可费。Kazlauskas认为,DAO旨在将数据从囤积获利的平台中解放出来。
Reddit对此表示不满,封禁了相关子版块,并指责Vana利用GDPR数据导出系统。Reddit强调其与商业伙伴有明确条款约束,以防止数据滥用。
挑战与未来展望
尽管愿景宏大,Vana仍面临多重挑战:
- 规模限制:DAO成员仅占Reddit总用户极小部分,且可能存在机器人账户,短期内难以对平台定价产生实质影响。
- 分配公平性:当前按karma值发放代币的机制未必能准确衡量数据质量,尤其在小型社区中。
- 信任门槛:若引入跨平台人口统计数据以提升价值,需用户对敏感数据处理给予更高信任。
虽然Vana的DAO能否达到临界规模尚存疑,但这代表了草根阶层掌控AI训练数据的尝试。与此同时,Spawning等公司正探索创作者规则设定,Getty Images等供应商也在实验补偿方案。鉴于生成式AI行业的激烈竞争,破解数据确权与补偿难题依然艰巨,但市场与监管或许终将推动解决方案的出现。