


跟上人工智能这样快速发展的行业是一项艰巨的任务。因此,在AI能够为你做到这一点之前,这里有一份关于机器学习领域近期故事的实用汇总,以及我们未单独报道的值得注意的研究和实验。
本周,Meta发布了其Llama系列最新一代生成式AI模型:Llama 3 8B和Llama 3 70B。这些模型能够分析和撰写文本,Meta表示它们是“开源”的——旨在成为开发者在设计具有独特目标系统时的“基础组件”。
“我们相信这些是同类中最好的开源模型,毫无疑问。”Meta在一篇博客文章中写道,“我们正拥抱尽早并频繁发布的开源精神。”
唯一的问题是:Llama 3模型并非真正开源,至少在最严格的定义下不是。
开源意味着开发者可以不受限制地按自己的意愿使用模型。但在Llama 3(以及Llama 2)的情况下,Meta施加了某些许可限制。例如,Llama模型不能用于训练其他模型;月活跃用户超过7亿的App开发者必须向Meta申请特殊许可证。
研究:伪“开源”AI模型的隐患
由卡内基梅隆大学、AI Now研究所和Signal基金会的研究人员共同撰写的研究发现,许多标榜为“开源”的AI模型存在重大限制——不仅仅是Llama。用于训练模型的数据被保密;运行它们所需的计算能力超出了许多开发者的能力范围;而微调它们所需的人力成本也高得令人望而却步。
那么,如果这些模型并非真正的开源,它们究竟是什么呢?这是一个好问题;就人工智能而言,定义开源并不是一件容易的事。
一个相关的未决问题是,作为开源许可所基于的基础知识产权机制的版权,能否应用于AI项目的各个组成部分和片段,特别是模型的内部结构(例如嵌入向量)。此外,还需要克服人们对开源的认知与AI实际运作方式之间的不匹配:开源的部分设计初衷是确保开发者可以不受限制地研究和修改代码,然而对于AI来说,你需要哪些要素来进行研究和修改则存在解释空间。
在拨开所有不确定性之后,卡内基梅隆大学的研究确实阐明了像Meta这样的科技巨头挪用“开源”这一短语所带来的固有危害。通常,像Llama这样的“开源”AI项目最终会引发新闻周期的关注——这相当于免费营销——并为项目的维护者提供技术和战略利益。开源社区很少看到同样的利益,即使看到了,与维护者相比也是微不足道的。
该研究的合著者表示,与其说是实现AI的民主化,“开源”AI项目——尤其是那些来自大型科技公司的项目——往往倾向于巩固和扩大集中化的权力。下次当主要的“开源”模型发布时,这一点值得牢记。
过去几天里其他值得关注的AI故事
- Meta更新其聊天机器人:恰逢Llama 3发布,Meta升级了其Facebook、Messenger、Instagram和WhatsApp上的AI聊天机器人Meta AI,采用了基于Llama 3的后端。它还推出了新功能,包括更快的图像生成和对网页搜索结果的访问。
- AI生成的色情内容:Ivan撰文探讨了监督委员会(Meta半独立的政策委员会)如何关注该公司社交平台处理明确AI生成图像的问题。
- Snap水印:社交媒体服务Snap计划在其平台上为AI生成的图像添加水印。带有闪光表情的半透明Snap标志将成为新的水印,并添加到从该应用程序导出或保存到相机胶卷的任何AI生成图像上。
- 新一代Atlas:现代汽车旗下的机器人公司波士顿动力(Boston Dynamics)推出了其下一代人形Atlas机器人,与之前依靠液压驱动的前代产品相比,这款新机器人完全采用电力驱动,而且外观更加友好。
- 人形机器人上的新尝试:不甘落后的Mobileye创始人Amnon Shashua推出了一个新的初创公司MenteeBot,专注于构建双足机器人系统。演示视频显示,MenteeBot的原型机走到桌子旁并拿起水果。
- Reddit的翻译功能:在接受Amanda采访时,Reddit首席产品官Pali Bhat透露,一项旨在将社交网络推向更全球受众的AI驱动语言翻译功能正在开发中,同时还有一款基于Reddit版主过去决策和行动训练的辅助审核工具。
- AI生成的LinkedIn内容:LinkedIn悄然开始测试一种增加收入的新方式:LinkedIn Premium Company Page订阅,费用高达每月99美元,其中包括用于撰写内容的AI以及一套增长粉丝数量的工具。
- 风向标项目:谷歌母公司Alphabet的“登月工厂”X本周发布了Project Bellwether,这是其最新一次尝试利用技术解决世界最大问题的举措。在这里,这意味着使用AI工具尽可能快地识别野火和洪水等自然灾害。
- 用AI保护儿童:负责执行英国《在线安全法》的监管机构Ofcom计划启动一项探索,研究如何利用AI和其他自动化工具主动检测和删除网上的非法内容,特别是为了保护儿童免受有害内容的影响。
- OpenAI进军日本:OpenAI正在扩展至日本市场,开设新的东京办公室,并计划推出专门针对日语优化的GPT-4模型。
更多机器学习见解
聊天机器人能改变你的想法吗?瑞士研究人员发现,它们不仅能改变你的想法,而且如果事先掌握了关于你的一些个人信息,它们在辩论中实际上可以比拥有相同信息的真人更具说服力。
“这是加强版的剑桥分析(Cambridge Analytica),”EPFL的项目负责人Robert West说道。研究人员怀疑该模型——在本例中为GPT-4——从其在互联网上庞大的论据和事实库中提取信息,从而提出了更具说服力且更自信的观点。但结果本身似乎已经说明了一切。West警告说,不要低估大语言模型(LLMs)在说服方面的力量:“在即将到来的美国大选背景下,人们感到担忧,因为这种技术总是首先在那里接受实战检验。我们可以肯定的一点是,人们将利用大语言模型的力量来试图左右选举。”
那么,这些模型为什么在语言处理方面如此出色呢?这是一个有着悠久研究历史的领域,可以追溯到ELIZA。如果你对其中一位长期参与该领域(并亲自做出了不少贡献)的研究人员感兴趣,可以查看斯坦福大学的克里斯托弗·曼宁(Christopher Manning)的这篇人物专访。他刚刚获得了约翰·冯·诺依曼奖章。恭喜!
在一场标题颇具挑衅性的采访中,另一位长期从事AI研究的研究人员斯图尔特·罗素(Stuart Russell)与博士后学者迈克尔·科恩(Michael Cohen)探讨了“如何防止AI毁灭全人类”。尽早弄清楚这一点可能是件好事!不过,这并非肤浅的讨论——这些聪明人正在探讨我们如何真正理解AI模型的动机(如果这个词用得恰当的话),以及应该如何围绕它们建立监管框架。
斯图尔特·罗素谈如何让AI实现‘人类兼容’
这次采访实际上涉及本月早些时候发表在《科学》(Science)杂志上的一篇论文,他们在论文中提出,能够采取战略性行动以实现其目标的先进AI(他们称之为“长期规划智能体”)可能无法进行测试。本质上,如果一个模型学会了“理解”为了成功而必须通过的测试,它很可能学会创造性地否定或规避这些测试。我们在小规模上已经见过这种情况,那么在大规模上又为何不可能呢?
罗素提议限制制造此类智能体所需的硬件……但当然,洛斯阿拉莫斯国家实验室(LANL)和桑迪亚国家实验室(Sandia National Labs)刚刚收到了他们的设备交付。洛斯阿拉莫斯国家实验室(LANL)刚刚为Venado举行了剪彩仪式,这是一台旨在用于AI研究的新超级计算机,由2,560个Grace Hopper Nvidia芯片组成。
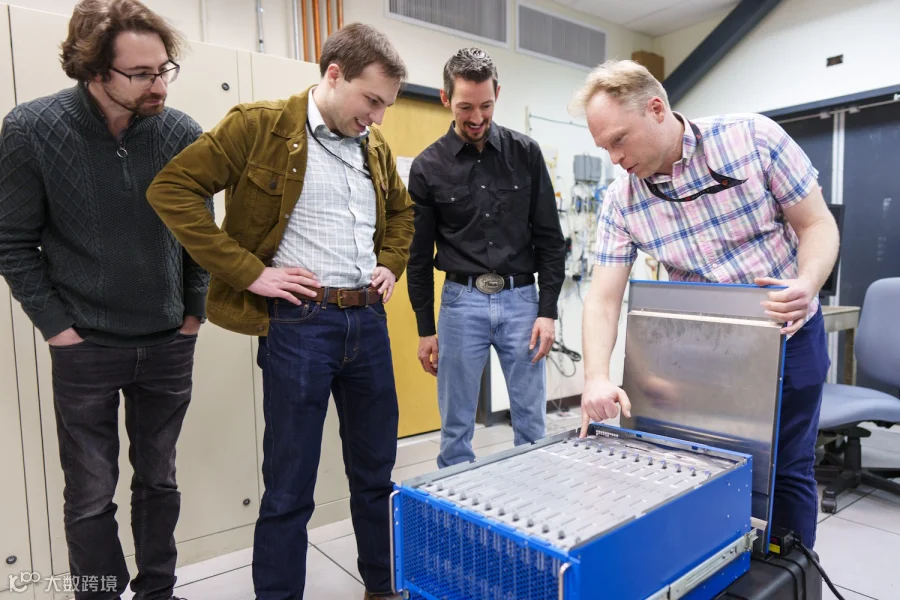
而桑迪亚国家实验室刚刚获得了一套名为“Hala Point”的非凡脑基计算系统,该系统由英特尔(Intel)建造,拥有11.5亿个人工神经元,被认为是世界上最大的此类系统。这种被称为神经形态计算的技术并非旨在取代Venado等系统,而是为了探索比现代模型中那种以统计为主的方法更贴近大脑的计算新方法。
桑迪亚研究员布拉德·艾莫恩(Brad Aimone)表示:“借助这套十亿神经元系统,我们将有机会大规模创新,开发出比现有算法更高效、更智能的新AI算法,以及针对优化和建模等现有计算机算法的新型类脑方法。”听起来不错……真是不错!