


Meta 发布了 Llama 系列开放生成式 AI 模型的最新作品:Llama 3。准确而言,该公司率先推出了包含两款模型的新家族成员,其余型号将在未来未定时间发布。
Meta 将新模型——80 亿参数的 Llama 3 8B 和 700 亿参数的 Llama 3 70B——与上一代 Llama 2 相比描述为“重大飞跃”。参数数量通常定义了 AI 模型在特定任务(如文本分析与生成)上的技能水平;一般而言,参数量越高,模型能力越强。Meta 表示,基于两个定制构建的 24,000 GPU 集群训练,Llama 3 8B 和 70B 是目前同参数规模下表现最佳的生成式 AI 模型之一。
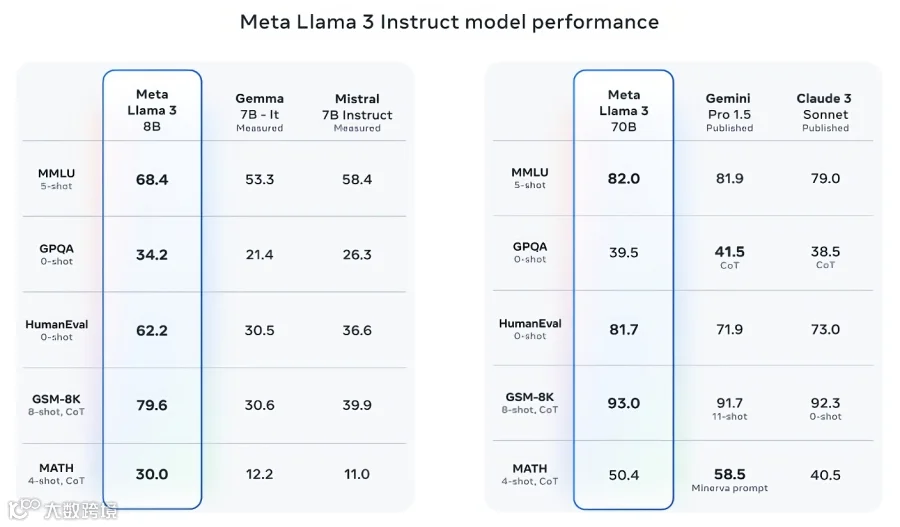
这一声明颇为大胆。Meta 的支持依据是 Llama 3 在 MMLU(知识衡量)、ARC(技能获取)和 DROP(文本推理)等流行 AI 基准测试中的得分。尽管这些基准测试的有效性仍有争议,但它们仍是业界评估模型的少数标准化方法之一。
Llama 3 8B 在至少九个基准测试中优于 Mistral 7B 和 Google Gemma 7B 等其他开放模型,包括 MMLU、ARC、DROP、GPQA(理科问题)、HumanEval(代码生成)、GSM-8K 和 MATH(数学应用题)、AGIEval(问题解决)及 BIG-Bench Hard(常识推理)。
Mistral 7B 和 Gemma 7B 并非当前技术最前沿,Llama 3 8B 在部分基准测试中仅领先数个百分点。但 Meta 声称,更大的 Llama 3 70B 模型已具备与旗舰级生成式 AI 模型竞争的实力,包括 Google Gemini 1.5 Pro。

在 MMLU、HumanEval 和 GSM-8K 上,Llama 3 70B 击败了 Gemini 1.5 Pro;虽不及 Anthropic 最强的 Claude 3 Opus,但在 MMLU、GPQA、HumanEval、GSM-8K 和 MATH 五项测试中,其得分高于 Claude 3 Sonnet。
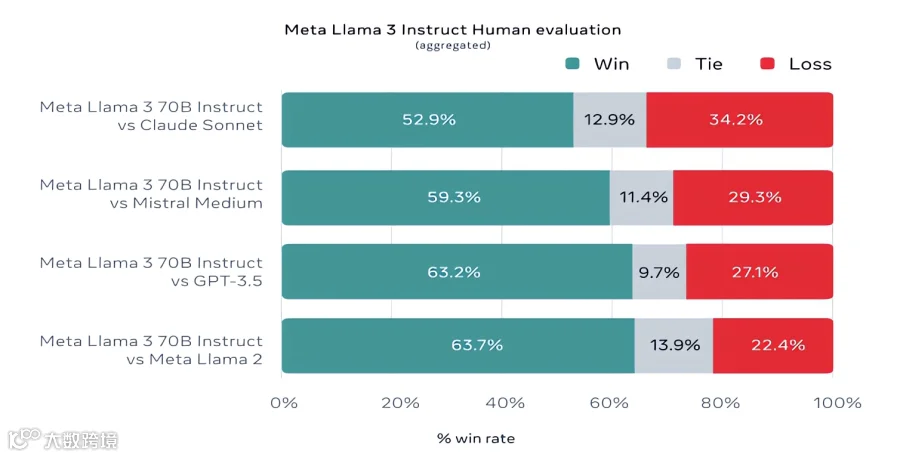
此外,Meta 还开发了涵盖编程、创意写作、推理及摘要等用例的自有测试集。结果显示,Llama 3 70B 在 Mistral Medium、OpenAI GPT-3.5 和 Claude Sonnet 面前表现突出。Meta 称限制了建模团队访问该测试集以保持客观,但鉴于测试由 Meta 自行设计,结果仍需审慎看待。
定性方面,Meta 表示新用户在使用 Llama 3 时将体验到更高的“可控性”、更低的拒答率,以及在琐事、历史问题和 STEM 领域通用编码建议方面更高的准确性。这得益于庞大的数据集:包含 15 万亿个 token(约 7500 亿单词),是 Llama 2 训练集的七倍。(注:“token”指原始数据的细分单元,如单词音节。)
数据源自“公开可用资源”,代码量比 Llama 2 多四倍,且包含约 30 种语言的非英语数据(占 5%)以提升多语言能力。Meta 还使用了合成数据(AI 生成数据)创建长文档供训练,该方法因潜在性能负面影响而颇具争议。
Meta 在与 TechCrunch 分享的博文中写道:“尽管今日发布的模型仅针对英文输出进行了微调,但增加的数据多样性有助于模型更好地识别细微差别和模式,并在各种任务中表现出色。”
许多生成式 AI 供应商视训练数据为核心竞争优势,对其守口如瓶;同时,数据细节也可能引发知识产权诉讼,进一步削弱了披露动力。近期报道称,Meta 曾不顾律师警告使用受版权保护的电子书进行训练;目前,包括喜剧演员莎拉·西尔弗曼在内的多位作者正对 Meta 和 OpenAI 提起诉讼,指控其未经授权在训练中使用受版权保护的数据。
至于毒性和偏见这两个生成式 AI 模型常见问题,Llama 3 是否有所改进?Meta 给出了肯定答复。
Meta 开发了新的数据过滤管道以提高训练数据质量,并更新了 Llama Guard 和 CybersecEval 两款安全套件,以防止模型误用及不良文本生成。此外,还发布了新工具 Code Shield,旨在检测生成式 AI 模型代码中可能引入的安全漏洞。
不过,过滤并非万无一失,上述工具作用也有限。(例如 Llama 2 曾倾向于编造答案并泄露隐私信息。)Llama 3 的实际表现及学术界在其他基准测试中的评估结果,仍有待观察。
Meta 表示,Llama 3 现已开放下载,并驱动 Facebook、Instagram、WhatsApp、Messenger 及网页端的 Meta AI 助手服务。很快,AWS、Databricks、Google Cloud、Hugging Face、Kaggle、IBM WatsonX、Microsoft Azure、Nvidia NIM 和 Snowflake 等云平台将以托管形式提供该模型。未来还将陆续推出针对 AMD、AWS、Dell、Intel、Nvidia 和 Qualcomm 硬件优化的版本。
需注意,我们使用“开放”而非“开源”来描述 Llama 3。尽管可用于研究和商业应用,但 Meta 禁止开发者使用 Llama 模型训练其他生成式模型;月活跃用户超 7 亿的 App 开发者必须向 Meta 申请特别许可,由 Meta 酌情决定是否授予。
更具能力的 Llama 模型即将到来。
Meta 正在训练参数量超 4000 亿的 Llama 3 模型,具备“多语言对话”能力,能处理更多数据并理解图像等多模态信息,这将使 Llama 3 系列与 Hugging Face Idefics2 等开源版本保持一致。

Meta 在博客文章中写道:“我们近期的目标是使 Llama 3 具备多语言和多模态能力,支持更长上下文,并持续提升推理和编码等核心大型语言模型能力的整体表现。”“未来还有更多值得期待的内容。”
确实如此。