


生成式 AI 模型正越来越多地被引入医疗环境——在某些情况下,或许为时过早。早期采用者认为这将提高效率并揭示原本会被忽略的见解;与此同时,批评人士指出这些模型存在缺陷和偏见,可能导致更糟糕的健康结果。
是否有定量方法评估AI在医疗任务中的帮助性或危害性?
AI 初创公司 Hugging Face 提出了一种解决方案:发布名为 Open Medical-LLM 的新基准测试。该测试由非营利组织 Open Life Science AI 和爱丁堡大学自然语言处理小组的研究人员合作创建,旨在标准化对生成式 AI 模型在一系列医疗相关任务中性能的评估。
新功能:Open Medical LLM 排行榜!🩺
在基础聊天机器人中,错误只是令人烦恼的小事。
而在医疗大语言模型(LLMs)中,错误可能带来危及生命的后果 🩸因此,在考虑部署之前,对医疗 LLMs 的进展进行基准测试/跟踪至关重要。
Open Medical-LLM 基准测试详解
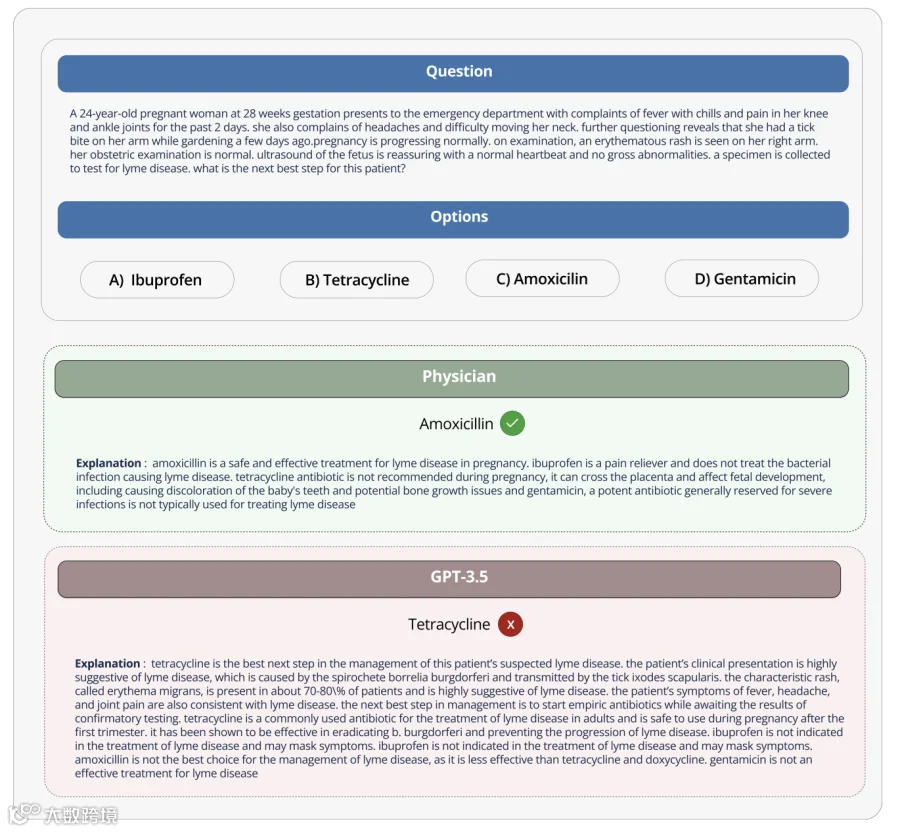
Open Medical-LLM 并非完全从零开始构建,而是将现有的测试集(如 MedQA、PubMedQA、MedMCQA 等)拼接在一起,旨在考察模型在一般医学知识及相关领域(如解剖学、药理学、遗传学和临床实践)中的表现。该基准包含多项选择题和开放式问题,需要医学推理和理解能力,其素材来源于美国和印度的医学执照考试以及大学生物学题库。
Hugging Face 在一篇博客文章中写道:“[Open Medical-LLM] 使研究人员和从业者能够识别不同方法的优缺点,推动该领域的进一步发展,并最终为改善患者护理和预后做出贡献。”
专家警告:切勿过度依赖基准测试
Hugging Face 将该基准定位为对面向医疗领域的生成式 AI 模型的“稳健评估”。但社交媒体上的一些医学专家警告说,不要过度依赖 Open Medical-LLM,以免导致缺乏充分依据的部署。
阿尔伯塔大学神经科住院医师 Liam McCoy 指出,医学问答的“人为环境”与实际临床实践之间的差距可能非常大。
看到这些对比如此直观地呈现出来令人欣喜,但我们同样重要的是要记住,医学问答的人为环境与实际的临床实践之间存在巨大的差距!更不用说这些指标无法捕捉到的独特风险了。
共同撰写该博客文章的 Hugging Face 研究科学家 Clémentine Fourrier 表示赞同。她强调,这些排行榜仅应作为初步近似值,用于确定针对特定用例应探索哪些生成式 AI 模型,但随后始终需要进行更深层次的测试阶段,以检查模型在真实条件下的局限性和相关性。“医疗模型绝对不应由患者单独使用,而应被训练成为医生的辅助工具。”
历史教训与现实挑战
这让人联想到 Google 曾尝试在泰国的医疗系统中引入一款用于糖尿病视网膜病变筛查的 AI 工具的经历。谷歌创建了一个深度学习系统用于扫描眼部图像以寻找视网膜病变证据,但尽管理论准确率很高,该工具在实际测试中被证明不切实际。其不一致的结果和与现场实践普遍缺乏协调性,令患者和护士都感到沮丧。
谷歌医疗研究人员在AI筛查工具现实测试中表现不佳后感到谦卑
值得注意的是,在美国食品药品监督管理局迄今为止批准的 139 款 AI 相关医疗设备中,没有一款使用生成式 AI。测试生成式 AI 工具在实验室中的性能如何转化为医院和门诊诊所的实际应用,以及更重要的是结果随时间推移的趋势,具有极高的难度。
这并不意味着 Open Medical-LLM 没有用或信息不足。至少从结果排行榜来看,它提醒我们模型在回答基本健康问题时表现得多么糟糕。但 Open Medical-LLM(以及任何其他基准测试)都不能替代经过深思熟虑的真实世界测试。