


周四,Reddit推出“公共内容政策”,旨在平衡向大型科技公司授权数据与保护用户隐私的需求。该政策将指导商业实体及合作伙伴如何合规访问和使用Reddit数据。同时,公司宣布设立专供研究人员使用的子版块。
此举紧随Reddit IPO之后,表明其正致力于通过平台广告、开发者API及数据资产增收。招股书显示,公司已通过数据许可协议获得2.03亿美元收入,并预计将持续增长。
尽管Reddit历史上未阻止AI训练用途的数据访问,但去年立场已变。CEO Steve Huffman表示,继续免费向全球最大公司提供这些数据并不合理,明确了进入数据许可领域的意图。
随着相关举措全面展开,新政策禁止在无协议情况下访问Reddit数据。Reddit强调,这并非新增限制,而是将内部已实施一段时间的政策公开化。
Reddit在博客中指出:“越来越多商业实体未经授权或滥用授权批量收集公共数据,且无视用户权利、隐私及删除请求。我们将限制对可信实体的访问规模,同时确保用户、版主、研究人员及非商业行为者能正常访问数据。”
简言之,研究等非商业用途的数据访问不受影响;但若将数据用于其他目的(含AI训练),则需付费。Reddit明确表示,为商业目的使用数据的企业必须签订合同。
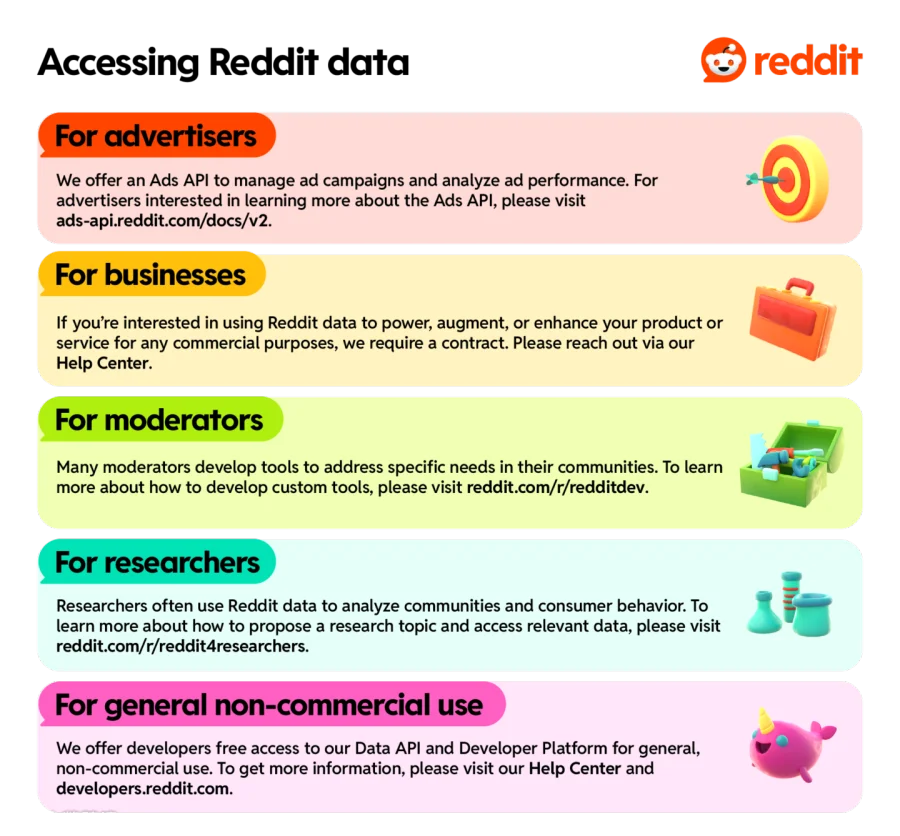
此外,广告商将被引导至专用广告API,以管理活动并追踪表现。
作为可被搜索引擎索引的大型网站,新政策旨在防止未经授权的爬虫抓取,同时尊重用户权益。
例如,合作伙伴必须同步用户上传的内容删除决定。若用户不愿个人帖子成为AI素材,可选择退出。新政策还限制利用Reddit内容进行个人身份识别或广告定向,禁止垃圾邮件、网络欺凌、背景调查、面部识别及政府监控等行为。
该政策限制了成人内容的访问,并澄清不会出售用户个人信息。Reddit强调,绝不会授权许可私人消息或非公开账户信息(如邮箱、浏览历史等)。
为支持非商业研究,Reddit建立了新子版块r/reddit4researchers,并正与OpenMined合作开发项目,以促进研究人员与平台的合规协作。