


谷歌正在升级其图像生成技术,以跟上竞争对手的步伐。
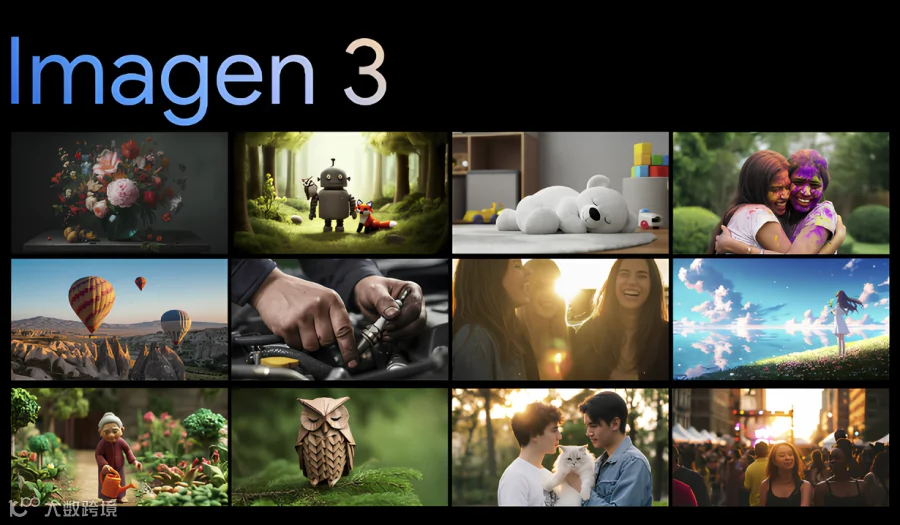
在周二于山景城举行的I/O开发者大会上,谷歌宣布推出Imagen 3,这是其Imagen生成式AI模型家族的最新成员。
DeepMind首席执行官Demis Hassabis表示,相比Imagen 2,Imagen 3能更准确地理解文本提示并转化为图像,生成内容更具“创造性和细节”,且产生的干扰性伪影和错误更少。
Hassabis补充道:“这也是我们迄今为止最好的文字渲染模型,而文字渲染一直是图像生成模型面临的挑战。”
为缓解深度伪造(deepfakes)担忧,谷歌表示Imagen 3将采用SynthID技术,即由DeepMind开发的不可见加密水印方案。
目前可通过谷歌ImageFX工具申请Imagen 3私人预览;该模型也将很快面向Vertex AI(谷歌企业级生成式AI开发平台)的开发者及企业客户开放。
与以往一样,谷歌未披露训练数据来源。大部分数据源自网络公开网站、存储库和数据集,但部分未经授权的版权内容抓取已引发知识产权诉讼。
尽管谷歌提供网络发布者控制功能允许站长阻止抓取,但未提供“退出”工具,也未承诺就训练数据集贡献向权利人提供补偿。
缺乏透明度虽不意外,但对资源丰富的谷歌而言仍令人失望。
