


在生成式人工智能时代,聊天机器人能够根据互联网内容提供详尽解答,合理使用与抄袭、常规抓取与不道德摘要之间的界限日益模糊。
Perplexity AI 将搜索引擎与大语言模型结合,生成包含详细回答而非仅链接的答案。不同于 OpenAI 和 Anthropic,Perplexity 不训练基础模型,而是利用开源或商业模型转化网络信息为答案。
六月的一系列指控显示该公司做法接近不道德边缘。Forbes 指出 Perplexity 涉嫌抄袭其新闻文章并用于 Beta 版“Perplexity Pages”功能;Wired 则指责其非法抓取网站内容。
截至四月,Perplexity 正以近 300 亿美元估值筹集 2.5 亿美元。这家获 Nvidia 和 Jeff Bezos 支持的公司坚称未做错事,表示已尊重出版商的不抓取请求,且运营符合版权法合理使用范围。
情况错综复杂,核心涉及两个概念:一是“Robots Exclusion Protocol”(robots.txt 协议),即网站表明不希望被爬虫访问的标准;二是版权法中的“合理使用”(fair use),为特定情况下无需许可使用受版权保护材料提供法律框架。
秘密抓取网页内容
《连线》杂志 6 月 19 日报道称,Perplexity 无视 Robots Exclusion Protocol,秘密抓取出版商禁止机器人访问的区域。报道观察到一台关联机器在其自家及母公司 Condé Nast 旗下出版物网站上执行此操作。
开发者 Robb Knight 进行了类似实验并得出相同结论。《连线》记者与 Knight 通过要求 Perplexity 摘要一系列 URL 并在服务器端观察关联 IP 是否访问来验证怀疑。随后 Perplexity “总结”了这些文本——在测试网站中甚至逐字返回页面内容。
这正是 Robots Exclusion Protocol 细微之处发挥作用的地方。
网页抓取指自动化软件扫描网络以索引收集信息。Google 等搜索引擎以此纳入搜索结果,其他公司和研究人员则用于市场分析、学术研究及训练机器学习模型。
遵守协议的工具会先查找“robots.txt”文件确认允许行为。如今通常不允许抓取出版商网站构建大规模 AI 训练数据集。包括 Perplexity 在内的公司声称遵守该协议,但并无法律义务必须这样做。
Perplexity 业务负责人 Dmitry Shevelenko 告诉 TechCrunch,对 URL 进行摘要与爬取不同。“爬取是指搜集信息添加到索引中,”他说。他指出用户查询输入 URL 时,Perplexity IP 可能作为访客出现在“原则上被 robots.txt 禁止”的网站,但这“不符合爬取定义”。
“我们只是在响应用户直接且具体的请求前往该 URL,”Shevelenko 说。
换言之,若用户手动提供 URL,Perplexity 视其 AI 为帮助检索处理信息的工具而非网络爬虫。
但对《连线》及许多出版商而言,这种区别毫无意义,因为每天数千次访问 URL 提取信息生成摘要确实像抓取行为。
(Wired 还报道 AWS 正在调查该初创公司无视 robots.txt 协议抓取提示词引用网页的行为。AWS 告诉 TechCrunch 报道不准确,表示正像处理其他滥用服务报告一样处理询问。)
抄袭还是合理使用?
Wired 和 Forbes 均指责 Perplexity 抄袭。讽刺的是,Wired 称 Perplexity 抄袭了揭露其秘密抓取内容的文章。
Wired 记者表示,Perplexity 聊天机器人“生成了六段共 287 个单词的文本,紧密总结了故事结论及证据”。其中一句完全复述原文,Wired 认为构成抄袭。Poynter 研究所指导方针指出,连续使用原作七个单词可能构成抄袭。
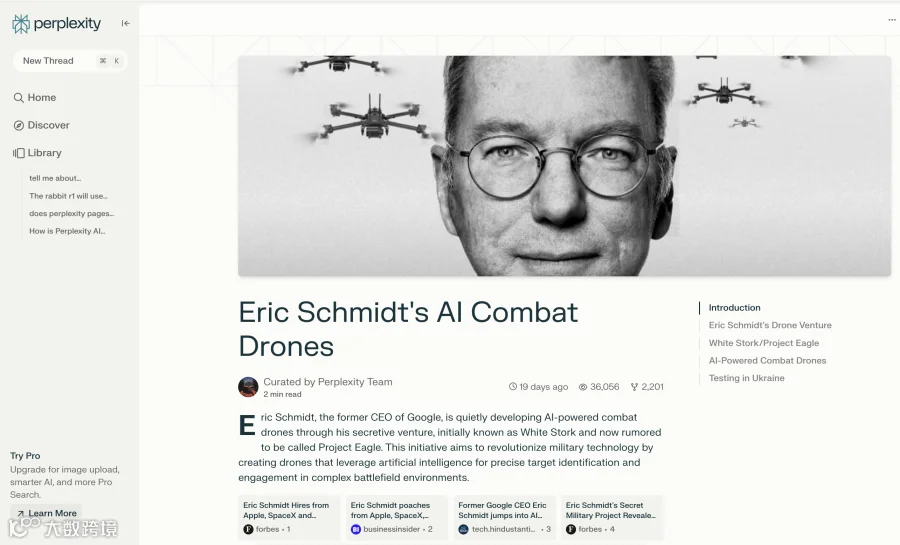
Forbes 也提出指控。该网站六月初发布关于谷歌前 CEO 埃里克·施密特新创企业招聘测试军事用途 AI 无人机的调查报告。次日编辑约翰·帕茨科夫斯基在 X 发帖称,Perplexity 将其作为 Beta 功能“Perplexity Pages”一部分重新发布。
Perplexity 称 Pages 目前仅对部分订阅用户开放,旨在帮助用户将研究转化为“视觉惊艳、内容全面的作品”。示例包括员工撰写的《鼓乐入门指南》或《史蒂夫·乔布斯:富有远见的 CEO》等文章。
“它几乎剽窃了我们所有报道,”Paczkowski 写道,“以最容易被人忽略的方式引用我们及少数转载网站作为来源。”
Forbes 报道称团队策划的许多帖子与多家出版机构原始故事惊人相似,获得数万次浏览却未在正文提及名称,仅以“微小易忽略的徽标链接”形式提供出处。
此外,《福布斯》表示关于施密特的帖子措辞与独家报道“几乎完全相同”,聚合内容还包含一张经轻微修改的原设计团队图片。
Perplexity CEO 阿拉文德·斯里尼瓦斯回应称未来会更显著引用来源,但这并非万无一失。ChatGPT 和其他模型曾产生幻觉链接,Perplexity 使用 OpenAI 模型很可能受此影响。事实上,《连线》观察到 Perplexity 产生了整个故事的幻觉。
除指出“粗糙之处”外,Srinivas 及公司坚持认为有权使用此类内容进行摘要。
这正是合理使用细微差别发挥作用之处。抄袭虽受谴责但在技术上并不违法。
美国版权局规定,出于评论、批评、新闻报道和学术研究等目的有限使用作品(包括引文)合法。AI 公司认为提供文章摘要属于合理使用范畴。
“没有人对事实拥有垄断权,”Shevelenko 说,“一旦事实公之于众就供所有人使用。”
Shevelenko 将摘要比作记者使用其他新闻源加强报道,但 AI 公司的不公平优势在于几秒内汇编出需多名记者数小时完成的内容。
UCLA 技术与法律政策研究所法学教授 Mark McKenna 告诉 TechCrunch 这种情况不易理清。法院会权衡摘要是否大量使用原文表达还是仅使用思想,以及阅读摘要是否会替代阅读原文。
“没有明确分界线,”McKenna 说,“客观陈述文章内容使用的是不受版权保护的事实和思想。但如果摘要包含更多实际表达和文本,就越来越像复制而不仅是摘要。”
对出版商不幸的是,除非 Perplexity 使用完整表达(某些情况下确实如此),否则摘要可能不被视为违反合理使用原则。
Perplexity 旨在如何保护自己
OpenAI 已与各类新闻媒体签署协议获取当前及存档内容用于训练算法,承诺在 ChatGPT 响应查询时展示这些媒体文章。(Nieman Lab 上周报道这仍有待解决的瑕疵。)
Perplexity 推迟宣布媒体合作或许是在等待指控平息,但正“全速推进”与出版商的广告收入分成协议。
该想法是 Perplexity 将在查询回复旁投放广告,被引用内容的出版商将获得相应收入分成。Shevelenko 表示还在努力让出版商访问其技术,以便在网站和产品中构建问答体验并原生支持相关问题等功能。
但这是否只是系统性知识产权盗窃的遮羞布?Perplexity 并非唯一一款可能将内容摘要得如此彻底以致读者无需点击链接查看原始资料的聊天机器人。
若此类 AI 爬虫继续抓取并重用出版商作品,出版商将更难获得广告收入,导致可供抓取内容减少。当无更多内容可抓时,生成式 AI 系统将转向合成数据训练,可能导致充满潜在偏见和不准确内容的地狱般反馈循环。