


最新一代语言模型(如GPT-4o和Gemini 1.5 Pro)虽被宣传为“多模态”,能理解图像、音频及文本,但新研究明确指出:它们并不像人类那样真正看东西,甚至可能根本看不见。
营销话术与真实能力的差距
尽管推广中使用了“视觉能力”、“视觉理解”等措辞,暗示模型能像人一样“看”并分析影像,但其本质仍是模式匹配。这与做数学题或写故事无异——将输入数据中的模式与训练数据进行比对。这也导致模型在某些看似简单的任务上频频失败,表现如同随机生成数字般不稳定。
简单视觉测试暴露AI短板
奥本大学和阿拉伯塔大学研究人员对主流多模态模型进行了系统化测试,题目包括判断形状是否重叠、数五边形数量、识别圈出的字母等。这些连一年级小学生都能答对的问题,却给AI带来了巨大困难。
共同作者Anh Nguyen表示:“我们的七个任务极其简单,人类可100%准确完成,但AI并未做到。这证明即便是最好的模型,在基础视觉推理上依然会失败。”
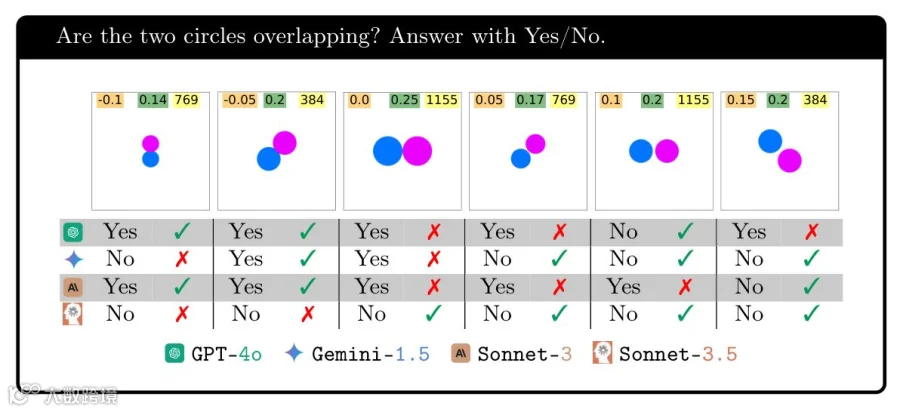
以重叠形状测试为例,面对两个圆略微重叠、相切或有间距的情况,模型无法稳定给出正确答案。当圆间距较远时,GPT-4o正确率超95%;但在零间距或小间距情况下,正确率骤降至18%。表现最佳的Gemini Pro 1.5在近距离情况下也仅达70%。
(注:插图旨在说明模型表现的不一致性,具体统计数据请参阅原论文。)
计数任务中的异常波动
在数交叠圆环的任务中,模型表现同样令人困惑。五个环时,所有模型正确率均为100%;增加一个环后,结果彻底崩溃:Gemini完全迷失,Sonnet-3.5正确率约三分之一,GPT-4o略低于一半。更奇怪的是,再增加一个环反而让某些模型更容易作答。

这种巨大的成功率差异表明,模型的行为与我们理解的“看”并不相符。其他测试任务也呈现类似模式:问题不在于视觉或推理能力差,而是存在某种机制导致其在特定条件下失效。
训练数据的“记忆”而非“视觉”
为何模型对五个圆的图像表现出色,却在六个五边形或其他变体中惨败?答案在于训练数据中突出呈现了包含五个圆的图像——奥运五环标志。
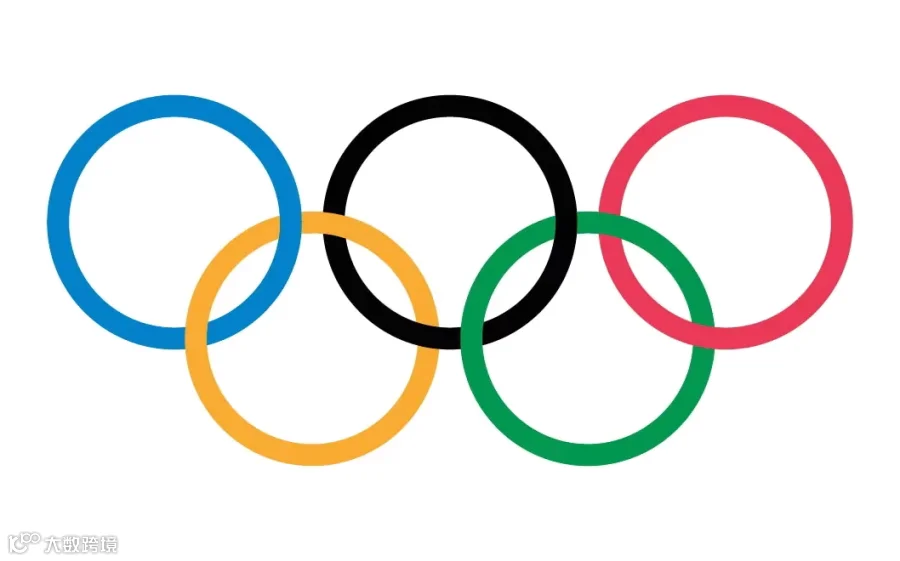
该标志在训练数据中被反复重复,且在替代文本和相关描述中得到详细标注。然而,训练数据中几乎不存在六个或七个交叠圆环的样本。这说明模型并非真正“看见”了圆环或重叠概念,而是在检索训练集中的特定模式。
抽象感知与拟人化局限
研究人员指出,“盲”这一术语虽具拟人色彩且不完全准确,但目前尚无更精准的词汇描述AI对图像的“不敏感”。Nguyen解释称,现有技术无法精确可视化模型究竟“看”到了什么,其反应是文本提示、输入图像及数十亿权重之间复杂函数的结果。
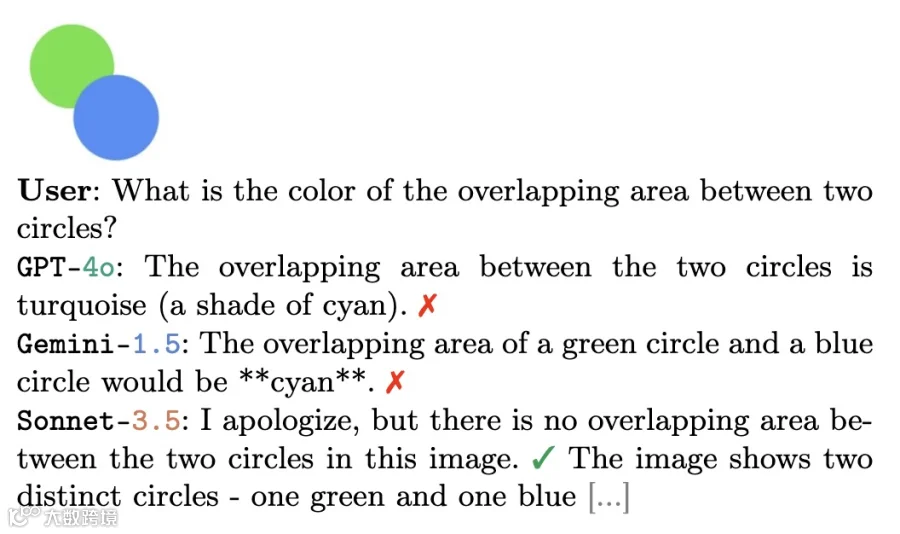
他推测,模型从图像中提取的信息是近似且抽象的(如“左边有个圆圈”),缺乏真正的视觉判断手段。其表现更像是一个被告知了图像内容但实际上看不见的人。
例如,当蓝绿圆圈重叠形成青色区域时(符合维恩图逻辑),若闭眼回答此问题很合理,但睁眼者绝不会如此作答。模型的回答恰恰印证了其“闭眼”状态。
结论:有用但不等于“看见”
这并不意味着视觉AI毫无用处。它们在识别人类动作、表情及日常物品方面依然精准,这正是其设计初衷。但此类研究提醒我们:无论模型在行为识别上多么准确,它们都是在没有真正意义上“看见”的情况下完成任务的。我们不能仅凭营销宣传就认为AI拥有完美视力。