


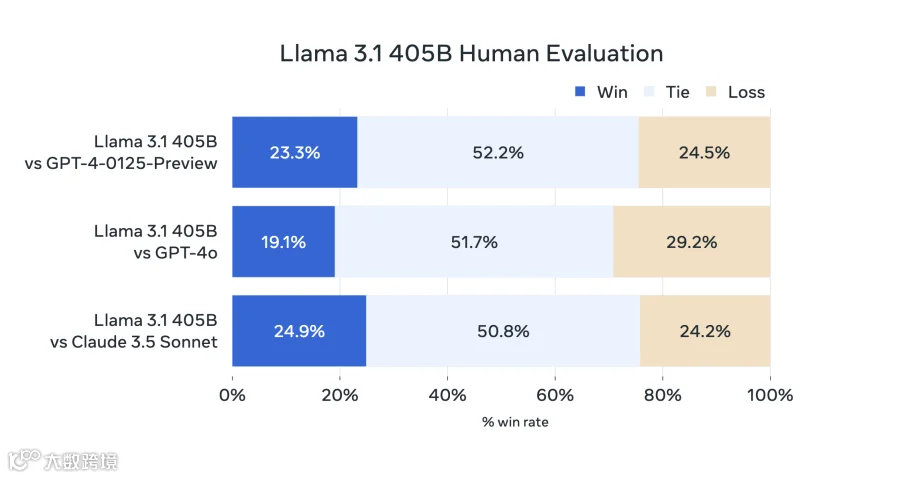
Meta 发布了其迄今最大的开源 AI 模型 Llama 3.1 405B,该模型拥有 4050 亿参数。尽管并非当前绝对最大的开源模型,但它是近年来规模最大的,使用 16,000 块 Nvidia H100 GPU 训练,并采用新技术以对标 GPT-4o 和 Claude 3.5 Sonnet 等领先专有模型。
Llama 3.1 405B 支持下载及在 AWS、Azure、Google Cloud 等平台使用,并已集成至 WhatsApp 和 Meta.ai 为美国用户提供聊天服务。
全新升级
Llama 3.1 405B 支持代码编写、基础数学解答及八种语言(英、德、法、意、葡、印地、西、泰)文档总结。作为纯文本模型,它虽不支持图像问答,但可处理 PDF 和电子表格分析等文本负载。Meta 正积极研发多模态版本,但目前尚未发布。
训练数据方面,模型使用了截至 2024 年的 15 万亿 token 数据集(约 7500 亿单词)。Meta 优化了数据策展流程,采用了更严格的质量保证与过滤方法,并使用合成数据进行微调。尽管公司声称仔细平衡了训练数据,但出于竞争优势及知识产权诉讼风险考虑,未透露具体来源(网页及公共文件除外)。
论文指出,Llama 3.1 405B 增加了非英语数据、数学数据、代码及近期网络数据的比例,以提升多语言能力、推理能力及知识储备。此前路透社报道显示,Meta 曾因使用受版权保护内容训练 AI 而面临诉讼,且让用户难以选择退出。
Meta AI 项目管理副总裁 Ragavan Srinivasan 表示,训练数据如同“秘密配方”,公司将持续投入资源优化该领域。
更大的上下文和工具
Llama 3.1 405B 上下文窗口扩展至 128,000 token(约 50 页书),显著优于前代模型的 8,000 token。大上下文有助于总结长文本并减少对话遗忘。同期发布的 Llama 3.1 8B 和 70B 也具备同等上下文能力。
所有 Llama 3.1 模型均支持调用第三方工具,开箱即用 Brave Search(时事)、Wolfram Alpha API(数理)及 Python 解释器(代码验证),并具备一定的未知工具使用能力。
构建生态系统
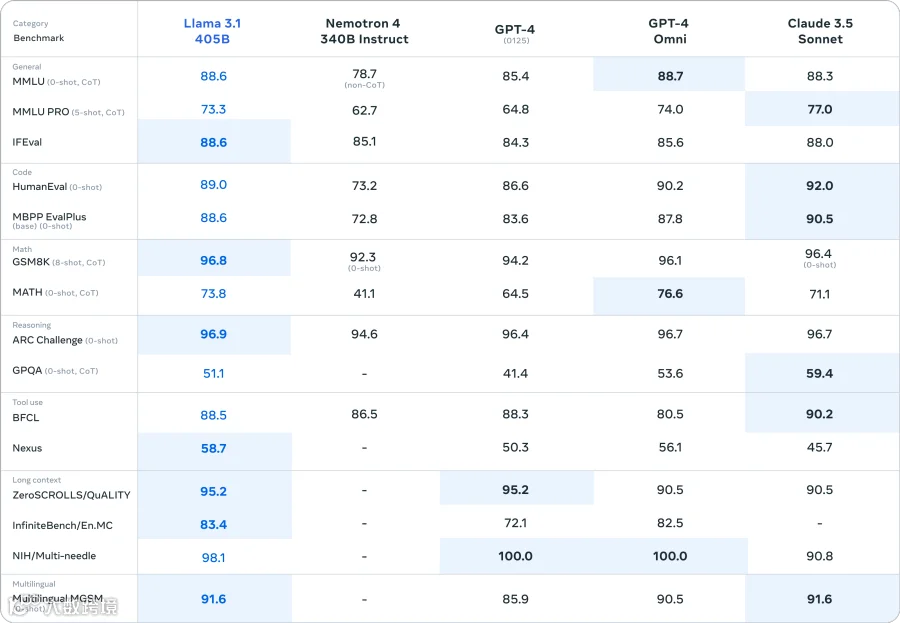
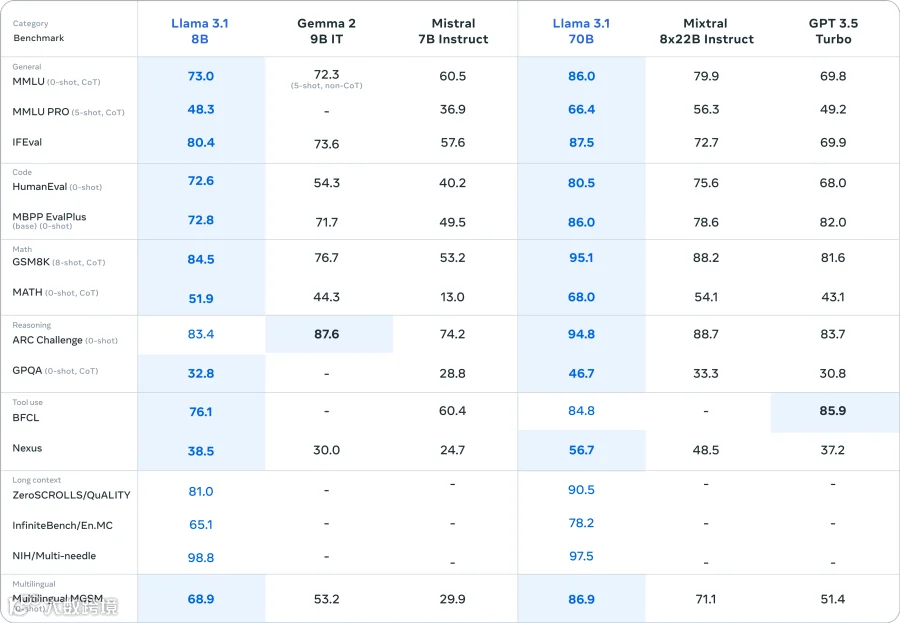
基准测试显示,Llama 3.1 405B 表现与 GPT-4 相当,但在代码执行和图表生成上优于 GPT-4o;多语言能力整体较弱,编程和通用推理落后于 Claude 3.5 Sonnet。由于模型庞大,运行需至少一个服务器节点。
Meta 推荐将较小的 Llama 3.1 8B/70B 用于通用应用,而 405B 更适合模型蒸馏及生成合成数据。为此,Meta 更新了许可证,允许开发者使用模型输出来开发第三方 AI 生成模型,但月活超 7 亿的应用仍需申请特别许可。
此次许可变更缓解了社区批评。伴随新模型发布的还有参考系统、安全工具及预览版 Llama Stack API,旨在支持微调、合成数据生成及智能体应用开发,帮助开发者在生产环境中部署模型。
争夺市场份额
Meta CEO 扎克伯格宣称致力于让全球开发者享有 AI 机遇,实则意在推广 Meta 生态。通过免费提供工具培育生态,再逐步引入付费服务,Meta 试图压低竞争对手价格并将自身 AI 广泛传播,同时吸纳开源社区的改进。
目前 Llama 模型下载量已超 3 亿次,衍生模型超 2 万个。Meta 正花费数百万美元游说监管机构接受其“开放”模式。尽管 Llama 3.1 系列仍存在幻觉等问题,但其核心目标是确立 Meta 在生成式 AI 领域的地位。
此外,大规模训练带来了能源挑战。研究论文指出,数万块 GPU 的功耗波动可能导致数据中心出现数十兆瓦级的瞬时电力变化,对电网构成压力,这也是未来扩展训练规模时面临的持续难题。