


人工智能模型虽已展现诸多能力,但真正应被赋予的任务是那些繁琐杂务——这在研究和学术界尤为常见。Reliant 致力于将目前由疲惫的研究生和实习生承担的耗时数据提取工作实现自动化。
“AI 的最佳用途在于改善人类体验:减少琐碎劳动,让人们专注于重要事务。”首席执行官卡尔·莫里茨·赫尔曼(Karl Moritz Hermann)表示。在他与联合创始人马克·贝勒马尔(Marc Bellemare)、理查德·施莱格尔(Richard Schlegel)深耕的研究领域中,文献综述正是此类“琐碎劳动”的典型代表。
每篇论文均需引用既往及相关研究,但在浩瀚的科学文献中精准定位这些来源并非易事。系统综述等研究甚至需引用或处理数千份文献的数据。
赫尔曼回忆道,在一项研究中,“作者查阅了3500篇科学出版物,其中大量最终被证实不相关。耗费大量时间仅提取少量有用信息,这理应交由人工智能自动完成。”
现代语言模型确实具备此能力:一项实验显示,ChatGPT 在该任务中的数据提取错误率为11%。尽管对许多 LLM 任务而言这一表现令人印象深刻,但仍远未达到实际应用标准。

“这远远不够,”赫尔曼指出,“对于知识型任务,即便看似琐碎,也绝不容许出错。”
Reliant 的核心产品 Tabular 基于大型语言模型(Llama 3.1)并辅以专有技术,效果显著提升。在上述涉及数千项研究的提取任务中,该产品实现了零错误率。
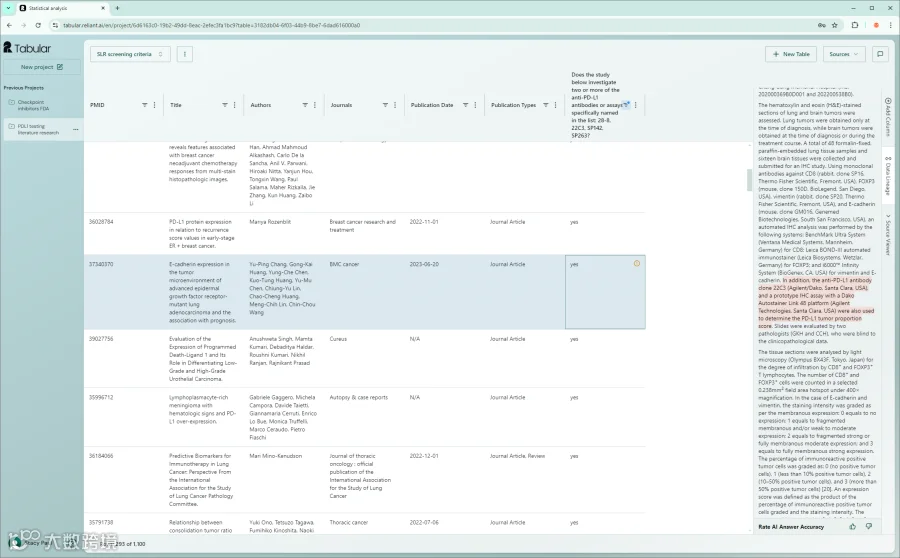
用户可将千份文档输入系统并指定提取字段,Reliant 便会精准梳理文档、定位相关信息——无论数据是否已被完美结构化。随后,所有数据及分析结果将以友好界面呈现,便于用户深入查看个案。
“用户需要一次性处理全部数据。我们正在构建编辑现有数据及从数据回溯至原始文献的功能,旨在帮助用户聚焦关键信息,”赫尔曼表示。
这种量身定制的高效 AI 应用虽不如数字伴侣吸睛,却更具可行性,能加速高度技术领域的科学发展。投资者已关注到其价值,Tola Capital 和 Inovia Capital 领投了其1130万美元种子轮融资,天使投资人 Mike Volpi 亦参与其中。
与其他 AI 应用一样,Reliant 高度依赖算力。公司选择自建硬件而非按需租用云资源,此举兼具风险与回报:既需确保昂贵设备物尽其用,也能凭借专用算力突破问题瓶颈。
“若响应时间受限,很难给出优质答案,”赫尔曼解释道。例如当科学家要求系统对百篇论文执行新颖提取或分析时,速度与质量往往难以兼得——除非能预判用户可能提出的问题并提前准备答案。
“许多问题具有共性,我们可在提问前预先找到答案作为起点,”首席科学官贝勒马尔表示。“我们可以将百页文本提炼为更易处理的中间形式,虽未必完全契合需求,但便于后续优化。”
试想:若要从千部小说中提取信息,是等人询问角色姓名时才逐一查找,还是提前整理好地点、日期、关系等高频需求数据?显然后者更优——前提是拥有充足算力。
预提取过程还为模型解决跨学科歧义提供了时间。同一指标在制药、病理学或临床试验中的含义可能迥异;且语言模型的输出常因提问方式而异。因此,Reliant 致力于将不确定性转化为确定性——正如赫尔曼所言:“这唯有在对特定科学领域或行业深度投入时方能实现。”
作为初创企业,Reliant 的首要目标是验证技术的盈利能力,再图长远发展。赫尔曼强调:“取得实质性进展既需宏大愿景,也需脚踏实地。从生存角度看,我们专注营利性业务以支撑 GPU 成本,绝不亏本销售技术。”
尽管面临 OpenAI、Anthropic 等巨头在结构化任务上的竞争,以及 Cohere、Scale 等实施伙伴的压力,贝勒马尔仍保持乐观:“我们依托广泛的技术浪潮构建系统——技术栈的任何改进皆有益处。大语言模型仅是我们八个大型机器学习模型之一,其余均为基于独有数据自主研发。”
生物技术与研究行业的 AI 转型方兴未艾,未来数年或将呈现零散而不均衡的态势,但 Reliant 已找到稳固切入点。
赫尔曼总结道:“若仅需95%准确率且可接受偶发致歉,固然可行。但我们聚焦于精确率与召回率至关重要、错误后果严重的场景。坦率地说,仅此便已足够;其余市场,我们乐见他人开拓。”
(注:本文最初误写了 Hermann 的名字,现已全文更正。)