


单词“strawberry”中字母“r”出现了几次?根据 GPT-4o 和 Claude 等强大的 AI 产品,答案是两次。
大型语言模型(LLMs)可以在几秒钟内写文章和解方程,合成数太字节数据的速度比人类打开一本书还要快。然而,这些看似无所不知的 AI 有时会失败得如此 spectacularly,以至于这次失误变成了病毒式传播的网络迷因,让我们庆幸在必须向新的 AI 统治者低头之前还有时间。
哦 pic.twitter.com/K2Lr9iVkjQ — Rob DenBleyker (@RobDenBleyker) 2024年8月26日
大型语言模型无法理解字母和音节的概念,这揭示了一个我们常常忘记的更大真相:这些东西没有大脑。它们的思考方式不像我们,不是人类,甚至也不是特别像人类。
Transformer架构的局限性
大多数 LLMs 基于 Transformer 构建,这是一种深度学习架构。Transformer 模型将文本分解为 token,可以是完整的单词、音节或字母,具体取决于模型。
阿尔伯塔大学 AI 研究员兼助理教授 Matthew Guzdial 告诉 TechCrunch:“LLMs 基于这种 Transformer 架构,值得注意的是,它实际上并没有在阅读文本。当你输入一个提示时,它会被转换成一个编码。当它看到单词‘the’时,它对这个词的含义有一个编码,但它不知道‘T’、‘H’、‘E’。”
这是因为 Transformer 无法有效地接收或输出实际文本。相反,文本被转换为自身的数值表示,然后进行上下文化处理,以帮助 AI 生成合乎逻辑的响应。换句话说,AI 可能知道 token “straw”和“berry”组成了“strawberry”,但它可能不理解“strawberry”是由字母“s”、“t”、“r”、“a”、“w”、“b”、“e”、“r”、“r”和“y”按特定顺序组成的。因此,它无法告诉你单词“strawberry”中有多少个字母——更不用说有多少个“r”了。
这不是一个容易解决的问题,因为它嵌入在这些 LLMs 工作的核心架构之中。
我以为《沙丘2》是2024年最好的电影,直到我看了这部杰作(请开启声音)。pic.twitter.com/W9WRhq9WuW — Peter Yang (@petergyang) 2024年3月7日
TechCrunch 的 Kyle Wiggers 上个月深入研究了这个问题,并采访了东北大学研究大型语言模型可解释性的博士生 Sheridan Feucht。
富赫特告诉 TechCrunch:“很难回避这样一个问题:对于语言模型来说,‘词’究竟应该是什么?即使我们让人类专家就完美的词汇表达成一致,模型可能仍然会觉得进一步‘分块’处理更有用。由于这种模糊性,并不存在所谓的完美分词器。”
随着大型语言模型学习更多语言,这个问题变得更加复杂。例如,某些分词方法可能假设句子中的空格总是 precede 一个新词,但许多语言如中文、日文、泰文、老挝文、韩文、高棉文等并不使用空格来分隔单词。Google DeepMind AI 研究员 Yennie Jun 在 2023 年的一项研究中发现,有些语言需要比英语多多达 10 倍的 token 才能传达相同的含义。
富赫特表示:“最好让模型直接查看字符而不强加分词,但目前这对 Transformer 架构来说在计算上是不可行的。”
图像生成器的挑战与改进
图像生成器如 Midjourney 和 DALL-E 不使用像 ChatGPT 这样的文本生成器底层所采用的 Transformer 架构。相反,图像生成器通常使用扩散模型,该模型从噪声中重建图像。扩散模型是在大型图像数据库上训练的,并被激励去尝试重新创建类似于从训练数据中学到的内容。
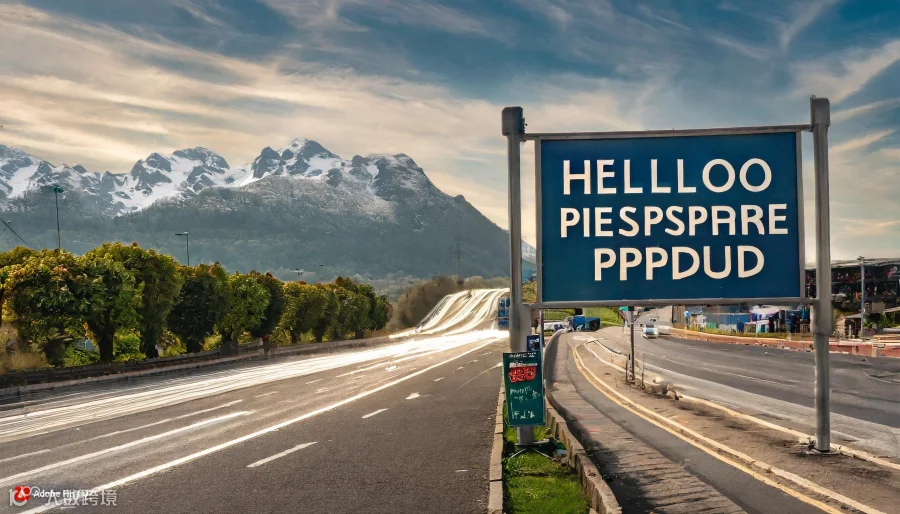
Lesan 的联合创始人兼 DAIR 研究所研究员 Asmelash Teka Hadgu 告诉 TechCrunch:“图像生成器在处理汽车和人脸等物体时表现更好,而在处理手指和手写体等较小细节时表现较差。”
这可能是因为这些较小的细节在训练集中并不像“树通常有绿叶”这样的概念那样突出。不过,扩散模型存在的问题可能比困扰 Transformer 的问题更容易解决。例如,一些图像生成器通过增加对真实人类手部图像的训练,在表现手部方面有所改进。
Guzdial 解释说:“就在去年,所有这些模型在手指方面都非常糟糕,这与文本问题完全相同。它们在局部变得非常擅长,所以如果你看到一只手上有六或七个手指,你可能会说:‘哦哇,那看起来像个手指。’同样,对于生成的文本,你可以说,那看起来像个‘H’,那个看起来像个‘P’,但它们在将这些整体结构组合在一起方面真的很糟糕。”
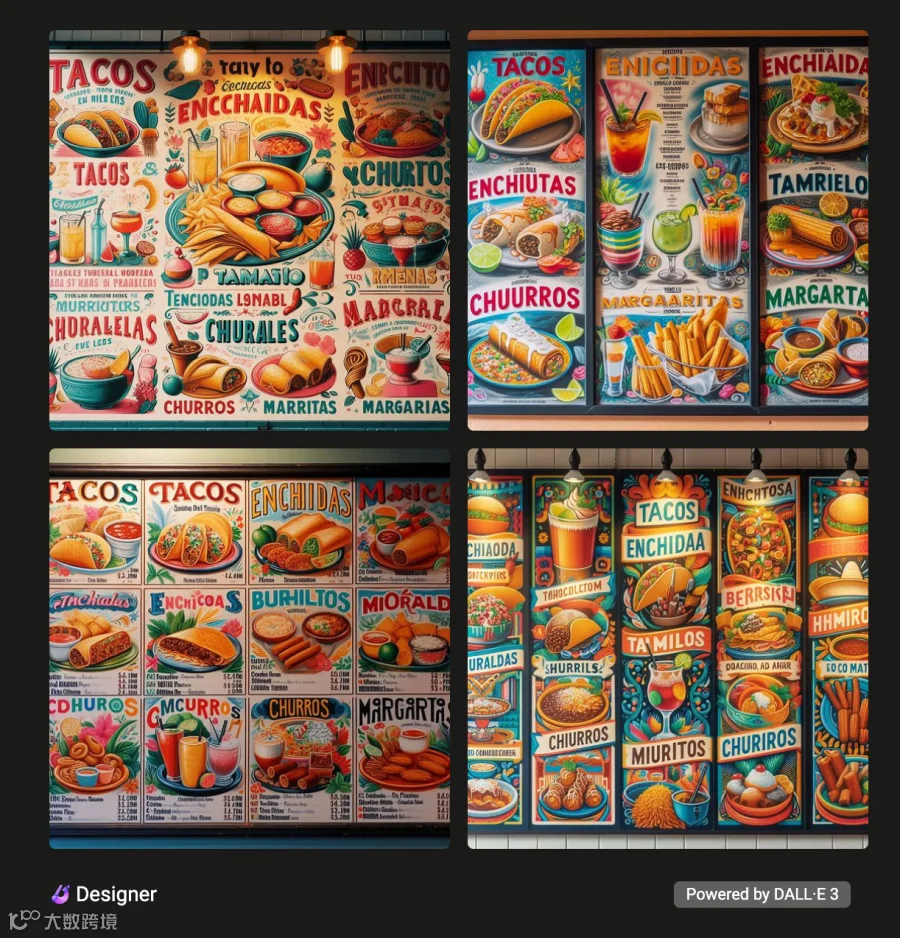
因此,如果你要求 AI 图像生成器为一家墨西哥餐厅创建菜单,你可能会得到“Tacos”这样的正常项目,但你更有可能找到“Tamilos”、“Enchidaa”和“Burhiltos”这样的菜品。
新一代AI模型的推理突破
随着关于拼写“strawberry”的梗图在互联网上流传,OpenAI 正在开发一款代号为 Strawberry 的新 AI 产品,该产品据称在推理能力方面更加出色。大型语言模型(LLMs)的增长受到世界范围内训练数据不足的限制,这使得 ChatGPT 等产品难以更加准确。但据报道,Strawberry 可以生成准确的合成数据,使 OpenAI 的大型语言模型变得更好。根据 The Information 报道,Strawberry 能够解决《纽约时报》的 Connections 字谜游戏,这需要创造性思维和模式识别来解决,并且能够解决它之前未见过的数学方程。
与此同时,Google DeepMind 最近发布了 AlphaProof 和 AlphaGeometry 2,这是专为形式化数学推理设计的 AI 系统。Google 表示,这两个系统在国际数学奥林匹克竞赛的六道题目中解决了四道,这一表现足以在该著名比赛中获得银牌。
这有点像个恶作剧,关于 AI 无法拼写“strawberry”的梗图在报道 OpenAI 的 Strawberry 的同时流传开来。但 OpenAI 首席执行官 Sam Altman 抓住这个机会向我们展示,他的花园里结出了相当令人印象深刻的果实。