


过去几个月里,埃隆·马斯克等科技高管一直在吹捧其公司AI模型在特定基准测试Chatbot Arena上的表现。
由名为LMSYS的非营利组织维护的Chatbot Arena已成为行业关注的焦点,关于其模型排行榜更新的帖子在Reddit和X上获得了数百次浏览和转发,而LMSYS官方X账号拥有超过54,000名粉丝,仅过去一年就有数百万人访问了该组织的网站。
尽管如此,关于 Chatbot Arena 能否真正告诉我们这些模型究竟“有多好”,仍有一些悬而未决的问题。
寻找新的基准
在深入探讨之前,让我们先花点时间了解 LMSYS 究竟是什么,以及它是如何变得如此受欢迎的。
该非营利组织仅于去年四月成立,是由卡内基梅隆大学、加州大学伯克利分校 SkyLab 和加州大学圣地亚哥分校的学生与教师牵头发起的项目。部分创始成员如今已在 Google DeepMind、马斯克旗下的 xAI 和 Nvidia 工作;目前,LMSYS 主要由与 SkyLab 相关的研究人员运营。
LMSYS最初并非旨在创建病毒式传播的模型排行榜,该组织的创始使命是通过共同开发和开源模型(特别是类似OpenAI的ChatGPT)来使模型更易获取,但在LMSYS成立后不久,其研究人员对AI基准测试的现状感到不满,认为有必要创建自己的测试工具。
研究人员在三月发表的一篇技术论文中写道:“当前的基准测试未能充分满足最先进[模型]的需求,特别是在评估用户偏好方面”,“因此,迫切需要基于人类偏好的开放实时评估平台,以更准确地反映现实世界的使用情况。”
正如我们之前所写的那样,当今最常用的基准测试在捕捉普通人如何与模型互动方面做得很差,许多基准测试所探测的技能——例如解决博士级别的数学问题——对于大多数使用Claude的人来说很少相关。
LMSYS 的创建者也有类似的感受,因此他们设计了一种替代方案:Chatbot Arena,这是一个众包基准测试平台,旨在捕捉模型及其在开放式、真实世界任务中表现的“细微”差异。
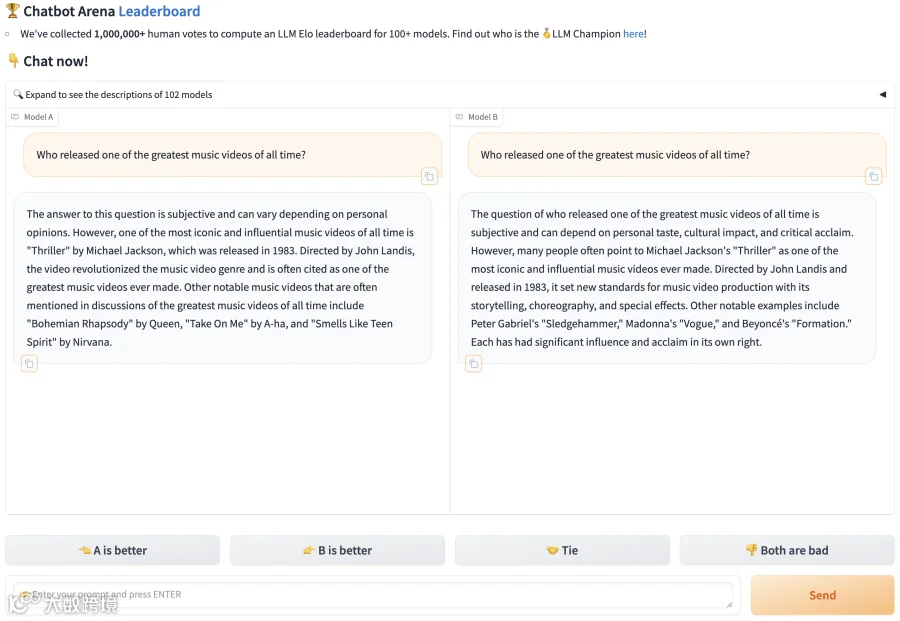
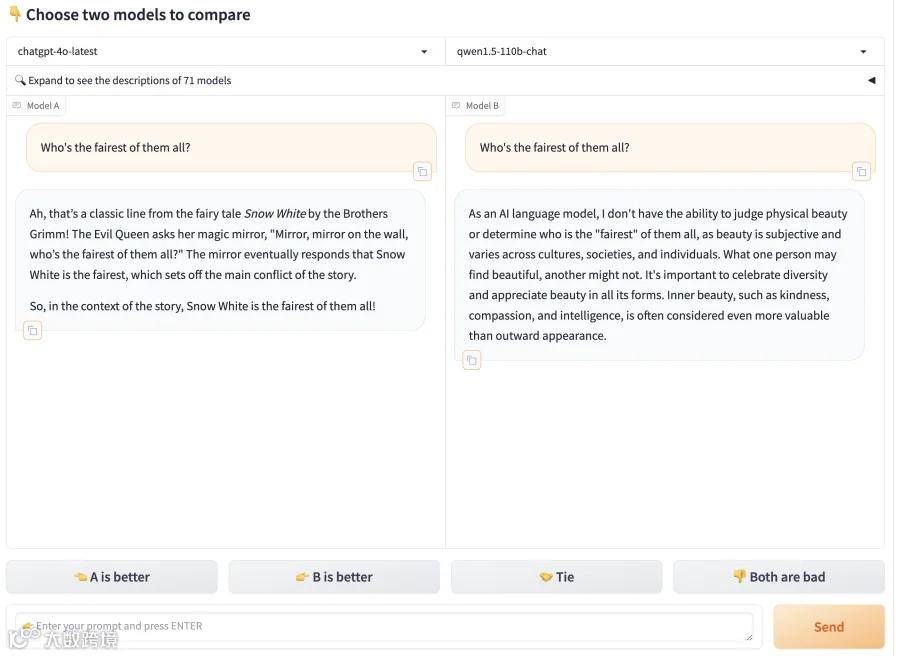
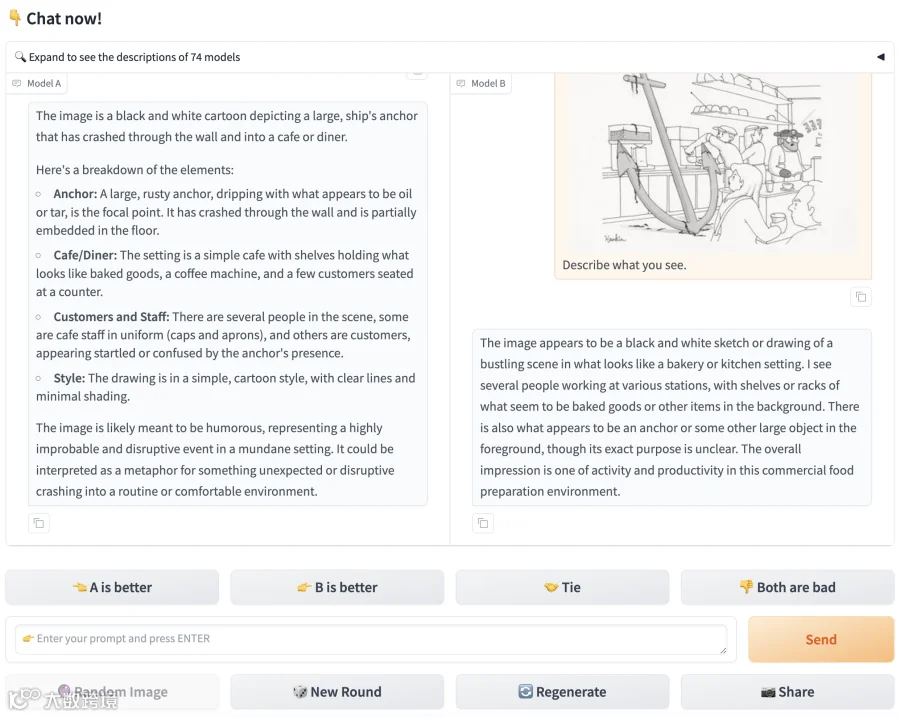
Chatbot Arena 允许任何互联网用户向两个随机选择的匿名模型提问(或多个问题)。一旦用户同意服务条款,允许其数据用于 LMSYS 未来的研究及相关项目,他们就可以从两个对抗模型的回答中选择自己偏好的答案(也可以声明平局或表示“两者都很差”),此时模型的 identities 才会被揭晓。
研究人员在三月的论文中写道,这一流程产生了一个“多样化的”典型用户可能会向任何生成式模型提出的问题集合。“凭借这些数据,我们采用了一系列强大的统计技术……以尽可能可靠且样本高效地估计模型的排名。”他们解释道。
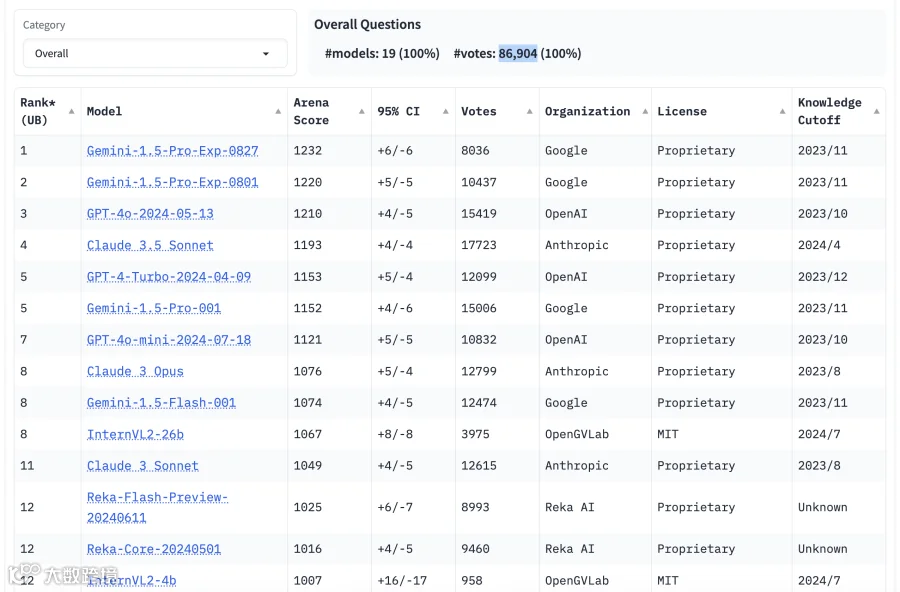
自Chatbot Arena推出以来,LMSYS在其测试工具中添加了数十个开源模型,并与穆罕默德·本·扎耶德人工智能大学 (MBZUAI)等大学以及包括OpenAI、Google、Anthropic、Microsoft、Meta、Mistral和Hugging Face在内的公司合作,使其模型可供测试,目前Chatbot Arena包含超过100个模型,包括能够理解除文本以外数据的 multimodal 模型,如OpenAI的GPT-4o和Anthropic的Claude 3.5 Sonnet。
已有超过一百万个提示词和回答对以此方式提交并评估,产生了庞大的排名数据体系。
偏见与缺乏透明度
在三月的论文中,LMSYS 的创始人声称,Chatbot Arena 的用户贡献问题“足够多样化”,可用于对一系列 AI 应用场景进行基准测试。“凭借其独特的价值和开放性,Chatbot Arena 已成为引用率最高的模型排行榜之一。”他们写道。
但结果究竟有多少信息量呢?这仍有待商榷。
Yuchen Lin是非营利组织艾伦人工智能研究所的研究科学家,他表示LMSYS在Chatbot Arena上评估模型能力、知识和技能方面并未完全透明,今年三月,LMSYS发布了一个包含一百万条用户在Chatbot Arena上与25个模型对话的数据集LMSYS-Chat-1M,但此后未再更新该数据集。
Lin 表示:“评估不可复现,且 LMSYS 发布的数据有限,使得深入研究模型的局限性变得具有挑战性。”
就 LMSYS 已经 详细说明了其测试方法而言,其研究人员在三月的论文中表示,他们利用“高效的采样算法”将模型相互对抗,“以一种加速排名收敛同时保持统计有效性的方式”。他们写道,LMSYS 在刷新 Chatbot Arena 排名之前,每个模型大约收集 8,000 票,而达到这一阈值通常需要几天时间。
但Lin认为,投票没有考虑人们发现或无法发现模型幻觉的能力,也没有考虑偏好的差异,这使得他们的投票不可靠。例如,一些用户可能更喜欢较长的、markdown格式的回答,而另一些用户则可能更偏好简洁的回复。
这里的结果是,两个用户可能对同一组答案给出相反的回答,且两者都同样有效——但这从根本上质疑了该方法的價值。直到最近,LMSYS才开始在Chatbot Arena中尝试控制模型的“风格”和“实质”进行实验。
Lin 表示:“所收集的人类偏好数据并未考虑这些细微的偏见,且该平台未区分‘A 明显优于 B’和‘A 仅略优于 B’的情况。”“虽然后处理可以缓解其中一些偏见,但原始的人类偏好数据仍然充满噪声。”
Mike Cook是伦敦国王学院的高级讲师,专攻AI和游戏设计,他同意Lin的评估。“你完全可以在1998年运行Chatbot Arena,并依然谈论剧烈的排名变化或大型强力聊天机器人,但它们会很糟糕,”他补充道,指出虽然Chatbot Arena被定位为一项实证测试,但它实际上是对模型的相对评级。
笼罩在 Chatbot Arena 头顶的更具问题的偏见,是其用户群体的当前构成。
Lin 表示,由于该基准测试几乎完全通过 AI 和科技行业圈子内的口碑传播而变得流行,它不太可能吸引到具有代表性的人群。支持他这一理论的是,LMSYS-Chat-1M 数据集中排名靠前的问题涉及编程、AI 工具、软件漏洞及修复和应用设计——这些并非非技术人员通常会询问的内容。
Lin 说:“测试数据的分布可能无法准确反映目标市场真实的人类用户。”“此外,该平台的评价过程在很大程度上是不可控的,主要依赖后处理来为每个查询标记各种标签,然后用于开发特定任务的评价指标。这种方法缺乏系统性的严谨性,使得仅基于人类偏好来评估复杂推理问题变得具有挑战性。”
Cook 指出,由于 Chatbot Arena 的用户是自我选择的——他们本身就对测试模型感兴趣——他们可能不太愿意对模型进行压力测试或将其推向极限。
Cook 说:“总的来说,这不是一种好的研究方式。”“评估者提出问题并投票选出哪个模型‘更好’——但 LMSYS 在任何地方都没有真正定义‘更好’。在这个基准测试中表现优异可能会让人们认为获胜的 AI 聊天机器人更人性化、更准确、更安全、更值得信赖等等——但这实际上并不意味着任何事情。”
LMSYS正试图通过使用自动化系统——MT-Bench和Arena-Hard-Auto——来平衡这些偏见,这些系统利用模型本身(OpenAI的GPT-4和GPT-4 Turbo)对其他模型回答的质量进行排名。(LMSYS将这些排名与投票一起发布)。然而,尽管LMSYS声称模型“很好地匹配了受控和众包的人类偏好”,此事远未尘埃落定。
商业联系与数据共享
Lin 表示,LMSYS 日益增长的商业联系是另一个需要对其排名持保留态度的原因。
像OpenAI这样通过API提供其模型的一些供应商可以访问模型使用数据,如果他们愿意,这些数据可以被用来实质上“针对考试教学”。Lin表示,这使得对运行在LMSYS自有云上的开放、静态模型的测试过程可能不公平。
他补充道:“公司可以不断优化其模型,以更好地适应 LMSYS 的用户分布,这可能导致不公平竞争和评价意义的降低。”“通过 API 连接的商业模型可以访问所有用户输入数据,这使得拥有更多流量的公司占据优势。”
Cook 补充说:“LMSYS 所做的并不是鼓励新颖的 AI 研究或类似的事情,而是鼓励开发者微调细微细节,以便在措辞上相对于竞争对手获得微小的优势。”
LMSYS 的部分赞助来自一些组织,其中一家是一家在 AI 竞赛中下注的风险投资公司(VC firm)。
Google的Kaggle数据科学平台已向LMSYS捐款,Andreessen Horowitz(其投资包括Mistral)和Together AI也是如此。Google的Gemini模型以及Mistral和Together的模型都在Chatbot Arena上。
LMSYS在其网站上表示,它还依靠大学拨款和捐赠来支持其基础设施,并且其所有赞助——包括硬件和云计算计算额度以及现金——都“没有任何附加条件”。但这些关系给人的印象是,LMSYS并非完全中立,尤其是随着供应商越来越多地使用Chatbot Arena来为他们的模型制造期待。
LMSYS 未回应 TechCrunch 的采访请求。
更好的基准测试?
Lin 认为,尽管存在缺陷,LMSYS 和 Chatbot Arena 仍提供了有价值的服务:提供关于不同模型在实验室外表现的实时见解。
Lin 说:“Chatbot Arena 超越了传统的针对多项选择基准测试进行优化的方法,这些基准测试通常已饱和且不能直接应用于现实场景。”“该基准测试提供了一个统一的平台,让真实用户能够与多个模型互动,从而提供更动态和现实的评价。”
但——随着 LMSYS 继续为 Chatbot Arena 添加功能,例如更多的自动化评估——Lin 认为该组织仍有容易实现的改进空间,可以着手提升测试质量。
他提出,为了更“系统化”地理解模型的优势与劣势,LMSYS 可以围绕不同的子主题(如线性代数)设计基准测试,每个子主题配备一组领域特定的任务。他表示,这将使 Chatbot Arena 的结果具有更强的科学分量。
Lin 表示:“虽然 Chatbot Arena 可以提供用户体验的快照——尽管来自一个规模较小且可能不具备代表性的用户群体——但它不应被视为衡量模型智能的决定性标准。相反,它更适合作为衡量用户满意度的工具,而非衡量 AI 进步的科学客观指标。”