


人工智能正逐步渗透至生物技术和制药研究的各个角落,但落地实施往往难以顺畅。Converge Bio打造了一款工具,使专注于生物学的语言模型真正发挥作用,涵盖从“丰富”数据到解释答案的全过程。该公司已完成550万美元种子轮融资,以扩大产品规模。
“模型只是模型,这还不够。”首席执行官兼联合创始人多夫·格茨(Dov Gertz)表示,“必须构建一个流水线,让公司能够真正将模型应用于自身的研发流程中。市场非常分散,但制药和生物技术公司希望以整合的方式、在一个平台上使用这项技术。我们希望成为那个平台。”
基础模型在专业领域的落地挑战
目前存在强大的基础模型,这些大型语言模型并非在书籍和互联网上训练,而是在包含海量DNA、蛋白质结构和基因组学数据的大型数据库上进行训练。
这些模型强大且多功能,但与ChatGPT等产品类似,需要大量工作才能被塑造成日常可用的形态。这种工作在微生物学或免疫学等专业领域尤其困难。将一个基于数十亿蛋白质序列训练的“原始”LLM转化为实验室技术人员常规研究工具,是一个非平凡的问题。
例如抗体研究,虽已有针对其特定生物学训练的大型语言模型,但过于通用。Converge Bio提供了一系列改进措施,可在安全前提下利用公司自身的数据知识产权(IP)进行实施。

数据增强与可解释性突破
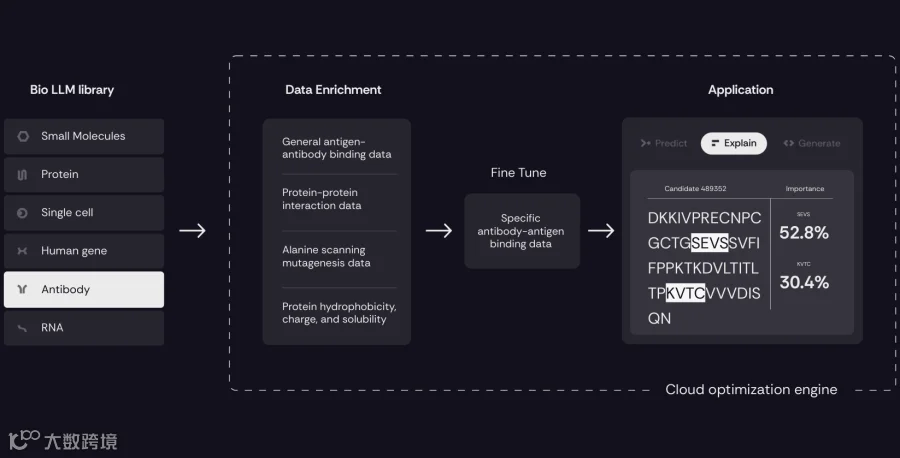
第一步是“数据增强”,即通过抗原-抗体相互作用和蛋白质-蛋白质相互作用等重要相关数据来扩充抗体大型语言模型。随后,凭借更具体的知识,该模型可以针对团队希望靶向的特定抗原进行微调,而团队可能拥有该抗原的专有体外实验数据。
Gertz表示:“如今我们已开发出具体应用:输入是一段序列,输出则是结合亲和力。”随后该平台提供了另一重要层面——可解释性。研究人员可以深入剖析输出结果,不仅了解“该序列比另一序列更有效”,还能精确到氨基酸或碱基对层面,找出序列中究竟是哪一部分在促使其表现更佳。
最后,它生成能带来更好结果的新序列,同时具备可解释性。格茨指出,其可解释性在客户中广受欢迎,出乎他们的意料——这很合理,因为它允许专家将其领域专业知识(例如蛋白质相互作用)应用到这一较新且更为晦涩的生物信息学和机器学习领域。
构建竞争壁垒与市场定位
Converge使用了众多开源和免费的基础模型,但也正在开发自己的模型。格茨表示,他们已拥有一套专有的可解释性处理流程。此外,数据增强的“课程”也完全由他们自主设计——这并非易事。他指出,训练方法是少数几家最成功的AI公司严格保密的秘密之一。
这是他们希望构建的竞争壁垒的一部分,正如格茨所言:“这可能是五十年来生物技术领域最大的机遇。”
然而,许多(或许大多数)生物技术公司并没有专门针对其领域内大型语言模型相关工作的解决方案,而是积极追求那些通用解决方案无法覆盖的细分领域。
“我们的目标是成为生物技术领域生成式AI的‘万物商店’,然后以此为切入点,逐步提供更多服务。”Gertz表示,“在制药和生物领域,一旦企业与某家供应商建立了信任关系,他们就会希望在其他应用场景中也使用其服务,无论是抗体设计还是疫苗设计。因此,我认为这种定位在当前市场环境下是最优选择。”
融资进展与未来规划
投资者似乎对此表示认同,由TLV Partners领投的种子轮融资已筹集550万美元。
该公司将像初创企业在此阶段通常所做的那样,利用这笔资金进行招聘并拓展客户,同时还将发表一篇关于抗体设计的科学论文(当然使用的是其自有系统),并训练“一个真正的基础模型”。