


市面上出现了一个新的 AI 模型家族,它是少数几个能够从头开始复现的模型之一。
周二,由已故微软联合创始人保罗·艾伦创立的非营利 AI 研究机构 Ai2 发布了 OLMo 2,这是其 OLMo 系列中的第二个模型家族(OLMo 是“open language model”的缩写)。虽然可供选择的“开放”语言模型并不少(例如 Meta 的 Llama),但 OLMo 2 符合开源倡议组织对开源 AI 的定义,这意味着用于开发它的工具和数据都是公开可用的。
长期致力于定义和“守护”所有开源事物的开源倡议组织于十月 finalized 了其开源 AI 定义。而首批 OLMo 模型于二月发布时,也已符合这一标准。
完全开源的开发理念
Ai2 在博客文章中写道:“OLMo 2 [从始至终] 使用开放且可访问的训练数据、开源训练代码、可复现的训练配方、透明的评估、中间检查点等进行了开发。通过公开分享我们的数据、配方和研究成果,我们希望为开源社区提供发现新方法和创新方法所需的资源。”
模型规格与性能表现
OLMo 2 家族包含两个模型:一个拥有 70 亿参数(OLMo 7B),另一个拥有 130 亿参数(OLMo 13B)。参数大致对应模型的解决问题能力,参数更多的模型通常比参数较少的模型表现更好。
与大多数语言模型一样,OLMo 2 7B 和 13B 可以执行一系列基于文本的任务,如回答问题、总结文档和编写代码。
为了训练这些模型,Ai2 使用了包含 5 万亿个 token 的数据集。Token 代表原始数据的片段;100 万个 token 大约等于 75 万个单词。训练集包括“经过高质量筛选”的网站、学术论文、问答讨论板以及“合成和人工生成”的数学练习册。
Ai2 声称,结果是性能上与 Meta 的 Llama 3.1 等开放模型具有竞争力的模型。
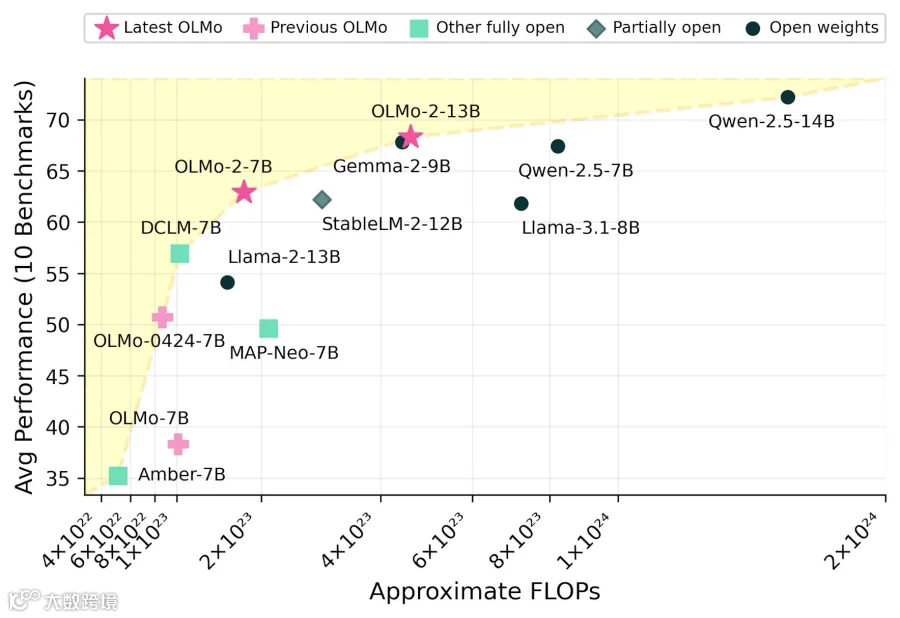
Ai2 表示:“与我们早期的 OLMo 模型相比,我们不仅观察到在所有任务上的性能都有显著提升,而且值得注意的是,OLMo 2 7B 的表现优于 Llama 3.1 8B。OLMo 2 [代表了] 迄今为止最好的完全开源语言模型。”
OLMo 2 模型及其所有组件均可从 Ai2 的网站下载,采用 Apache 2.0 许可证,允许商业使用。
关于开源安全性的探讨
最近关于开源模型的安全性存在一些争议,因为据报道 Llama 模型被中国研究人员用于开发防御工具。当被问及是否担心 OLMo 被滥用时,Ai2 工程师 Dirk Groeneveld 表示相信最终的好处大于危害。
他指出:“是的,开源模型可能会被不当使用或用于非预期目的。然而,这种方法也促进了推动更道德模型的技术进步;是验证和可复现性的先决条件,因为只有在获得完整技术栈的情况下才能实现这些目标;并减少了日益集中的权力,创造了更加公平的访问机会。”