


随着企业将生成式人工智能从原型测试转向实际部署,对成本的敏感度日益提升。为降低大型语言模型(LLM)的使用成本,AWS在re:Invent大会上宣布为Bedrock托管服务推出两项新功能:提示词缓存与智能路由。
提示词缓存:降本提速
Bedrock产品总监阿图尔·德奥(Atul Deo)指出,针对同一文档的重复提问会导致不必要的费用支出,且上下文窗口正不断扩展(如Nova支持30万至200万token)。缓存功能可避免模型对相同或高度相似查询进行重复处理。
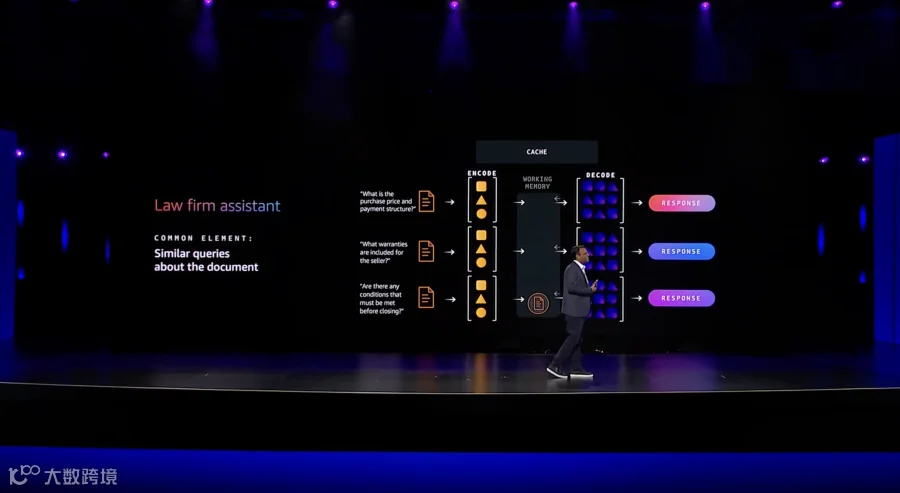
据AWS数据,该功能最高可降低90%的成本,并将响应延迟减少高达85%。Adobe在实际测试中发现,其生成式AI应用的响应时间减少了72%。
智能提示词路由:平衡性能与成本
Bedrock新增的智能路由功能可自动将提示词分发至同一模型系列中的不同模型。系统利用小型语言模型预测各模型表现,从而实现性能与成本的最佳平衡。
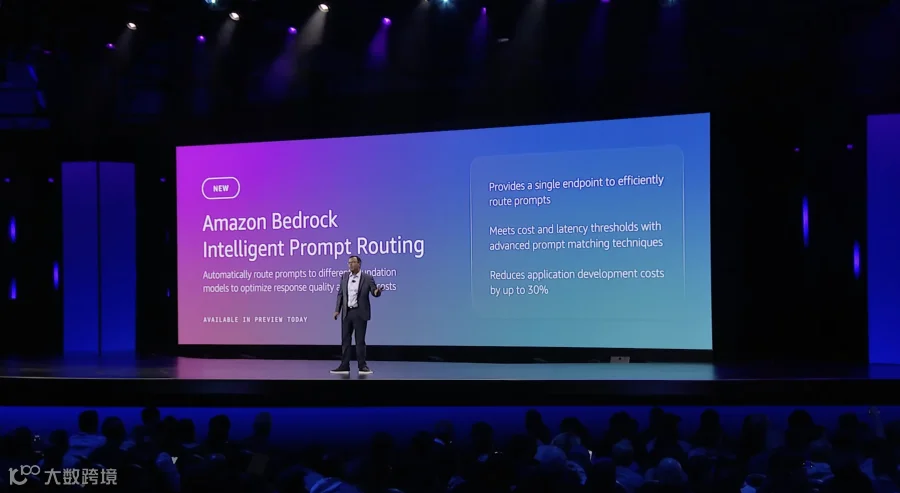
德奥表示,简单查询无需调用昂贵的大型模型。智能路由能在运行时根据提示词特征,自动匹配最合适的模型。尽管目前仅限于同系列模型路由,但未来计划扩展更多自定义选项。
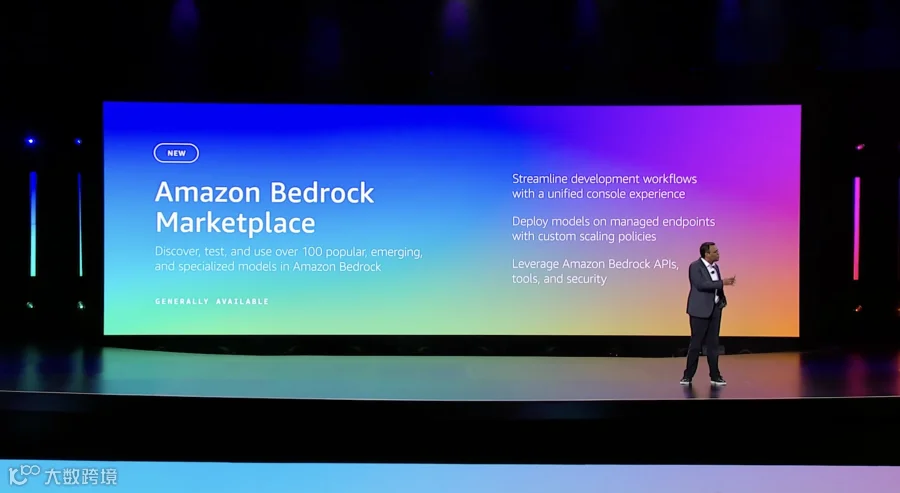
专业模型市场
AWS还推出了面向Bedrock的新市场,以支持数百款受众较小的专业模型。与标准服务不同,用户需自行配置和管理基础设施容量。目前该平台提供约100款新兴及专业模型,未来将持续扩充。