


谷歌DeepMind宣布推出下一代视频生成AI模型Veo 2,旨在视频生成领域超越OpenAI。Veo 2支持以最高4K(4096×2160像素)分辨率生成长度超两分钟的短片,理论性能显著优于Sora。
目前,Veo 2仅在实验性工具VideoFX中可用,输出被限制为720p分辨率和8秒时长。DeepMind产品副总裁Eli Collins表示,随着模型准备就绪,未来将通过Vertex AI平台提供Veo 2,并计划明年分享更多更新。
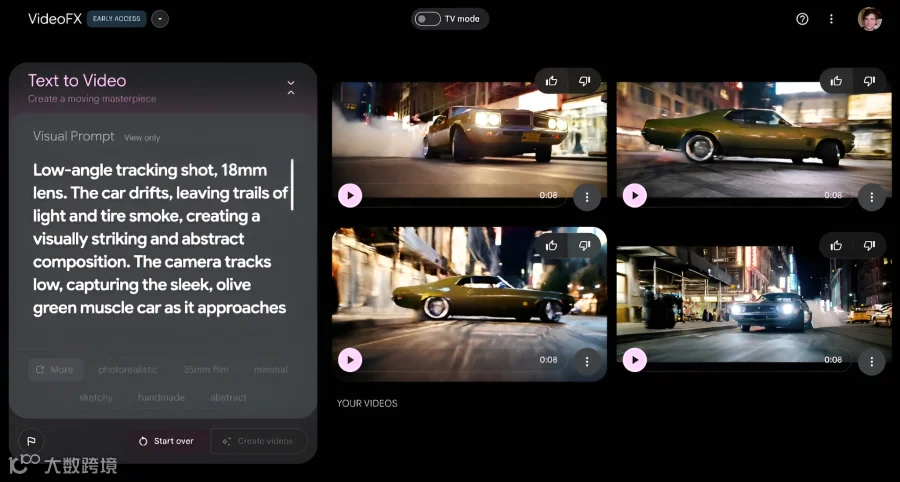
更具可控性
Veo 2延续了文本提示及“文本+参考图像”的生成方式,并在以下方面实现升级:
- 画质提升:纹理与图像更锐利,尤其在动态场景中表现更佳;
- 相机控制:可精确定位虚拟摄像机位置,多角度捕捉物体与人物;
- 物理模拟:更真实地还原运动、流体动力学(如液体倾倒)及光影特性(阴影、反射);
- 细节表现:支持多种镜头语言、电影特效及细腻的人类表情。
实测样本显示,Veo 2在处理折射现象、复杂液体及皮克斯风格动画方面表现出色。但模型仍存在局限,如角色眼神空洞、背景融合异常及建筑物理逻辑错误等“恐怖谷”效应。Collins承认,连贯性、角色一致性及复杂动作生成仍是待改进领域。DeepMind正与Donald Glover等创意人士合作,持续优化模型。
安全与训练
Veo 2基于高质量“视频-描述配对”数据训练,YouTube可能是数据来源之一。尽管DeepMind提供了爬虫屏蔽工具,但未开放从现有训练集中移除作品的机制,坚持公开数据训练属于合理使用。
针对生成风险,DeepMind采取了以下措施:
- 内容过滤:引入提示词级过滤器,拦截暴力、血腥及露骨内容;
- 版权保护:推出赔偿政策,为特定客户的版权侵权指控提供辩护(Veo 2全面开放后适用);
- 深度伪造防范:使用专有水印技术SynthID嵌入不可见标记,但该技术并非万无一失。
Imagen 3 升级
同期,Google DeepMind对商业图像生成模型Imagen 3进行升级,新版本已上线ImageFX。升级后的模型能生成更明亮、构图更优的写实、印象派及动漫风格图像,且对提示词的遵循度更高,细节纹理更丰富。
ImageFX界面同步更新:输入提示词时,关键词将转化为带下拉菜单的“芯片”,用户可通过选择建议词汇或自动生成的描述符快速迭代修改内容。
