


当一家公司发布新的AI视频生成器时,很快有人就用它制作了一段演员威尔·史密斯吃意大利面的视频。这也成了一个梗以及一个基准:看看新的视频生成器能否逼真地渲染史密斯吸溜一碗面条的场景。
Google Veo 2已经做到了这一点。我们终于开始吃意大利面了。
威尔·史密斯和意大利面只是2024年在AI社区引发热潮的多个离奇的“非官方”基准之一。一名16岁的开发者开发了一款应用,让AI控制《我的世界》并测试其设计结构的能力;此外,一位英国程序员创建了一个平台,让AI在《画猜》和《四子棋》等游戏中互相对战。
其实并不缺乏对AI性能进行学术评估的测试。那么,为什么那些更奇特的测试会突然爆火呢?
行业标准基准与大众需求脱节
首先,许多行业标准的AI基准对普通人来说意义不大。公司经常引用其AI回答数学奥林匹克竞赛问题或解决博士级难题的能力,然而大多数人使用聊天机器人主要是为了回复邮件和进行基础调研。
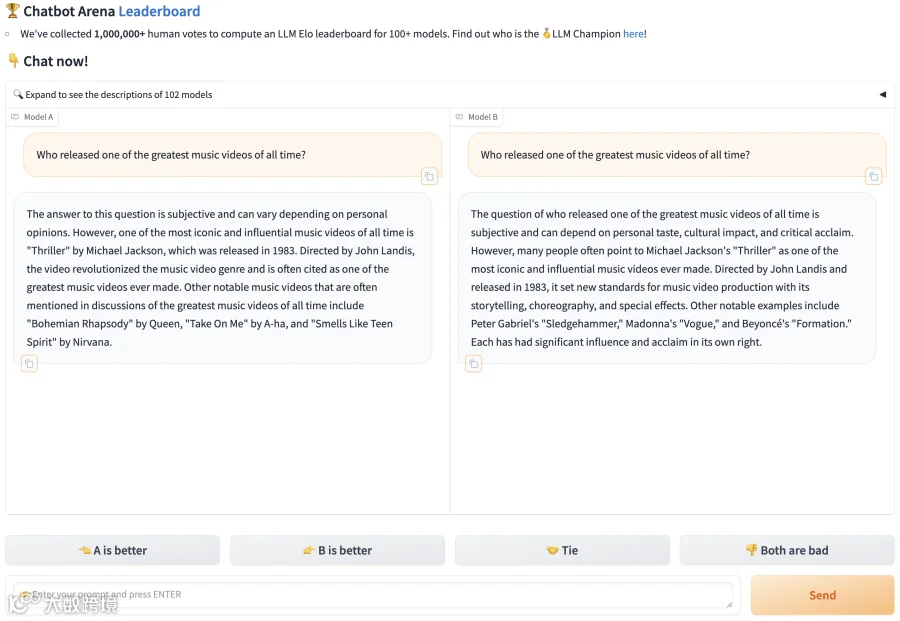
众包式的行业指标未必更好或更具信息量。以Chatbot Arena为例,这是一个许多AI爱好者和开发者痴迷跟踪的公开基准,允许网民对AI在特定任务中的表现进行评分。但评分者往往不具备代表性——大多数来自AI和科技行业圈子——并且他们的投票基于个人且难以捉摸的偏好。
缺乏与普通人的横向对比
沃顿商学院管理学教授伊桑·莫利克指出,许多AI行业基准存在的另一个问题是:它们没有将系统的性能与普通人的表现进行比较。“在医学、法律、建议质量等领域,竟然没有来自不同机构的30种不同的基准测试,这实在令人遗憾,因为人们无论如何都在使用这些系统。”Mollick写道。
奇特基准的价值在于易懂与趣味
像《四子棋》、《我的世界》和威尔·史密斯吃意大利面这类奇怪的AI基准肯定不具备实证性,甚至也不具备多少可推广性。仅仅因为AI通过了威尔·史密斯测试,并不意味着它就能很好地生成汉堡图片。
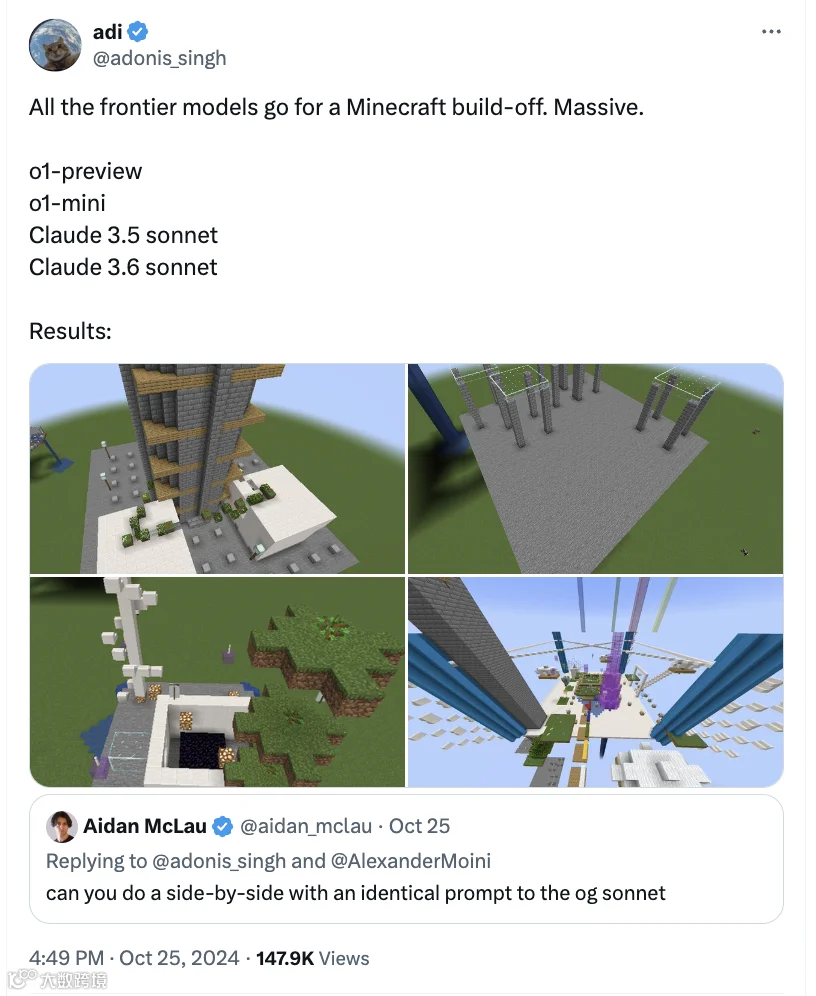
有专家建议,AI社区应关注AI的下游影响,而不是其在狭窄领域内的能力。但我感觉这些奇怪的基准不会很快消失。不仅因为它们有趣——谁不喜欢看AI建造《我的世界》城堡呢?——而且它们易于理解。正如我的同事Max Zeff最近所写的,该行业仍在努力将AI这样复杂的技术提炼为易于消化的营销内容。
我脑海中唯一的问题是,2025年哪些奇特的新基准测试会走红?