


英伟达正着手开发世界模型,这些AI模型从人类自然形成的对世界的心理模型中汲取灵感。
在拉斯维加斯举行的CES 2025上,该公司宣布将公开提供一系列能够预测和生成“物理感知”视频的世界模型。英伟达将这一系列模型称为Cosmos世界基础模型(Cosmos World Foundation Models),简称Cosmos WFMs。
这些模型可根据特定应用进行微调,可通过英伟达的API和NGC目录、GitHub以及AI开发平台Hugging Face获取。
英伟达在向TechCrunch提供的博客文章中写道:“英伟达正在推出首批用于基于物理的模拟和合成数据生成的Cosmos WFM模型。研究人员和开发人员,无论公司规模大小,都可以在英伟达宽松的开源模型许可下自由使用Cosmos模型,该许可允许商业使用。”

Cosmos WFM家族包含多个模型,分为三类:Nano适用于低延迟和实时应用,Super是“高性能基线”模型,Ultra则用于实现最高质量和保真度的输出。
这些模型的参数量从40亿到140亿不等,其中Nano最小,Ultra最大。参数量大致对应模型的解决问题能力,参数量较多的模型通常比参数量较少的模型表现更好。
作为Cosmos WFM的一部分,英伟达还发布了一种“超分辨率模型”、一种针对增强现实优化的视频解码器,以及确保负责任使用的护栏模型,还有用于为自动驾驶汽车开发生成传感器数据等应用的微调模型。英伟达表示,这些模型以及其他Cosmos WFM模型均在9万万亿个token上进行了训练,这些数据来自2000万小时的真实人类互动、环境、工业、机器人和驾驶数据。(在AI领域,“token”代表原始数据的片段——在本例中即为视频片段。)
英伟达并未透露这些训练数据的来源,但至少有一份报告指控该公司未经许可使用了受版权保护的YouTube视频进行训练。
TechCrunch联系其寻求评论时,英伟达发言人表示,Cosmos“并非旨在复制或侵犯任何受保护的作品。”
该发言人称:“Cosmos的学习方式与人类相似。为了帮助Cosmos学习,我们从各种公开和私人来源收集了数据,并确信我们对数据的使用符合法律的字面和精神。关于世界运作方式的事实——即Cosmos模型所学习的内容——不受版权保护,也不受任何个人作者或公司的控制。”
暂且不论像Cosmos这样的模型并不真正像人类那样学习这一事实,版权专家表示,英伟达等公司援引合理使用法律原则的主张可能无法通过司法审查。这些公司能否胜诉,很大程度上取决于法院如何裁定适用于AI训练的合理使用原则,即在作品具有转换性的前提下,允许使用受版权保护的作品来创造新事物。
英伟达声称,Cosmos WFM模型在接收文本或视频帧后,能够生成“可控、高质量”的合成数据,从而为机器人、无人驾驶汽车等模型的训练提供初始支持。
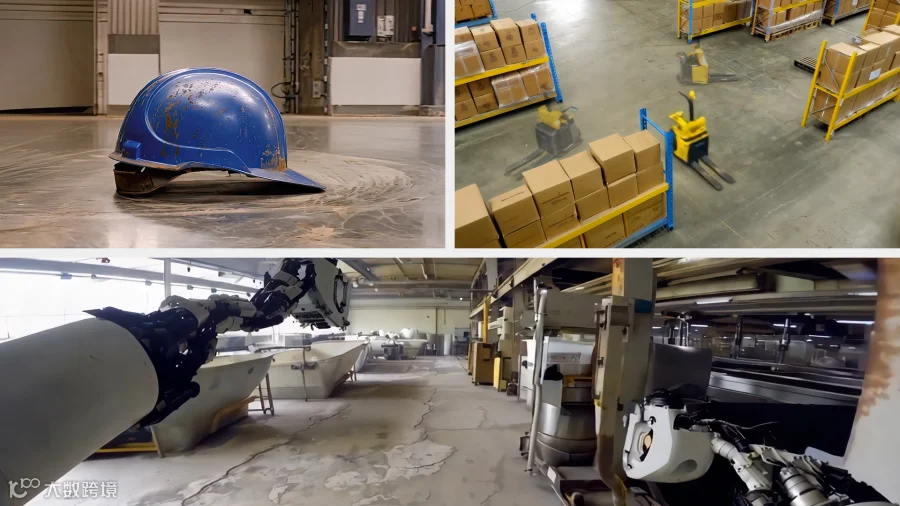
英伟达在新闻稿中写道:“英伟达Cosmos的开放模型套件意味着开发人员可以使用数据集(如自动驾驶车辆行程的视频记录或机器人在仓库中导航的视频)对WFMs进行定制。Cosmos WFMs专为物理AI研发而设计,能够从文本、图像和视频等多种输入组合以及机器人传感器或运动数据中生成基于物理学的视频。”
英伟达表示,包括Waabi、Wayve、Foretellix和Uber在内的多家公司已承诺试点应用Cosmos WFMs,用于从视频搜索和策展到构建自动驾驶汽车AI模型等各种用例。
Uber首席执行官Dara Khosrowshahi在一份声明中表示:“生成式AI将推动未来出行的发展,这需要丰富的数据和强大的计算能力。通过与英伟达合作,我们坚信能够帮助加速行业安全且可扩展的自动驾驶解决方案的时间表。”
需要注意的是,英伟达的世界模型在最严格意义上并非“开源”。为了符合一种广泛接受的“开源”AI定义,AI模型必须提供足够的设计信息,使个人能够“实质性”地重新创建它,并披露有关其训练数据的任何相关细节,包括数据来源以及获取或许可数据的方式。
Nvidia尚未公布Cosmos WFM的训练数据详情,也没有提供从头开始重建模型所需的所有工具。这大概也是这家科技巨头将模型称为“开放”而非“开源”的原因。
Nvidia首席执行官Jensen Huang在周一的一场媒体活动上表示:“我们真心希望[Cosmos]能在机器人和工业AI领域,实现Llama……在企业领域所取得的成就。”