


周六,Triplegangers 首席执行官 Oleksandr Tomchuk 收到警报,称公司电商网站无法访问。起初疑似分布式拒绝服务(DDoS)攻击,但很快发现罪魁祸首是 OpenAI 的机器人 GPTBot,它正试图抓取整个网站。
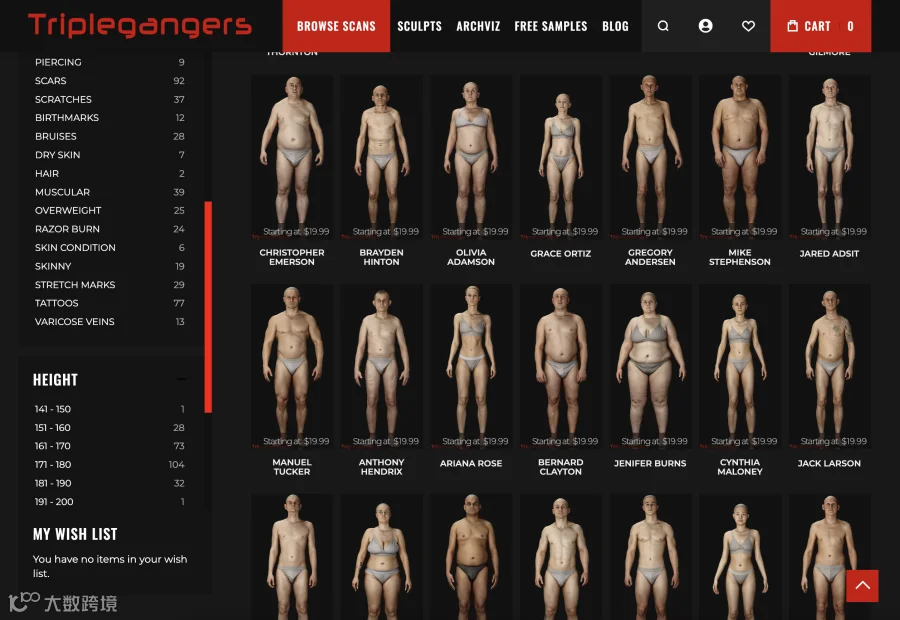
“我们有超过 65,000 种产品,每个页面至少有三张照片。”Tomchuk 表示。OpenAI 发送了数万次服务器请求,使用 600 多个 IP 地址试图下载所有内容,包括数十万张照片及详细描述。“他们的爬虫正在压垮我们的网站,这基本上就是一次 DDoS 攻击。”
Triplegangers 拥有七名员工,花费十多年构建了网络上最大的“人类数字替身”数据库,即从真实人体模特扫描而来的 3D 图像文件,出售给 3D 艺术家、游戏开发者等。尽管网站有禁止未经授权使用的服务条款,但若未正确配置 robots.txt 并添加明确指示标签,这些条款并无实际作用。
Robots Exclusion Protocol(机器人排除协议)旨在告知搜索引擎不应抓取的内容。OpenAI 声称会遵守该协议,但也警告机器人可能需要长达 24 小时才能识别更新的文件。若网站未正确使用 robots.txt,OpenAI 等公司默认可以随意抓取,这并非选择加入机制。
此外,由于机器人的 CPU 占用和下载活动,Tomchuk 预计 AWS 账单将大幅上涨。值得注意的是,robots.txt 并非万无一失,AI 公司仅自愿遵守;此前 Perplexity 就曾因被指未遵守该规定而引发争议。
无法确定具体被抓取了什么
周三,在连续几天遭受攻击后,Triplegangers 已正确配置 robots.txt,并通过 Cloudflare 阻止了 GPTBot、Barkrowler 及 Bytespider 等爬虫。周四早上,网站恢复正常。
然而,Tomchuk 仍无法确切了解 OpenAI 获取了什么内容或如何移除材料。他找不到联系 OpenAI 的途径,对方也未回应置评请求,且迄今未能兑现承诺的数据退出工具。
这对 Triplegangers 尤为棘手,因其业务涉及真人扫描,受 GDPR 等法律严格保护,“他们不能随意抓取网络上任何人的照片并使用”。同时,该网站也是 AI 爬虫的优选目标,因其包含种族、年龄、体型等详细标记的照片,这正是 Scale AI 等公司训练模型所需的数据。
讽刺的是,正是 OpenAI 机器人的贪婪暴露了其行踪。Tomchuk 坦言,如果爬取更温和些,他根本不会察觉。他认为当前模式存在漏洞:企业需自行了解如何屏蔽机器人,而非由 AI 公司主动征求许可。
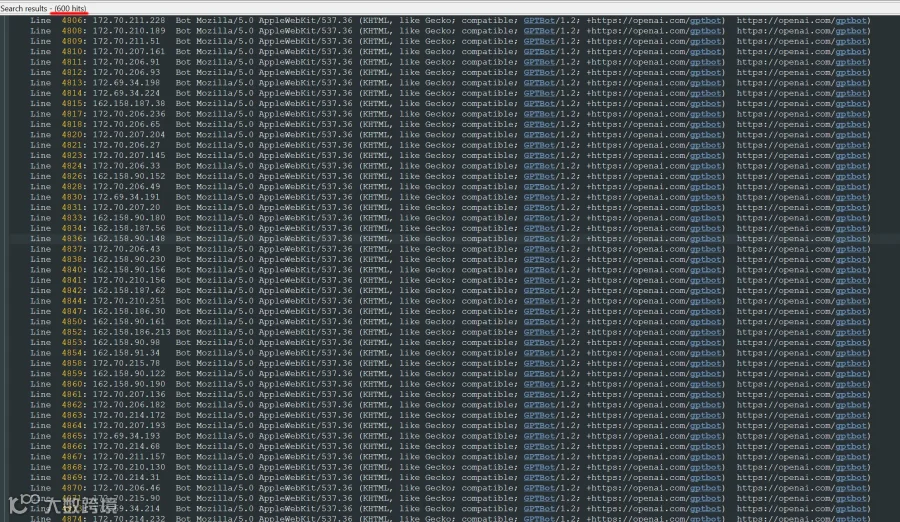
Tomchuk 希望其他小型在线企业知晓,发现 AI 机器人窃取内容的唯一方法是主动监控日志。据 DoubleVerify 研究,2024 年 AI 爬虫导致“一般无效流量”增加了 86%。大多数网站仍不知情,必须每天监控日志以防范此类风险。
这种运作模式犹如黑帮勒索:除非有保护措施,否则 AI 机器人会拿走它们想要的一切。“它们应该先征求许可,而不是仅仅爬取数据。”Tomchuk 强调。