


OpenAI 宣布推出全新 AI “智能体”——深度研究(Deep Research),旨在辅助 ChatGPT 用户开展深入、复杂的调研工作。
该功能专为金融、科学、政策及工程等领域的高强度知识工作者设计,满足其对全面、精确及可靠信息的需求。同时,对于购车、家电及家具等需审慎决策的消费场景,该工具同样适用。其核心价值在于突破快速摘要的局限,支持从多源渠道勤勉整合信息。
发布计划与使用方式
即日起,ChatGPT Pro 用户可优先体验深度研究功能,每月限 100 次查询;Plus、Team 及 Enterprise 版本将陆续上线。其中 Plus 版预计约一个月后推出,付费用户的查询额度也将显著提升。目前该功能尚未公布英国、瑞士及欧洲经济区的具体发布时间表。
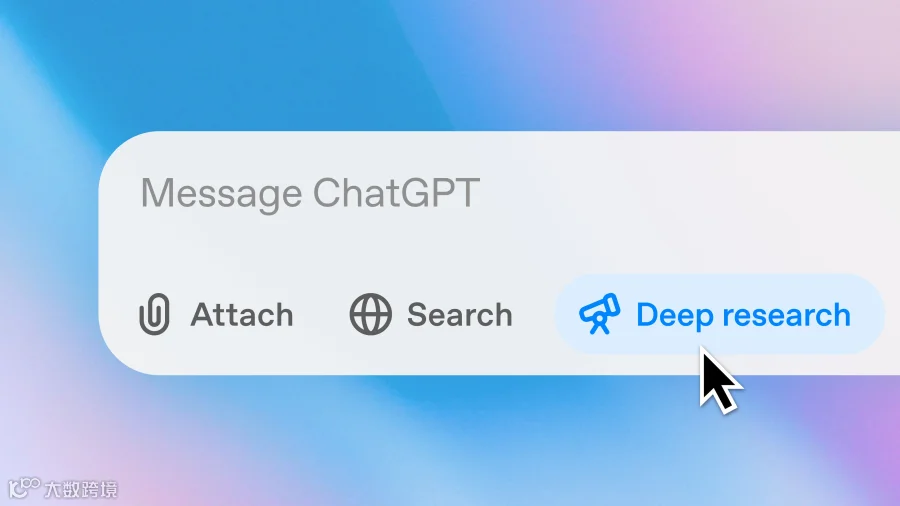
在网页端编辑器中选择“深度研究”并输入指令或上传文件即可启动任务,处理时长通常为 5 至 30 分钟,完成后系统将发送通知。移动端及桌面端应用集成将于本月晚些时候推出。
当前输出仅支持文本格式,但 OpenAI 计划尽快增加嵌入式图片、数据可视化及其他分析性内容。未来路线图还包括接入更多专业数据源,涵盖订阅制服务及内部资源。
准确性保障与技术底座
针对 AI 幻觉风险,OpenAI 强调深度研究的输出将完全记录思维过程并提供清晰引用,便于验证。尽管 ChatGPT Search 此前曾出现失误,但为提升深度研究准确性,OpenAI 采用了 o3 “推理”模型的特殊版本。该模型经强化学习训练,擅长浏览器操作与 Python 工具调用,能根据目标反馈自我优化。
o3 模型针对网页浏览和数据分析进行了专项优化,具备搜索、解释及分析海量文本、图像和 PDF 的能力,并能灵活调整策略。此外,它还能解析用户上传的文件,利用 Python 生成迭代图表,并在回复中嵌入图表、网站图片及精准引用来源段落。

性能表现与局限性
在包含 3,000 多个专家级问题的 Humanity’s Last Exam 基准测试中,驱动深度研究的 o3 模型准确率达 26.6%。虽然绝对值不高,但该测试标准极为严苛。相比之下,Gemini Thinking、Grok-2 及 GPT-4o 的得分分别为 6.2%、3.8% 和 3.3%,o3 模型优势显著。
不过,OpenAI 也坦承该功能存在局限:有时仍会出错或做出错误推断,难以区分权威信息与谣言,且在不确定时缺乏明确提示,报告引用也可能出现格式问题。
相比无引用的简单摘要,这种带详细出处的深度输出更具参考价值。但用户是否会真正进行交叉验证,还是仅将其视为专业文本直接复制粘贴,仍有待观察。值得注意的是,Google 也在不到两个月前宣布了同名 AI 功能。