


每周日,NPR主持人、《纽约时报》填字游戏专家威尔·肖茨都会在长期节目“周日谜题”中向数千听众出题。尽管这些智力题旨在无需过多背景知识即可解答,但对熟练参赛者而言仍具挑战性。
正因如此,一些专家认为它们是测试AI解决问题能力极限的有前景方法。
创建AI基准测试:揭示推理模型的“放弃”行为
在最近一项研究中,来自韦尔斯利学院、欧柏林学院、德克萨斯大学奥斯汀分校、东北大学、查理大学及初创公司Cursor的团队,利用“周日谜题”谜语创建了AI基准测试。该测试揭示了令人惊讶的见解:包括OpenAI o1在内的推理模型有时会“放弃”,并提供明知不正确的答案。
东北大学计算机科学系教师、论文共同作者阿俊·古哈(Arjun Guha)表示:“我们希望开发一个仅凭一般常识人类就能理解的基准测试。”
现有基准困境与“周日谜题”的优势
当前AI基准测试面临困境:多数常用测试考察博士级数学和科学等与普通用户无关的技能;且许多基准(甚至新发布的)已迅速接近饱和点。
古哈指出,《周日谜题》的优势在于不考查深奥知识,且问题表述方式使模型无法依靠“死记硬背”解答。“这些难题之所以难,是因为解决前很难取得有意义进展——只有在解决时一切才会瞬间融会贯通,这需要洞察力与排除法的结合。”
当然,没有任何基准是完美的。《周日谜题》具有美国中心主义色彩且仅限英语。此外,由于测验公开可用,训练过相关数据的AI可能“作弊”,但古哈表示尚未发现此类证据。
他补充道:“每周发布新问题,可期待最新问题完全未被见过。我们打算保持基准新鲜度,并跟踪模型性能随时间的变化。”
推理模型表现与拟人化“沮丧”情绪
在由约600个“周日谜题”组成的基准测试中,o1和DeepSeek R1等推理模型表现远超其他模型。推理模型在给出结果前会彻底自我事实核查,有助于避免常见陷阱,但代价是耗时更长(通常多几秒到几分钟)。
至少有一个模型(DeepSeek R1)会针对某些题目给出明知错误的解答。R1会逐字说出“我放弃了”,然后看似随机选择错误答案——这种行为确实能让人类感同身受。
模型还会做出其他奇怪选择:如先给错误答案随即撤回试图推导更好答案但再次失败;陷入永远“思考”状态并对答案给出毫无逻辑的解释;或一开始得出正确答案却出于不明原因继续考虑备选答案。
古哈说:“在难题上,R1 literally(直白地)表示感到‘沮丧’。看到模型模仿人类语言很有趣,目前尚不清楚推理过程中的‘沮丧’情绪将如何影响结果质量。”

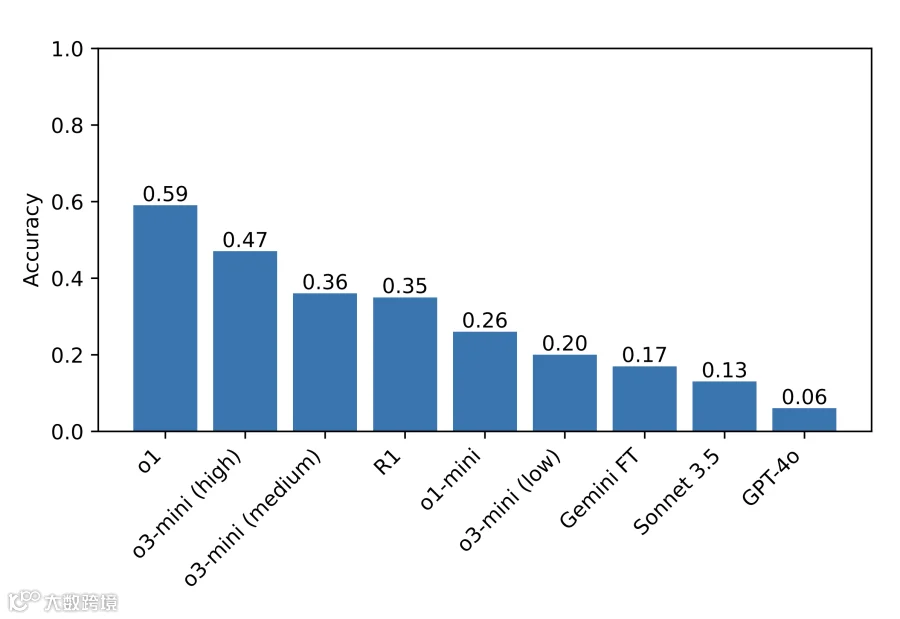
该基准测试中表现最佳的模型是o1(得分59%),其次是近期发布的高“推理努力”设置o3-mini(47%),R1得分为35%。作为下一步,研究人员计划将测试扩展到更多推理模型,以确定改进领域。
迈向更具包容性的推理基准测试
古哈强调:“你不需要博士学位也能擅长推理,因此应有可能设计出无需博士级知识的推理基准测试。更具包容性的基准允许更广泛的研究人员理解和分析结果,这可能带来未来更好的解决方案。此外,随着最先进AI模型越来越多部署到影响每个人的场景中,我们相信每个人都应能直观了解这些模型的能力所在及边界在哪里。”