


Anthropic 正式推出前沿 AI 模型 Claude 3.7 Sonnet,该模型支持用户按需自定义“思考”时长。
作为业界首款“混合 AI 推理模型”,Claude 3.7 Sonnet 集成了实时响应与深度推理能力。用户可自主激活推理功能,灵活控制模型的思考时间,兼顾效率与质量。
此举旨在简化 AI 产品体验。Anthropic 希望以单一模型替代传统复杂的多选项选择器,让用户无需在成本与功能间反复权衡,实现“一个模型完成所有工作”的理想状态。
Claude 3.7 Sonnet 将于周一面向所有用户及开发者开放。其中,推理功能仅限高级订阅用户使用;免费版提供标准非推理模式,性能据称优于前代 Claude 3.5 Sonnet(注:版本号直接跳过 3.6)。
定价方面,输入令牌为每百万 3 美元(约 75 万单词),输出令牌为每百万 15 美元。虽高于 OpenAI o3-mini 及 DeepSeek R1 等纯推理模型,但 Claude 3.7 Sonnet 具备独特的混合架构优势。
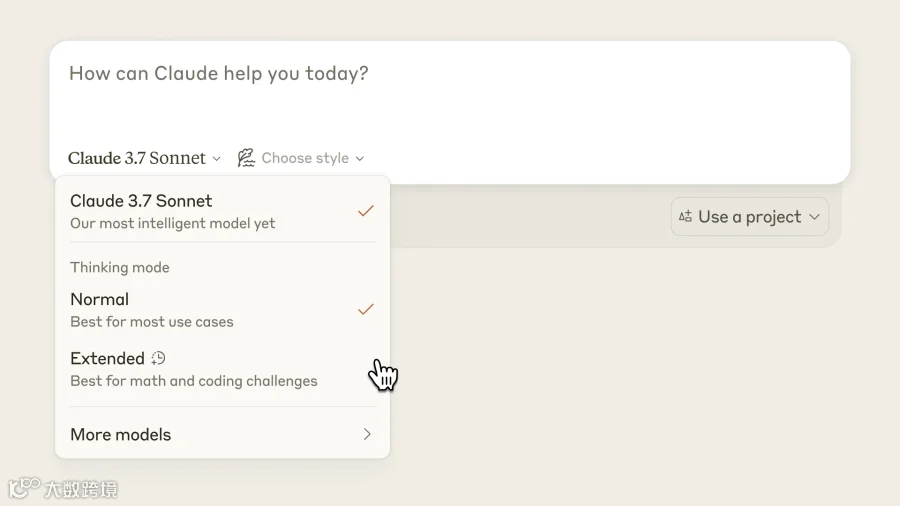
Claude 3.7 Sonnet 是 Anthropic 首款搭载“推理”能力的模型。随着传统性能提升手段触及瓶颈,该技术已成为行业主流趋势。
类似 o3-mini、R1 等推理模型,通过增加计算资源与时间将问题拆解细化,从而提升答案准确性。其过程基于演绎法建模,虽不同于人类思维,但逻辑更为严密。
Anthropic 产品与研究负责人 Dianne Penn 透露,未来模型或将自动判断所需思考时长,无需用户手动干预。
官方强调:“正如人类不会因问题难易而切换大脑,推理应是前沿模型的内置能力,与其他功能无缝集成,而非依赖独立模型。”
此外,模型通过“可见草稿纸”展示内部规划阶段。除涉及信任与安全的内容可能被删减外,用户通常可查看完整的思考过程。

针对编码难题或智能体任务等现实场景,Anthropic 对思考模式进行了专项优化。API 开发者可通过调节思考“预算”,在速度、成本与答案质量间取得平衡。
实测数据显示:在 SWE-Bench 编码测试中,Claude 3.7 Sonnet 准确率达 62.3%,显著高于 o3-mini 的 49.3%;在 TAU-Bench 零售交互测试中,得分为 81.2%,优于 OpenAI o1 的 73.5%。
安全性方面,新模型能更精准区分有害与良性提示,不必要的拒绝回答较 Claude 3.5 Sonnet 减少 45%,响应意愿显著提升。
同步推出的还有代理式编码工具 Claude Code(研究预览版)。开发者可在终端通过自然语言指令(如“解释项目结构”)驱动 Claude 分析代码库、修改文件、运行测试甚至推送至 GitHub,且编辑过程全程透明。
目前,Claude Code 采用“先到先得”机制,仅向有限用户开放。
尽管 Anthropic 一贯秉持稳健安全策略,但在竞品加速迭代的背景下,此次发布意在抢占行业先机。不过,OpenAI CEO Sam Altman 已暗示其混合 AI 模型或将在数月内面世,市场竞争格局仍充满变数。