


太平洋时间下午2:40更新:在GPT-4.5发布数小时后,OpenAI从其AI模型白皮书中删除了“GPT-4.5不是前沿AI模型”这一行。GPT-4.5的新白皮书不再包含该行内容。你可以在此处找到旧白皮书的链接。以下是原文。
OpenAI周四宣布推出备受期待的AI模型GPT-4.5(代号Orion)。作为OpenAI迄今为止规模最大的模型,GPT-4.5使用了比以往任何版本更多的计算能力和数据进行训练。尽管规模庞大,OpenAI在白皮书中明确表示,并不认为GPT-4.5属于前沿模型。
ChatGPT Pro订阅用户(月费200美元)即日起可作为研究预览版访问GPT-4.5;API开发者也可同步使用。注册ChatGPT Plus和Team的用户预计将于下周获得该模型。
业界高度关注Orion,将其视为传统AI训练方法可行性的风向标。GPT-4.5延续了与GPT-1至GPT-4相同的关键技术路线,即在无监督学习预训练阶段大幅增加算力与数据量。此前每次迭代均带来数学、写作及编程等跨领域性能的显著提升。OpenAI表示,GPT-4.5拥有“更深厚的世界知识”和“更高的情商”。然而,扩大规模带来的收益正趋于平缓。在多个AI基准测试中,GPT-4.5的表现不及DeepSeek、Anthropic以及OpenAI自身的新一代推理模型。
OpenAI承认运行GPT-4.5成本高昂,正在评估是否长期在API中提供该服务。目前,GPT-4.5 API定价为每百万输入令牌75美元、输出令牌150美元;相比之下,GPT-4o仅为输入2.50美元、输出10美元。
OpenAI在博文中表示:“我们将GPT-4.5作为研究预览版分享,以便更好地了解其优势和局限性。我们仍在探索它的能力,并期待看到人们以意想不到的方式使用它。”
表现参差不齐
OpenAI强调,GPT-4.5并非GPT-4o的直接替代品。虽然支持文件/图片上传及画布工具,但目前暂不支持逼真的双向语音模式等功能。
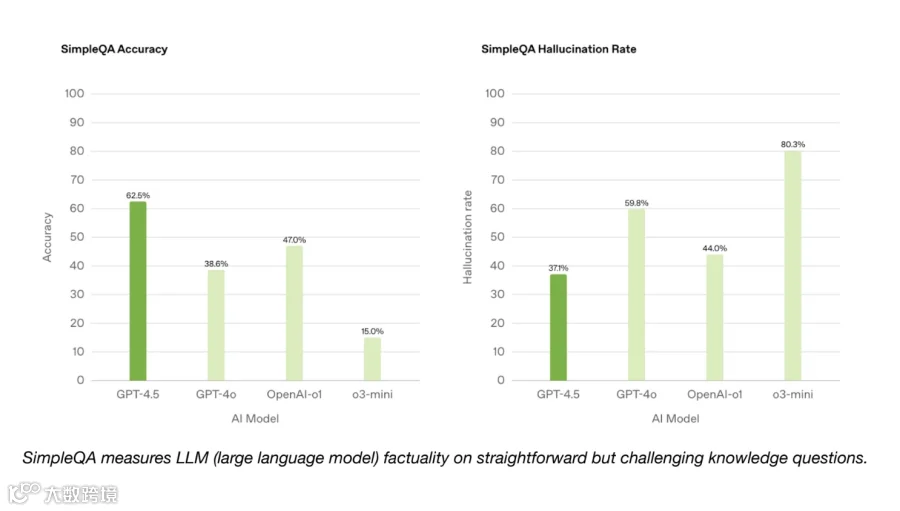
在积极方面,GPT-4.5性能优于GPT-4o及多数其他模型。在SimpleQA基准测试中,其准确性超越GPT-4o、o1及o3-mini,且幻觉频率更低。但需注意,OpenAI未将deep research纳入此测试对比;Perplexity的Deep Research模型在该事实准确性测试中优于GPT-4.5。
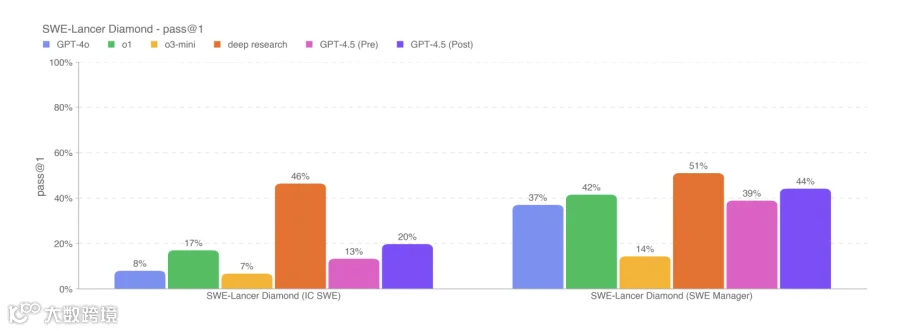
在SWE-Bench Verified编码测试中,GPT-4.5表现与GPT-4o、o3-mini相当,但不及深度研究和Claude 3.7 Sonnet。在衡量完整软件开发能力的SWE-Lancer测试中,GPT-4.5优于GPT-4o和o3-mini,但仍未能超越深度研究。

在AIME和GPQA等高难度学术基准测试中,GPT-4.5尚未达到o3-mini、DeepSeek R1及Claude 3.7 Sonnet等领先推理模型的水平,但在同类非推理模型中表现持平或更优,显示其在数理问题上具备良好基础。
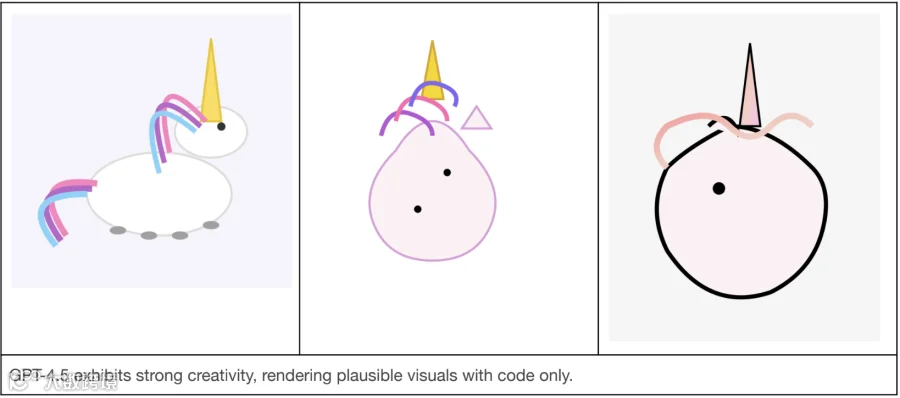
此外,OpenAI声称GPT-4.5在理解人类意图等基准测试难以捕捉的领域具有定性优势,语气更温暖自然,在写作和设计等创意任务中表现出色。例如在SVG生成独角兽测试中,仅GPT-4.5生成了准确形象;在回应情感困扰提示时,其社交得体性也优于GPT-4o和o3-mini。
OpenAI指出:“学术基准测试并不总能反映实际效用,我们期待通过此次发布更全面地了解GPT-4.5的能力。”

扩展定律受到挑战
OpenAI称GPT-4.5“处于无监督学习可能性的前沿”,但其局限性似乎也印证了专家推测:预训练中的“扩展定律”或将失效。联合创始人Ilya Sutskever曾表示“已达到数据峰值”,传统预训练方式面临终结。这呼应了行业对单纯扩大规模边际效益递减的担忧。
为应对瓶颈,包括OpenAI在内的全行业已转向推理模型。此类模型虽耗时更长,但通过增加“思考”时间和算力,能显著提升能力一致性。
OpenAI计划最终将GPT系列与“o”推理系列结合,并于今年晚些时候推出GPT-5。据报道,GPT-4.5训练成本极高、多次延期且未达内部预期,可能无法单独登顶AI基准测试,但很可能被视为迈向更强大系统的垫脚石。