


Cohere For AI是AI初创公司Cohere旗下的非营利研究实验室,本周发布了多模态“开放”AI模型Aya Vision,并宣称其处于行业领先地位。
Aya Vision核心功能与版本
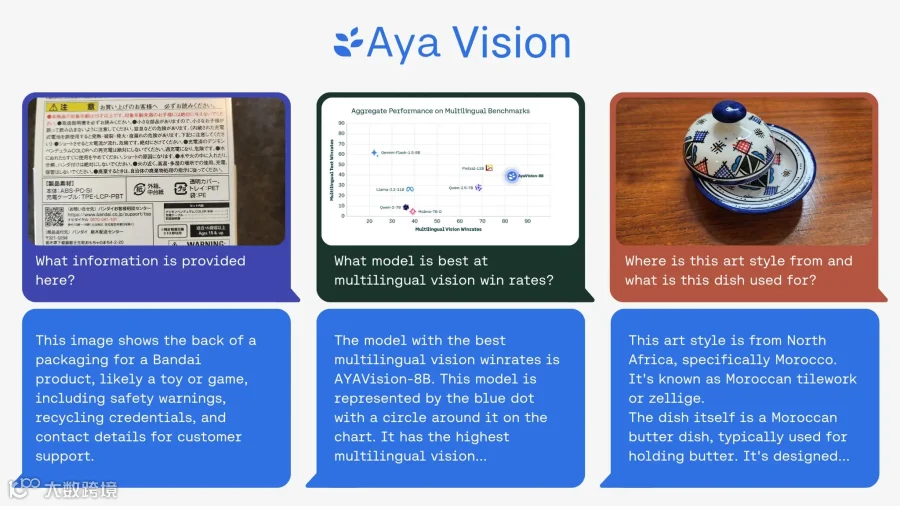
Aya Vision支持23种主要语言,可执行图像描述、照片问答、文本翻译及摘要生成等任务。Cohere还通过WhatsApp免费提供该模型,称这是“让全球研究人员接触技术突破的重要一步”。
Cohere在博客中指出:“尽管AI进展显著,但模型在不同语言上的表现仍存在巨大差距,这种差距在多模态任务中尤为明显。Aya Vision旨在明确缩小这一差距。”
Aya Vision提供两个版本:
- Aya Vision 32B:更为先进,在某些视觉理解基准测试中表现优于规模两倍的模型(包括Meta Llama-3.2 90B Vision),设定了“新前沿”。
- Aya Vision 8B:在部分评估中的得分优于规模十倍的模型。
两款模型均已在Hugging Face上线,采用Creative Commons 4.0许可证并附带可接受使用附录,不可用于商业应用。
合成数据训练策略
Aya Vision基于英语数据集的“多样化池”进行训练,实验室将数据翻译后用于创建合成标注(标签/标记)。这些标注有助于模型在训练中理解和解释数据,例如图像识别中的物体标记或场景描述标题。
利用AI生成的合成注释已成为行业趋势。随着现实世界数据源枯竭,包括OpenAI在内的竞争对手正越来越多地使用合成数据训练模型。据Gartner估计,去年AI和分析项目中60%的数据为合成创建。
Cohere表示,在合成标注上训练Aya Vision使其能以更少资源实现竞争性性能。官方强调:“这展示了我们对效率的关键关注,即用更少的计算资源做更多事,也能为计算资源有限的研究社区提供更大支持。”
推出AyaVisionBench基准测试套件
伴随Aya Vision发布的还有新基准测试套件AyaVisionBench,旨在探测模型在“视觉-语言”任务中的技能,如识别图像差异、截图转代码等。
当前AI行业面临“评估危机”,现有基准测试的综合得分与实际能力相关性较差。Cohere声称AyaVisionBench提供了“广泛且具有挑战性”的框架,用于评估模型的跨语言和多模态理解能力,以纠正这一问题。
Cohere研究人员在Hugging Face上表示:“该数据集作为在多语言和真实世界环境中评估视觉-语言模型的稳健基准,我们将此评估集提供给研究社区,以推动多语言多模态评估的发展。”