


周四,法国大型语言模型(LLM)开发商Mistral为处理复杂PDF文档的开发者推出了一项新API。Mistral OCR是一项光学字符识别(OCR)API,可将任何PDF转换为文本文件,从而便于AI模型进行数据摄入。
大型语言模型(LLMs)是 OpenAI 的 ChatGPT 等流行生成式 AI 工具的基础,它们在处理原始文本方面表现尤为出色。因此,希望构建自有 AI 工作流的公司深知,将数据以整洁格式存储和索引变得至关重要,以便这些数据能够被重复用于 AI 处理。
与大多数 OCR API 不同,Mistral OCR 是一个多模态 API,这意味着它能够检测到文本块中交织的插图和照片。该 OCR API 会为这些图形元素创建边界框,并将其包含在输出结果中。
Mistral OCR 的输出不仅仅是一大段纯文本;其输出采用 Markdown 格式,这是一种开发人员用来在纯文本文件中添加链接、标题和其他格式化元素的标记语法。
大型语言模型在很大程度上依赖 Markdown 来构建其训练数据集。同样地,当你使用 AI 助手(如 Mistral 的 Le Chat 或 OpenAI 的 ChatGPT)时,它们通常会生成 Markdown 以创建项目符号列表、添加链接或将某些元素加粗。助手应用会将 Markdown 输出无缝格式化为富文本输出。正因如此,随着生成式 AI 的蓬勃发展,原始文本和 Markdown 近年来变得愈发重要。
Mistral 联合创始人兼首席科学官 Guillaume Lample 表示:“多年来,各组织积累了大量文档,通常以 PDF 或幻灯片格式存在,而这些格式对大型语言模型(尤其是 RAG 系统)而言是不可访问的。借助 Mistral OCR,我们的客户现在可以将丰富且复杂的文档转换为所有语言的易读内容。”
他补充道:“这是推动 AI 助手在企业中广泛采用的关键一步,这些企业需要简化对其庞大内部文档的访问。”
Mistral OCR 可在 Mistral 自己的 API 平台上使用,也可通过其云合作伙伴(如 AWS、Azure、Google Cloud Vertex 等)获取。对于处理机密或敏感数据的企业,Mistral 还提供本地部署方案。
这家总部位于巴黎的 AI 公司表示,Mistral OCR 的性能优于 Google、Microsoft 和 OpenAI 的 API。该公司已使用包含数学表达式(LaTeX 格式)、高级布局或表格的复杂文档对其 OCR 模型进行了测试。此外,它在非英语文档上的表现预计也会更优。
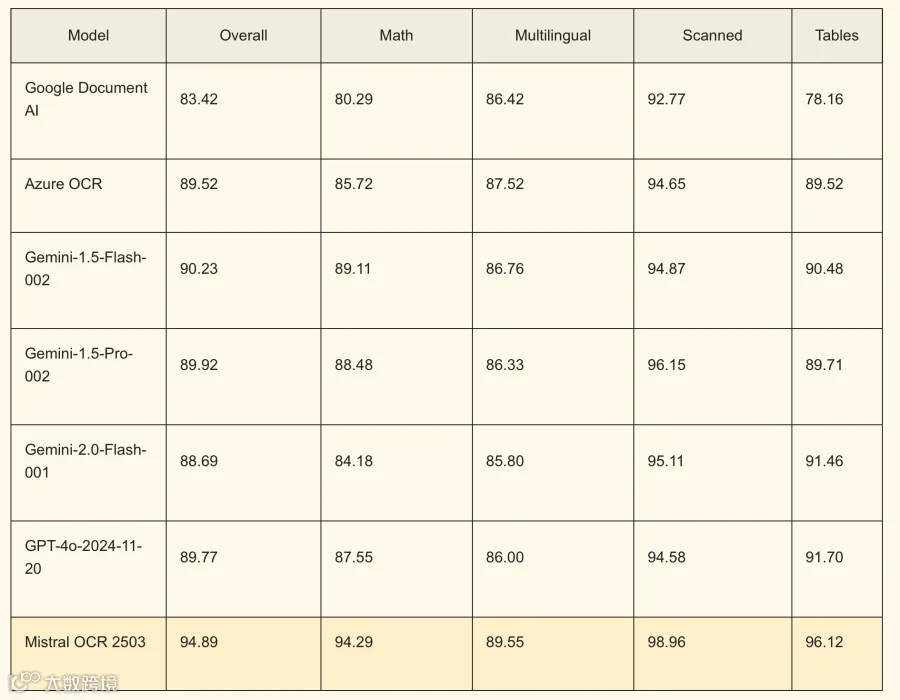
鉴于Mistral OCR仅专注于单一功能,该公司认为其速度也优于现有产品。如果将其与具备OCR功能(以及许多其他功能)的多模态大型语言模型如GPT-4o进行比较,这一点并不令人意外。
Mistral 还将其 Mistral OCR 用于其自身的 AI 助手 Le Chat。当用户上传 PDF 文件时,该公司会在后台使用 Mistral OCR 来理解文档内容,然后再对文本进行处理。
企业和开发人员很可能会将 Mistral OCR 与 RAG(即检索增强生成)系统结合使用,以多模态文档作为输入提供给大型语言模型。这有许多潜在的应用场景。例如,我们可以设想律师事务所利用它来帮助自己快速处理海量文档。
RAG 是一种用于检索数据并将其作为上下文与生成式 AI 模型结合使用的技术。