


随着传统AI基准测试技术被证明不足,AI开发者正转向更具创意的方式来评估生成式AI模型的能力。对其中一组开发者来说,那就是由微软拥有的沙盒建造游戏《我的世界》(Minecraft)。
Minecraft Benchmark(或称MC-Bench)网站是协作开发的,旨在让AI模型在直接对抗挑战中比拼能力,以响应提示并创作《我的世界》作品。用户可以投票选出表现更好的模型,而只有在投票后他们才能看到每个《我的世界》建筑是由哪个AI制作的。
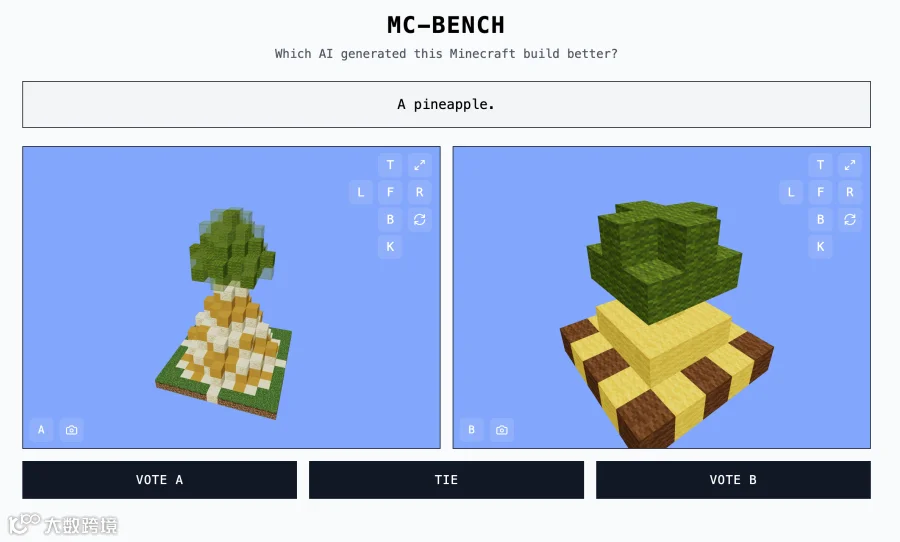
对于启动MC-Bench的12年级学生Adi Singh来说,《我的世界》的价值不在于游戏本身,而在于人们对其的熟悉程度——毕竟它是史上销量最高的电子游戏。即使没玩过这个游戏的人,也能判断出哪个方块风格的菠萝呈现得更出色。
“《我的世界》让人们能够更直观地看到(AI发展的)进展,”辛格表示。“人们已经习惯了《我的世界》,熟悉它的外观和氛围。”
根据MC-Bench网站的信息,目前该项目列出了八名志愿者贡献者。Anthropic、Google、OpenAI和Alibaba资助了该项目使用其产品服务来运行基准提示词,但这些公司与项目并无其他关联。
“目前我们只是进行简单的搭建,以反思我们从GPT-3时代至今取得的进步,但或许能将自己扩展到这些更长篇幅的计划以及目标导向的任务中,”辛格说。“游戏可能只是一种测试代理推理的媒介,相比现实生活更安全,且出于测试目的更具可控性,在我看来更为理想。”
其他游戏如Pokémon Red、Street Fighter和Pictionary也曾被用作AI的实验性基准测试,部分原因是AI基准测试的艺术向来以棘手难搞著称。
研究人员通常使用标准化评估来测试AI模型,但这些测试中的许多都给了AI主场优势。由于训练方式的原因,模型在某些狭窄类型的问题解决上天生具有优势,尤其是需要死记硬背或基本外推的问题解决。
简而言之,很难理解OpenAI的GPT-4能在LSAT考试中达到第88百分位,却无法辨别单词“strawberry”中有几个字母R意味着什么。Anthropic的Claude 3.7 Sonnet在标准化软件工程基准测试中取得了62.3%的准确率,但在玩Pokémon方面却不如大多数五岁儿童。
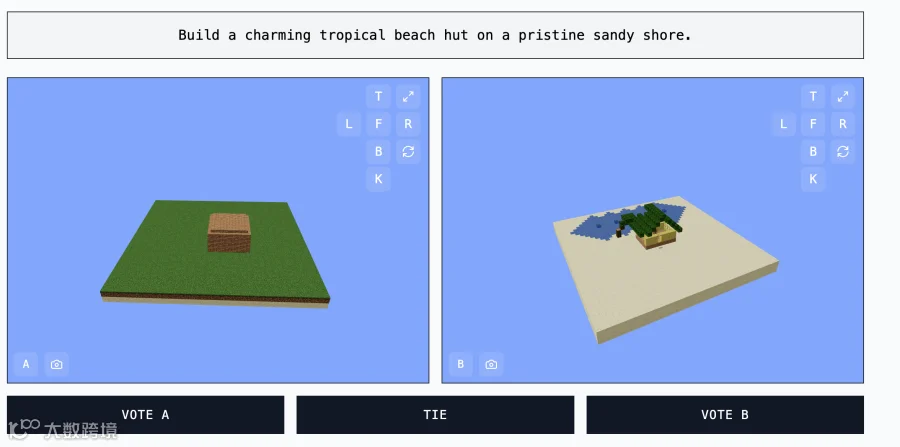
从技术上讲,MC-Bench是一个编程基准测试,因为模型被要求编写代码来创建指定的建筑,例如“雪人先生”或“位于纯净沙滩上的迷人热带海滩小屋”。
但对于大多数MC-Bench用户来说,评估一个雪人是否比另一个更好看,远比深入分析代码要容易,这使得该项目具有更广泛的吸引力——从而有可能收集到更多关于哪些模型 consistently 表现更好的数据。
当然,这些分数在多大程度上能反映AI的实际有用性仍有待商榷。不过,辛格认为它们是一个强有力的信号。
“当前的排行榜与我自己使用这些模型的经验非常吻合,这与许多纯文本基准测试不同,”辛格说。“也许[MC-Bench]可以帮助企业了解它们是否正朝着正确的方向发展。”