


著名AI研究员François Chollet联合创立的非营利组织Arc Prize Foundation周一宣布,推出一项名为ARC-AGI-2的新测试,旨在衡量领先AI模型的一般智能水平。
截至目前,该测试难倒了大多数主流模型。据Arc Prize排行榜数据显示,OpenAI o1-pro、DeepSeek R1等“推理”模型得分仅为1%至1.3%;GPT-4.5、Claude 3.7 Sonnet及Gemini 2.0 Flash等非推理模型得分也约为1%。
ARC-AGI测试由视觉谜题组成,要求AI从彩色方块中识别模式并生成答案网格,以考察其应对未知新问题的适应能力。基金会组织了超400人参与测试建立人类基准,平均正确率达60%,远高于当前任何AI模型。
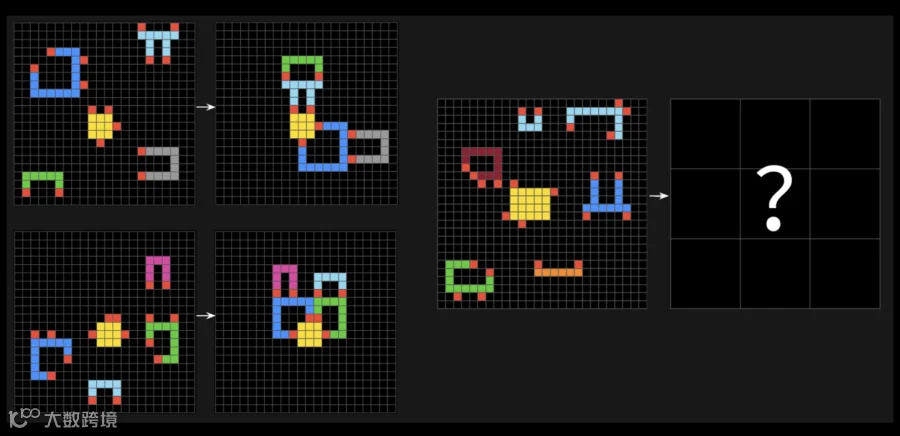
Chollet指出,相比第一版ARC-AGI-1,新版是衡量AI实际智能的更优指标,核心在于评估系统能否在训练数据外高效获取新技能。新测试引入了“效率”指标,防止模型依赖算力“蛮力”解题或记忆模式,要求其即时解释规律。
Arc Prize联合创始人Greg Kamradt强调:“智能不仅取决于解决问题的能力,更关乎能力获取与部署的效率。核心问题不仅是‘AI能否学会某项技能’,还包括‘以何种成本实现’。”
ARC-AGI-1曾保持五年未被超越,直至2024年12月OpenAI发布o3模型达到人类水平(75.7%)。然而,o3 (low)版本虽在旧测试表现优异,但在ARC-AGI-2上仅得4%,且单任务消耗高达200美元算力,凸显了性能提升背后的高昂成本。
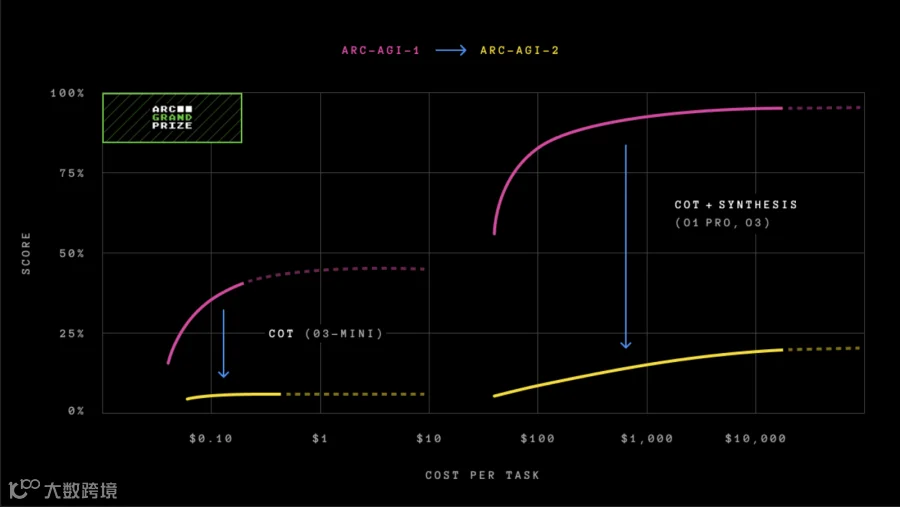
随着ARC-AGI-2发布,业界呼吁推出更多未饱和基准以全面衡量AI进步。Hugging Face联合创始人Thomas Wolf近期表示,行业缺乏评估创造力等AGI关键特征的有效测试。
与此同时,Arc Prize Foundation启动2025 Arc Prize竞赛,挑战开发者在单任务成本控制在0.42美元的前提下,于ARC-AGI-2测试中实现85%准确率。