


Midjourney 作为网络上最早的 AI 图像生成服务之一,发布了近一年来首个全新的 AI 图像模型 V7。
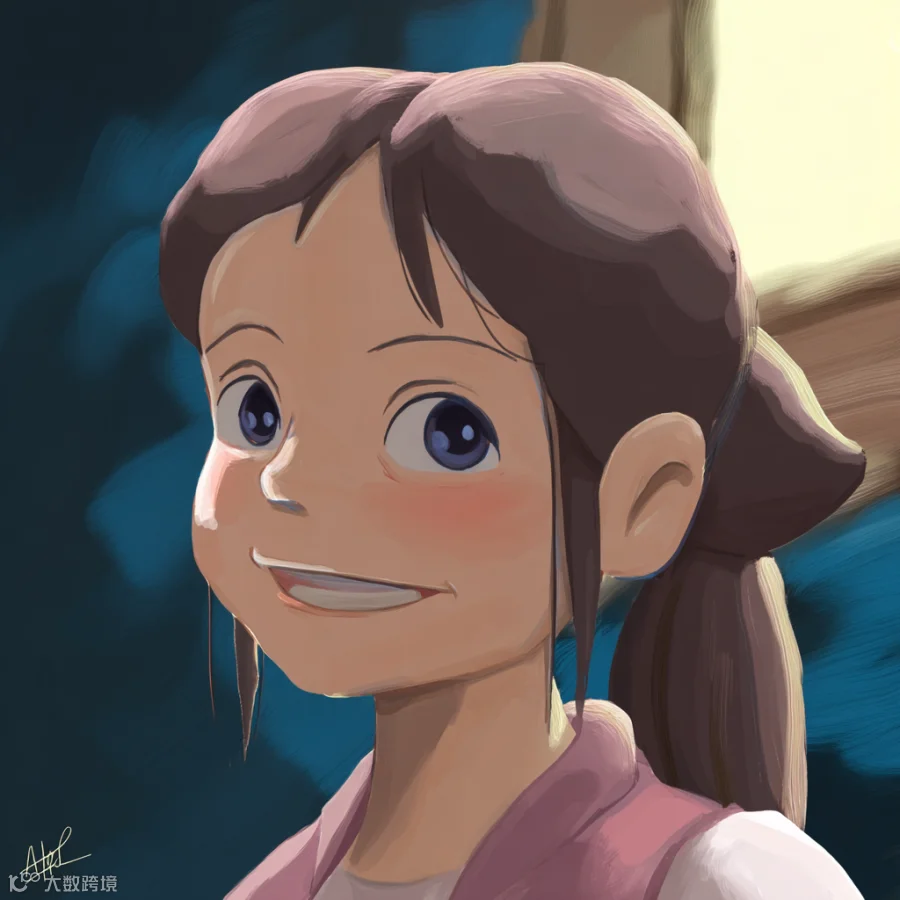
该模型于周四美东时间午夜左右以 Alpha 版本推出。此前一周,OpenAI 在 ChatGPT 中发布的新图像生成器因能创作吉卜力风格照片而迅速走红。虽然 Midjourney 官方并未宣称 V7 专门针对吉卜力风格优化,但在业余爱好者眼中,它依然能生成美观的作品。
我们现在开始新 V7 图像模型的 Alpha 测试阶段。这是迄今为止我们最智能、最精美、最连贯的模型。请尝试使用,并期待在未来两个月内每两周左右进行一次更新。
使用 V7 前,若尚未建立 Midjourney“个性化”配置文件,需先对约 200 张图片进行评分。该配置文件会根据个人视觉偏好调整模型,V7 也是 Midjourney 首个默认开启个性化功能的模型。
完成设置后,用户可在 Midjourney 网站或 Discord 聊天机器人上开启/关闭 V7。在网页应用中,可通过“Version”标签旁的下拉菜单快速选择。
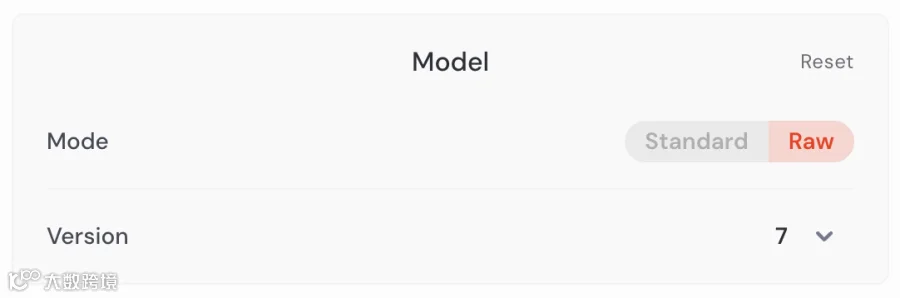
V7 核心特性与模式
Midjourney CEO David Holz 将 V7 描述为一种“完全不同的架构”。他表示:“V7 在文本提示方面更加智能,图像质量明显更高,纹理更精美,身体、手部和物体的细节连贯性也显著增强。”
V7 提供两种运行模式:高成本的 Turbo 模式和 Relax 模式。同时支持名为 Draft Mode 的新工具,其渲染速度是标准模式的 10 倍,成本减半。草稿图像画质虽低于标准模式,但可一键增强并重新渲染。
Holz 指出,目前 V7 暂不支持图像超分辨率放大和重纹理化等标准功能,预计将在未来两个月内推出。
“这是一个具有独特优势且可能有一些弱点的全新模型,”Holz 强调,“它可能需要不同风格的提示方式,建议用户多加尝试。”
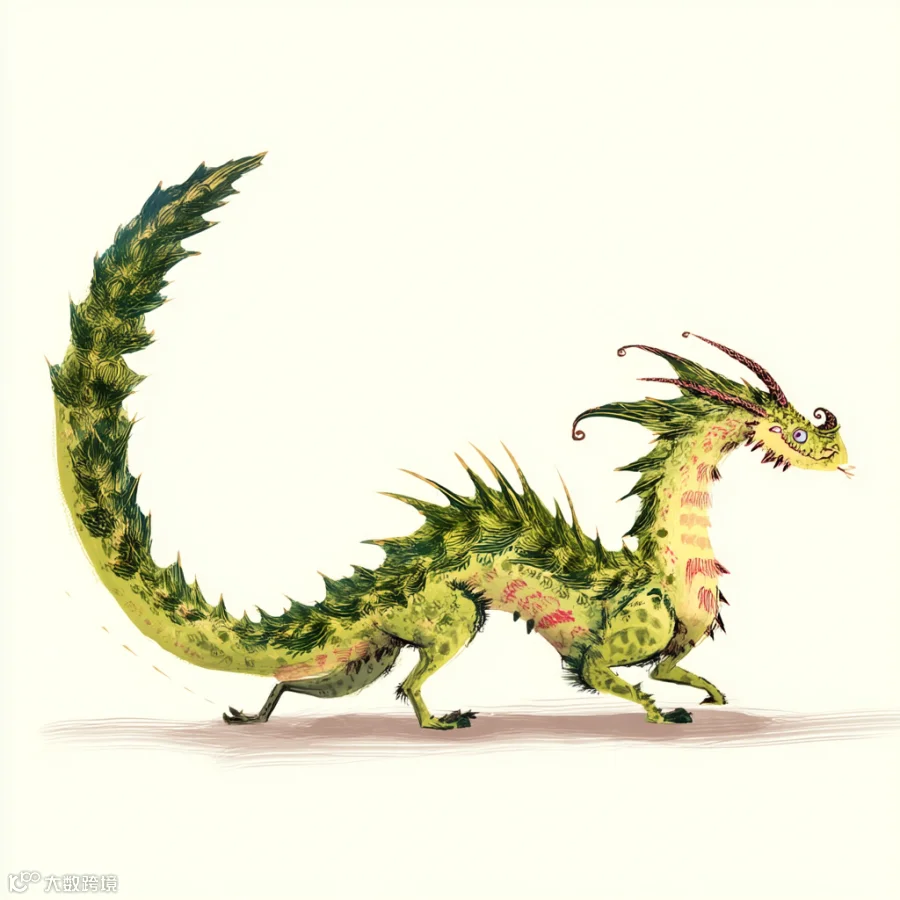
在短暂测试中,V7 对提示词的响应表现良好,尽管尚未进行彻底的压力测试。
公司现状与挑战
Midjourney 由 Leap Motion 联合创始人 David Holz 于 2022 年创立,是一家从未获得外部融资的非同寻常的公司。据报道,2023 年底其预计收入约为 2 亿美元。
近期,这家位于旧金山的公司表示正在组建硬件团队开展新项目,并将继续训练视频和 3D 对象生成模型。与此同时,该公司正面临多起诉讼,被指控未经同意利用网络抓取数据训练 AI 工具,侵犯了数百万艺术家的权利。