


新公司 Deep Cogito 正式推出系列可公开获取的 AI 模型,支持在“推理”与“非推理”模式间灵活切换。
以 OpenAI o1 为代表的推理模型虽能通过逐步解题实现自我事实核查,在数学、物理等领域表现优异,但也面临计算成本高、延迟大的问题。为此,Anthropic 等实验室正探索“混合”架构,将推理组件与标准非推理元素结合:简单问题快速响应,复杂查询深度思考。
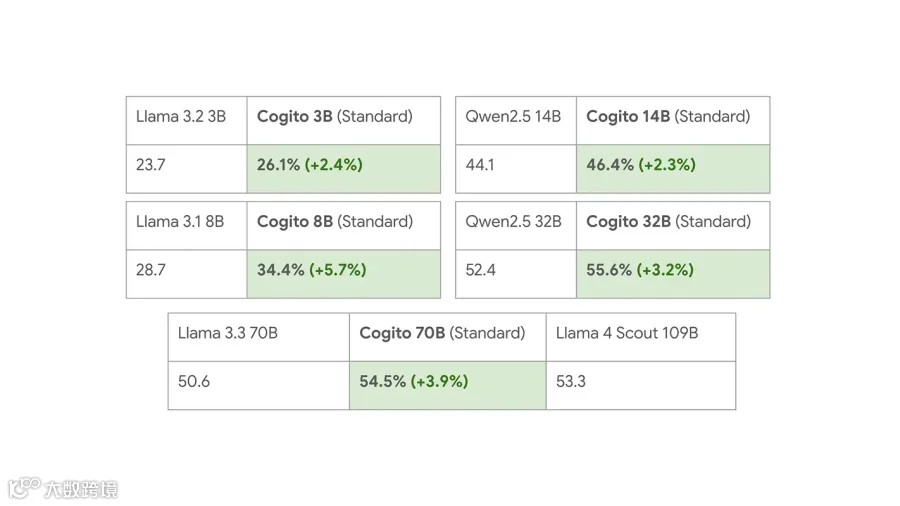
Deep Cogito 推出的 Cogito 1 系列即为混合模型。官方宣称其性能优于同规模最佳开源模型(含 Meta 及 DeepSeek 产品)。
据官方博客介绍:“每个模型既可直答,也可在回答前自我反思(类似推理模型)。所有模型均由小团队约 75 天开发完成。”
Cogito 1 参数量覆盖 30 亿至 700 亿,未来数周至数月内还将推出高达 6710 亿参数的版本。通常而言,参数量越大,模型解决问题能力越强。
需注意的是,Cogito 1 并非从零构建,而是基于 Meta Llama 和阿里 Qwen 等开源模型开发。Deep Cogito 通过创新训练方法提升基础模型性能,并实现了推理功能的可切换性。
内部基准测试显示:开启推理的最大版 Cogito 70B 在部分数学与语言评估中超越 DeepSeek R1;关闭推理后,该模型在通用测试平台 LiveBench 上亦优于 Meta 最新发布的 Llama 4 Scout。
目前,所有 Cogito 1 模型均可通过 Fireworks AI 和 Together AI 云平台 API 下载或使用。
官方博客指出:“我们仍处于扩展曲线早期,仅使用了传统大模型后训练/持续训练预留算力的一小部分。未来将研究用于自我提升的互补性后训练方法。”
备案文件显示,总部位于旧金山的 Deep Cogito 成立于 2024 年 6 月。联合创始人 Drishan Arora 曾任 Google 高级软件工程师,Dhruv Malhotra 曾在 Google DeepMind 担任生成式搜索产品经理。
投资方 South Park Commons 致力于构建“通用超级智能”。创始人将其定义为:能比多数人类更高效执行任务,并“揭示尚未想象到的全新能力”的 AI。