


来自 OpenAI、Anthropic 等顶级 AI 实验室的模型正日益辅助编程。谷歌 CEO Sundar Pichai 表示,其公司 25% 的新代码由 AI 生成;Meta CEO Mark Zuckerberg 也计划在其内部广泛部署 AI 编码模型。
然而,即便是当前顶尖模型,也难以解决那些不会困扰资深开发者的软件错误。
微软研究院一项新研究显示,包括 Anthropic Claude 3.7 Sonnet、OpenAI o3-mini 在内的多款模型,在 SWE-bench Lite 基准测试中调试表现不佳。这清醒地提醒我们:尽管 OpenAI 等公司声明大胆,但在编程领域,AI 仍无法媲美人类专家。
研究团队测试了九种模型作为“单提示智能体”基础架构,该智能体可访问 Python 调试器等多种工具。研究人员要求其解决 SWE-bench Lite 中精心挑选的 300 个调试任务。
结果显示,即便配备更强模型,智能体成功率也鲜少过半。Claude 3.7 Sonnet 平均成功率最高(48.4%),其次是 OpenAI o1(30.2%)和 o3-mini(22.1%)。
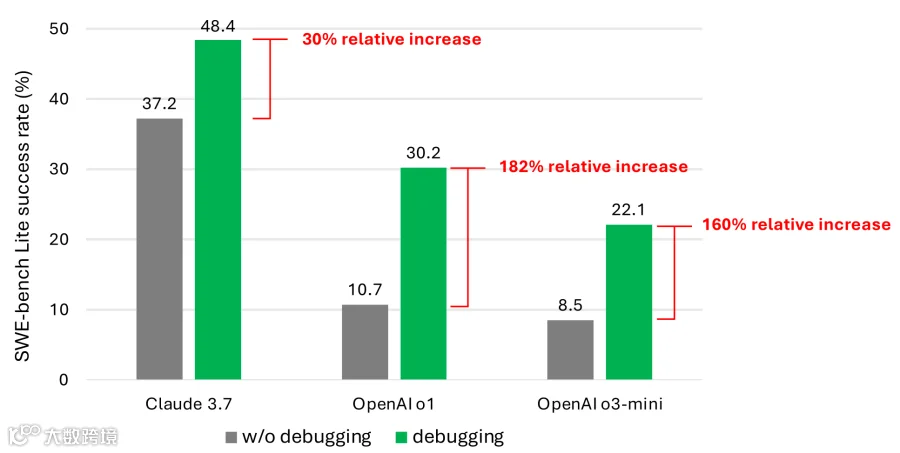
表现不佳的原因何在?部分模型难以有效使用调试工具,也不理解不同工具的适用场景。但作者认为核心问题在于数据稀缺:当前训练数据缺乏代表人类调试轨迹的“顺序决策过程”样本。
作者在研究中写道:“我们坚信,通过训练或微调可使模型成为更好的交互式调试器。但这需要专门数据,例如记录智能体与调试器交互以收集修复所需信息的轨迹数据。”
这些发现并不意外。多项研究表明,代码生成 AI 因逻辑理解薄弱,易引入安全漏洞和错误。近期对热门 AI 编码工具 Devin 的评估显示,其仅能完成 20 项编程测试中的 3 项。
但微软这项研究是对模型持续短板的一次详细审视。它或许不会削弱投资者对 AI 辅助编码工具的热情,但足以让开发者及其管理者在让 AI 主导编码工作时三思而行。
尽管如此,越来越多科技领袖质疑 AI 将完全取代编码工作的观点。微软联合创始人比尔·盖茨曾表示,编程作为一种职业将长期存在。Replit CEO Amjad Masad、Okta CEO Todd McKinnon 及 IBM CEO Arvind Krishna 也持相同看法。